内存去重曲线:Firecracker、Docker 与 pVisor
注:文中本地
.data/路径指向测量时的本地归档,未随仓库或站点发布,仅用于批次溯源。
Linux:去重速度、压缩与共享库预检
观察到的收益与代价
四实例各持相同 64 MiB 随机数据时,物理池约 1.7 秒起持续回收 128 MiB 计费内存,KSM 需约 27.8 秒;没有可共享业务页时,池占用 391.62 MiB 并消耗 8.1 CPU 秒扫描,收益不成立。 文件读取提示在共享库实验中提前了回收,DAX 则直接复用显式不可变文件的页。所有读数均为每格 N=1 的单次观察,不提供置信区间、稳定排名或生产密度结论。以下对照同时记录回收速度、CPU 和窗口末尾占用,用于分析不同路径的收益与成本。
2026-10-18 的两组完整预检分别包含 21 个静态内存条件和七个共享库条件,每格 N=1。全部 1,218/406 项内容、私有写入、独立退出校验以及资源、来源和原始数据审计通过。分析仅使用这两组完整预检;额外的部分重复测量不混入汇总。以下读数不提供置信区间、稳定排名或生产密度结论。
为什么同时测三种内容
重复且容易压缩的数据可以从压缩和共享中受益。跨实例相同的随机数据难以压缩,但可以共享物理页。各实例独有的随机数据则暴露基础运行开销和无效扫描成本。三者共同回答节省来自哪里,以及没有可共享业务页时要付出什么代价。
Agent 的短时工具调用使早期回收值得单独评估:一次性环境或频繁释放、改写的页可能等不到长扫描窗口。持久 VM 的库页则可能跨多次调用复用,工具时长与页面可共享寿命需要分别测量。以下曲线给出这类部署的机制依据,没有测量真实 Agent 的调用时长或吞吐。
同负载与统一观察窗口
Linux x86_64/KVM,Ryzen 7 9700X,内核 7.2.10-200.fc44.x86_64。每组四实例,各使用相同的 64 MiB 数据;VM 为 256 MiB RAM/1 vCPU,Docker 每容器限制为 256 MiB/一核配额。完整产品组包含 VM、池或独立 dockerd、containerd、shim 和连接客户端,统一使用四核配额、CPU 0–3、2 GiB 上限和零 swap。观察者在组外,全局 ksmd CPU 单列,宿主 KSM 参数保持不变。
静态实验使用同一静态 worker;共享库实验单独使用相同 Python userspace,实际 dlopen 同一份含 64 MiB 目标数据的 .so。输入预先准备,不驱逐全局缓存。原版 Firecracker 使用 virtio-blk,pVisor 普通 rootfs 使用 virtio-fs;Docker 共享宿主内核。这些产品差异保留,结果不能全部归因于 VMM 自身。
所有实例就绪后观察 60 秒,整组计费内存每 50 ms、进程 PSS 每 500 ms 采样。扫描可能在依次启动实例时已经开始。后续完整读回、私有写入与退出检查继续作为有效样本门禁。具体模式见去重与压缩的区别。本实验测量 pVisor 的 UKSM-inspired 实现,没有运行上游 UKSM 内核补丁。
静态工作集:空闲占用与回收速度
下表是四实例完整组在 60 秒时的计费内存,单位 MiB,每格一次观测。PSS 与计费内存分别绘制;共享缓存可能计费在组外,PSS 则不包含全部内核成本,两者均不能直接替代整机新增物理占用。
| 模式 | 重复内容 | 跨实例相同随机内容 | 各实例独有随机内容 |
|---|---|---|---|
| firecracker | 365.61 | 365.67 | 365.44 |
| docker-rootless | 423.99 | 423.99 | 424.10 |
| pvisor-off | 398.92 | 398.91 | 399.32 |
| pvisor-ksm | 114.22 | 177.33 | 368.89 |
| pvisor-physical | 149.14 | 222.61 | 391.62 |
| pvisor-compressed | 186.17 | 377.89 | 377.68 |
| pvisor-local | 117.46 | 373.48 | 373.75 |
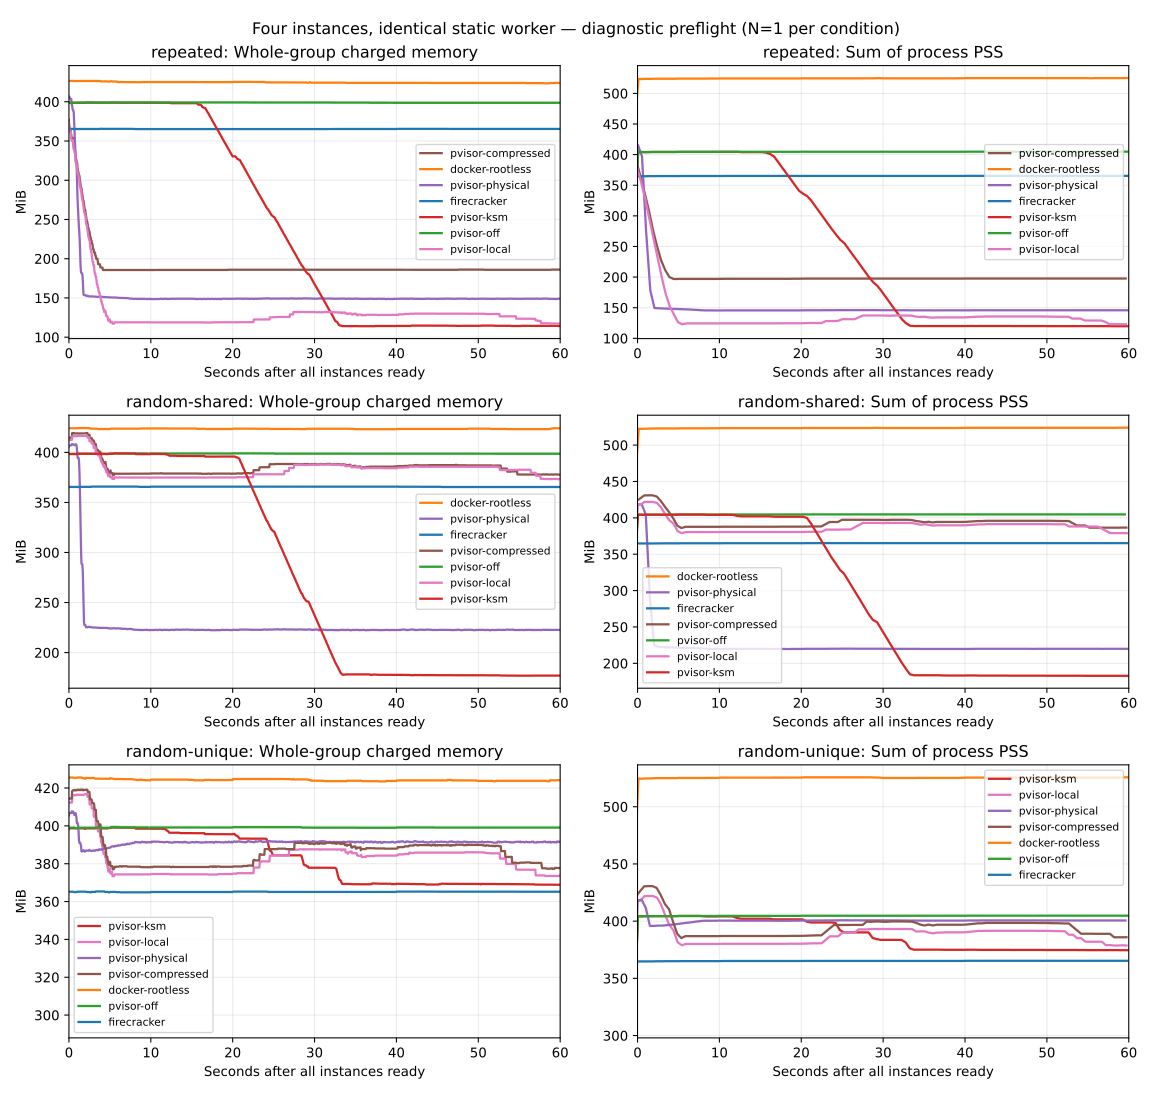
横轴是四实例全部就绪后的秒数,纵轴是整组 MiB,越低表示该口径的占用越少。左列为 cgroup 计费,右列为进程 PSS;三行分别是重复、相同随机和独有随机内容。曲线使用原始采样点,没有平滑或跨条件平均。
随机共享数据中,物理池持续减少 128 MiB 计费内存的采样区间为 1.688–1.739 秒,KSM 为 27.723–27.773 秒。时间从各自 all-ready 占用开始计算,表示持续到观察窗结束的采样下降,不能解释为精确收敛时间。60 秒累计组 CPU 分别为 5.924/0.384 秒,KSM 另有 0.41 秒全局 ksmd 成本,位于组配额之外且不能完全归因到本组。
随机独有数据中,Firecracker 为 365.44 MiB,pVisor off 为 399.32 MiB。差异包含客户机、设备和运行时开销;仅凭这组数据无法拆出纯 VMM 固定成本。物理池为 391.62 MiB,累计消耗 8.122 CPU 秒:无重复业务数据时,扫描收益较小。独立 Docker daemon 的开销已包含,不能外推到共享、摊销 daemon 的部署。
读回:共享保留与私有恢复
重复内容的完整读回读数如下。内存单位 MiB;时间覆盖四实例读回、逐字节及摘要校验和控制传输,不是纯解压耗时。
| 模式 | 读回前计费内存 | 读回后计费内存 | 首次完整读回 ms |
|---|---|---|---|
| pvisor-off | 398.92 | 399.09 | 621.99 |
| pvisor-local | 117.46 | 374.58 | 1157.44 |
| pvisor-compressed | 186.17 | 419.73 | 1099.13 |
| pvisor-physical | 149.14 | 149.10 | 839.57 |
物理池不压缩数据,读回继续使用共享映射。压缩路径恢复私有 RAM,导致占用回升;它们还改变块大小、准入和 IPC,不能将全部差异归给 codec。当前压缩池要求单个 64 KiB 块达到压缩收益门槛,独立双会话随机块诊断确认了这一限制:相同随机块的两次提交均因收益不足被拒绝,池对象数为零。
共享库:文件提示与 DAX
以下为单独的七条件库负载,每格 N=1,单位 MiB。物理池 hints off/on 使用同一二进制,核验每个进程的实际提示设置。显式 DAX 保持普通 RAM 去重关闭;其共享来自同一不可变文件 backing,无需扫描目标文件页。
| 库加载路径 | 2 秒组计费 | 60 秒组计费 | 60 秒进程 PSS |
|---|---|---|---|
| firecracker-block | 440.93 | 441.57 | 441.08 |
| docker-rootless-library | 274.27 | 273.28 | 369.90 |
| pvisor-rootfs-off | 475.22 | 475.73 | 481.25 |
| pvisor-rootfs-ksm | 475.10 | 207.12 | 212.65 |
| pvisor-rootfs-physical-no-hints | 348.43 | 259.02 | 252.46 |
| pvisor-rootfs-physical-hints | 304.89 | 256.52 | 252.94 |
| pvisor-dax | 228.93 | 229.02 | 298.10 |
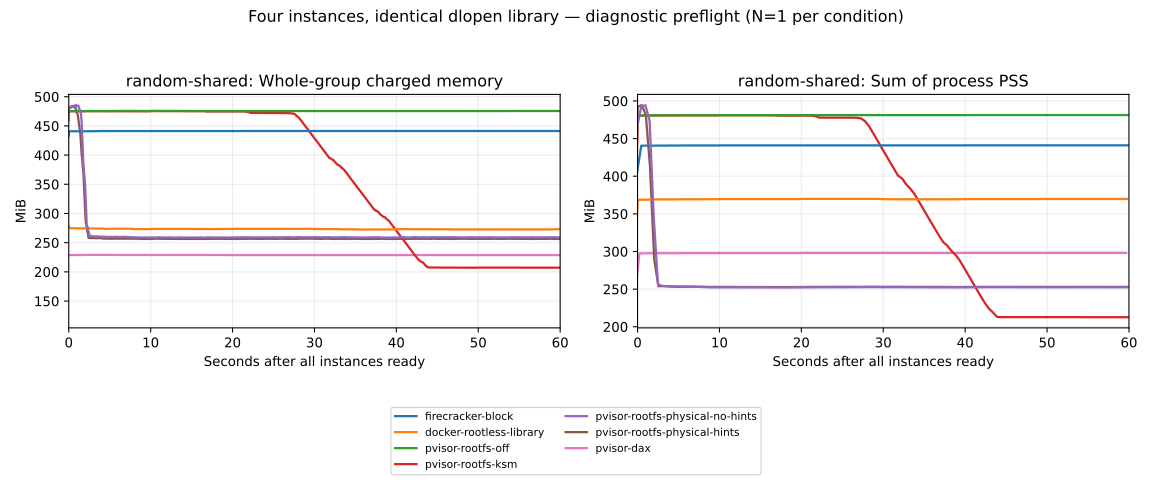
横轴仍从全部就绪计时;0 秒时已经发生的共享保留在起始占用中。比较前几秒的下降可以观察文件提示的作用,60 秒读数用于比较观察窗末尾的占用。
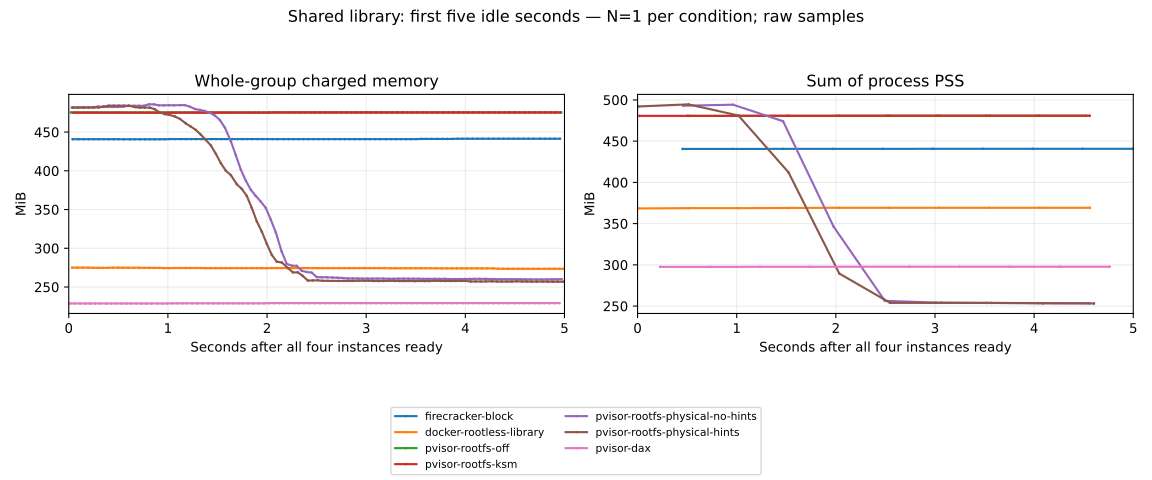
前五秒放大图保留全部七个条件及原始采样点,便于查看提示开启/关闭的早期差异。PSS 采样比计费内存稀疏,不插值推断精确合并时刻。
文件提示开启时,2 秒组计费为 304.89 MiB,关闭时为 348.43 MiB;60 秒时分别为 256.52/259.02 MiB,PSS 接近。累计组 CPU 分别为 7.552/7.710 秒。这些单次观察尚不能证明重复测量中的 CPU 改善。
读回后,提示开启、关闭以及 DAX 都验证了四 VM 共享全部 16,384 个目标页(64 MiB);证据包含完整目标字节和前后 present-file PTE、backing 身份与偏移。Docker 验证四个 OverlayFS 视图各自的目标页及 smaps,跨视图同槽数量保留为不可用。目标页共享证明与整组节约分别报告:物理池还扫描其他客户机内存,DAX 只共享显式挂载的文件页,整组差值不能全部归因于 .so。
从观察到算法判断
| 观察 | 机制解释 | 尚不能推出的结论 |
|---|---|---|
| 相同随机内容经物理池回收,读回仍保持共享 | 4 KiB 原文页共享不要求内容可压缩 | 全部收益均来自业务页,或纯扫描算法更快 |
| 压缩池拒绝相同的难压缩随机块 | 64 KiB 块先通过压缩收益门槛,限制了这类重复数据的准入 | codec 占全部 CPU 成本的比例 |
| 文件提示开启时,早期占用下降较早,60 秒 PSS 接近 | 成功的文件读取提供候选顺序,后台扫描仍能发现相同页 | 最终共享量或 CPU 成本有稳定改善 |
| 显式 DAX 在起始读数中已有共享 | 相同不可变 backing 与偏移可直接复用文件页 | 普通 mutable rootfs 的所有库都自动共享 |
随机共享负载中,物理池约 1.7 秒达到持续减少 128 MiB 的目标,KSM 约 27.8 秒达到目标,并在 60 秒时取得更低的占用和 CPU 读数。短时页面的评估重点是早期回收,长期保留页面还需考察持续成本。两种时间尺度都应结合实际页面寿命分析;这些单次观测尚不能建立纯算法速度、亚秒级工具吞吐或稳定 CPU 改善的结论。
完整来源与复现步骤保留在 memory 实验记录。本地原始证据为 benchmark/memory/.data/q8/ 和 l4/,对应审计报告 SHA-256 分别为 05958d9ca694f8aa63e81d2bce4a97ee7ad575d7dd19ed3279be91ceced03d8a、dfbf4fb91ea2613601bf2217dd08ddb55885591d3e1ec5c805da07b954c18f2f。预检与正式样本分开保存,失败条件不补入成功批次;原始写入后记录仍完整保留。