文件系统性能:技术分析与实验记录
历史批次按各自固定的源码、制品与计时口径解释;当前活动实验和准备状态见 benchmark 注册表。
注:文中「本地原始记录」及
docs/src/assets/benchmarks/.data/、benchmark/.data/等路径指向测量时的本地归档,未随仓库或站点发布,仅用于批次溯源。
当前结论与测量覆盖
最新独立 N30 配对对照下,当前默认配置相对同批基线:启动至正常退出 -1.73%(95% CI [-5.70, -0.22]),写入 256 文件 -14.19%([-17.58, -9.82])。历史文件系统退化尚未整体修复;新建 VM 写合并与 DAX 均默认关闭,下文各批次的百分比来自各自冻结基线,不能累加。
各批次的测量覆盖与结论如下。
文件系统 I/O 曲线系统比较请求粒度、并发、同步、容量与复用工作集;独立 N30 和普通 CLI 对照未支持默认开启 host-owned 异步合批,请求计数解释了 backing 合并与 FUSE WRITE 数量的区别。
2026-10-17 的guest 内核写回后续修复了关闭后 unlink/rename 再 syncfs 的对象生命周期问题,并用真实延迟 backing 验证跨批流水推进。本页历史批次中“ENOENT 未修复”指各自当时的冻结版本,旧时间、失败与结论保持原状;后续 SDK 修复不构成新的普通 CLI WB=1 性能验收。
普通 CLI 的限定只读 FLUSH 自动请求在认证 prepared rootfs/workspace 下,将三轮七工具累计降低7.26%,95% CI [2.25%, 15.51%],五对均改善;rg三轮改善约16%–17%,Ready与npm未检出差异。Linux x86_64的合格fresh native入口在宿主变量缺省时自动请求,显式0及旧peer/不合格fd保留原FLUSH;DATA、NE、WB、DAX不自动开启。
普通 CLI 的标准负项 entry 对照在DATA0/FLUSH1下未检出整体收益:三轮七工具累计降幅1.73%,95% CI [-3.45%, 5.26%];第三轮npm改善12.27%,hot_open慢2.50%。查询减少已确认,NE继续默认关闭。
普通 CLI 的 DATA/只读 FLUSH 四臂对照在固定 prepared rootfs/workspace 与 frozen baseline 下,组合将三轮七工具累计降低9.54%,95% CI [3.83%, 13.31%];FLUSH单项下降8.86%,在其基础上增加DATA的整体收益未检出。rg 三轮均有改善信号,metadata/Ready 也有局部退化;DATA仍默认关闭,只读FLUSH已接入限定prepared-rootfs入口,通用VM worker仍默认关闭。
普通 CLI 的封存工作区入口在两组均使用 prepared rootfs 时,将三轮七工具累计降低 5.21%,95% CI [0.44%, 10.91%],五对均改善;Ready 未检出差异。工作区所有权/缓存资格与 frozen-baseline 读观察/journal 语义联合变化;第三轮 git 下降 73.74%,第二轮 stream_write 慢 5.05%,不能与其他独立批次叠加收益。
普通 CLI 的 prepared-rootfs 入口在相同封存物理 rootfs、live Mutable 工作区下,将三轮七工具累计降低 18.11%,95% CI [2.00%, 31.90%],Ready 降低 3.26%。五对环境均改善;处理同时改变所有权/缓存资格和 checkpoint 能力准入,准备成本不含在时钟内,不能单归因 cache 或外推任意 live rootfs。
同次 OPEN 资格证据复用将受测四类资格查询尝试减少 57.14%,但未检出三轮七工具累计、Ready 或 npm/rg 的改善;候选继续默认关闭。
标准负项 entry 缓存在第三轮 npm 出现 13.08% 的改善信号;三轮七工具累计下降 3.32%,区间跨零,未检出整体收益。独立计数确认 rootfs 三轮 LOOKUP 降低 40.26%,候选继续默认关闭。该开启组合尚无普通 CLI 正式性能样本;另见关闭新实验机制的prepared-rootfs CLI 对照。
数据页缓存与只读 FLUSH 的同批四臂对照支持组合对 rg 三轮约 36% 的改善信号,相对任一单项也有信号;三项主要累计对照均未检出差异,样本存在分离和慢值;该批SDK入口的两项默认均关闭,当前限定prepared-rootfs入口见自动FLUSH请求。
Immutable lower 独立数据页缓存消除了受测 lower/upper 页混读并将第三轮 workspace READ 降低 88.83%;rg 三轮有约 17% 的改善信号,但三轮七工具累计未检出整体收益,该批未覆盖普通 CLI,继续默认关闭。
只读本地 FLUSH 消除在 rg 三轮出现约 17% 的改善信号;三轮七工具累计区间仍跨零;通用VM worker仍默认关闭,限定prepared-rootfs入口已接通自动请求。
独占 upper 物理不存在缓存将第三轮 rootfs 物理查询降低 71.47%,但三轮七工具累计未检出收益,rg 有退化信号,继续默认关闭。
属性 TTL 候选被拒绝与页缓存对象隔离:候选新增 hardlink nlink 陈旧,已撤除且无正式性能样本;整页探针同时确认既有 lower/upper 页缓存隔离问题。
2026-10-16 的Ready 与三轮驻留任务对照:九个配置各五个独立环境、每环境三轮,45 个环境全部通过,无干扰门禁;只以 Ready 报告启动,工具分轮计时不含退出。它与以下历史 N30 及工程 A/B 独立统计。
封存输入四组工程对照支持 rootfs 缓存资格带来的驻留工具收益:第三轮七工具合计下降 25.80%,同时启用工作区快照下降 19.83%;工作区单独处理在第三轮合计未检出差异。该工程入口省略 CLI Host 服务,结果不改写普通 CLI 用户表。
Immutable lower 负项缓存对照将第三轮 rootfs 物理查询减少 20.47%,但三轮七工具累计耗时未检出差异,负项缓存仍默认关闭。
目录 FD 缓存扩容与 ATIME 诊断未检出三轮七工具累计耗时的改善,默认容量保留 256。独立请求掩码探针确认:首次宿主 READ 后,请求 ATIME 的 stat 会补充 GETATTR;同 fd 页缓存命中后未出现该请求。
最新独立 N30 配对对照(即本节首句所引批次,详情):所选 C3(新 VM 写合并默认关):启动至正常退出变化 -1.73%,95% CI [-5.70, -0.22]%;写入 256 文件变化 -14.19%,95% CI [-17.58, -9.82]%。结果归因于该次代码与默认配置组合,未建立全面恢复历史性能的结论。
独立批次详见Linux:文件系统优化与写合并默认关闭的 N30 配对对照。以下已有汇总保留各历史批次的结论。
历史工程结论:
文件系统退化尚未得到整体修复。 直接队列服务的小样本复测支持部分工具改善,整体任务仍未检出差异;关闭写合并能减少写入成本,但没有检出完整七工具任务加速。DAX 保留显式启用入口,默认关闭,其首次 mmap 与重复小文件读取有明确退化。
下表分别引用各自批次的同条件对照,不能累加百分比或比较跨批次绝对时间。变化为候选相对该批基线,负值表示耗时下降;区间为 95% 配对 bootstrap 百分比区间。直接队列每臂 N=10,其余每臂 N=30;全部为工程结果。
| 对照 / 指标 | 每臂 N | 基线 ms | 候选 ms | 变化 | 95% CI % | 结论 |
|---|---|---|---|---|---|---|
| staged 空闲调度:完整任务 | 30 | 1826.42 | 1774.15 | -2.86% | [-3.57, -1.22] | 更快 |
| VM worker 修复:完整任务 | 30 | 4741.87 | 4592.36 | -3.15% | [-6.14, -1.23] | 更快 |
| VM 并发重构:内部总耗时 | 30 | 3578.18 | 3749.07 | +4.78% | [+2.96, +5.92] | 更慢 |
| VM 直接队列:内部总耗时 | 10 | 3707.29 | 3606.71 | -2.71% | [-5.28, +7.25] | 未检出差异 |
| 关闭写合并:写入 | 30 | 162.10 | 131.61 | -18.81% | [-25.06, -12.87] | 更快 |
| 开启 DAX:顺序重复读取 | 30 | 5.54 | 4.58 | -17.38% | [-21.40, -10.10] | 更快 |
| 开启 DAX:双线程首次读取 | 30 | 54.43 | 38.27 | -29.69% | [-32.16, -28.25] | 更快 |
| 开启 DAX:首次 mmap 页遍历 | 30 | 23.83 | 104.75 | +339.59% | [+328.77, +352.40] | 更慢 |
| 开启 DAX:小文件重复读取 | 30 | 25.37 | 36.63 | +44.37% | [+36.47, +47.98] | 更慢 |
普通 rootfs/workspace 默认不创建 DAX 窗口;不可变 share 保留显式 DAX 配置。新建 VM 写合并默认关闭,PVISOR_VM_FS_WRITEBACK=1 / 0 可显式配置;默认恢复已协商快照时保留原模式,显式 PVISOR_VM_FS_WRITEBACK=0 会拒绝已开启写合并的快照;stage 同步默认串行。历史工程表的制品与条件保留,不将其百分比累加或折算成当前用户批次的收益。
2026-10-12 所选冻结源码/默认配置已完成跨运行时七工具复测:八个后端各 30 次,共 240 个有效任务,DAX 关闭、新 VM 写合并默认关闭,见本地历史 N30 统计。新用户数据来自独立 fo5a4e7d2b-f 批次,不与历史合并,也不计算跨批次因果加速。旧有效与拒绝批次继续分别保留,见本地验收范围 CSV。
macOS 的复制期间响应性与 journal 锁、Linux HOST 的不可变 lower 缓存各有独立有效实验;扩展内核缓存只有正确性和请求计数通过,正式时间未验收。冷磁盘、大型仓库和并发吞吐没有匹配的新测量。本地工程结论索引 CSV 保留表格的批次、指标、来源和完整精度。
Linux:普通 CLI 的限定只读 FLUSH 自动请求
在相同 prepared rootfs/workspace 与 frozen baseline 下,宿主变量缺省、由 native child 自动请求只读 FLUSH 消除,将三轮七工具累计从4489.439降至4163.340 ms,降幅7.26%,95% CI [2.25%, 15.51%]。 五对环境均改善,rg三轮均有约16%–17%的改善信号;Ready、npm三轮及第二、三轮七工具合计均未检出差异。
相同制品与真实缺省环境
2026-10-17,B-FS-ENG 使用同一新构建的实际 CLI release、原0047固件,以及经 catalog 认证并持 lease 的既有 prepared rootfs/workspace;workspace保持 frozen baseline,live apply target独立。既有 prepared generation 未重新导入或封存;每环境独立目标与缓存按原负载准备。不引入旧样本或叠加历史收益;新制品构建、原准备费用与本次运行计时分别保留收据。
两臂均为Linux x86_64/KVM上的真实 pvisor run、fresh私有Host与native VM。off显式设置 PVISOR_VM_FS_READONLY_FLUSH_ELISION=0;auto在实际worker和传给CLI Popen 的环境中均没有此键,由产品在认证 prepared-rootfs selector、匹配owner/root、最终Immutable lower及fresh无capture/restore状态后,仅为native child补入1。计数另验每挂载requested/enabled,不能以期望配置代替实际环境。
guest 2 vCPU/16 GiB;整父组CPU0/1、两核quota、16 GiB、swap0。DATA、NE、SQ、两项Core缺项缓存、WB、DAX均0,guest cache=1、目录FD容量256。五个配对环境块随机交替,每环境九操作、三轮驻留任务;10/10正式、2/2预检、2/2独立计数全部通过。新release有29项runtime合同、7项harness合同通过,46份采集输入与740份产品来源经收据绑定。
Ready包含fresh Host+VM启动并排除退出;工具沿用原worker时钟,stream_write保留自身fsync/close。唯一Ready/Result、正常退出、terminal Job/Bundle、selectors/baseline receipt、lower与缓存隔离、256写文件和三个stream文件的完整字节校验保留。无额外预热、安静期、干扰或每轮全量清单门禁,全部有效慢样本保留。
正式耗时与分布
主要指标只有逐环境三轮七工具累计。5000次配对bootstrap按五个独立环境块抽样,三轮不是15个独立样本;32个95%区间未校正多重比较。下表为每臂N=5的中位数,正降幅表示耗时减少。
| 指标 | off ms | auto ms | 降幅 | 95% CI % | 结论 |
|---|---|---|---|---|---|
| 三轮七工具累计 | 4489.439 | 4163.340 | 7.26% | [2.25, 15.51] | 唯一主要指标;改善 |
| Ready | 826.914 | 821.821 | 0.62% | [-0.32, 14.10] | 未检出 |
| 第一轮七工具 | 2164.014 | 2007.672 | 7.22% | [3.90, 12.96] | 未校正改善信号 |
| 第二轮七工具 | 1113.353 | 1035.975 | 6.95% | [-2.04, 19.07] | 未检出 |
| 第三轮七工具 | 1063.282 | 1026.175 | 3.49% | [-4.56, 25.84] | 未检出 |
| 第一轮rg | 311.544 | 258.499 | 17.03% | [15.79, 17.77] | 未校正改善信号 |
| 第二轮rg | 303.683 | 251.471 | 17.19% | [9.75, 18.85] | 未校正改善信号 |
| 第三轮rg | 301.652 | 252.247 | 16.38% | [11.09, 18.22] | 未校正改善信号 |
其余改善信号为第一/三轮git:23.56% [12.00%, 28.00%]、14.15% [8.41%, 29.65%],第一轮hot_open:1.50% [0.10%, 2.51%],以及第一轮stream_write:4.16% [3.32%, 10.88%]。32项中没有区间完全落在退化侧;其余23项未检出差异,包括npm三轮、metadata三轮及write三轮。stream_write的单轮信号不证明写屏障提速或持久化语义改变。
累计五对原值(ms,同pair顺序)为off [4574.077387,4489.657213,4271.683726,4266.578114,4489.439478],auto [3864.449358,3996.902372,4170.722363,4170.459189,4163.340428]。64组完整五值向量均保留;N=5与该区间不构成稳定工作负载保证或尾延迟结论。
write存在明显观察间隙。仅为描述、以120 ms分组,第二轮off较低2/5(中位88.163 ms)、较高3/5(156.564);auto较低4/5(78.897)、较高1/5(142.706)。第三轮off较低3/5(78.849)、较高2/5(155.293);auto较低3/5(90.097)、较高2/5(152.492)。这是探索性描述,不是预登记模型、剔除条件或原因归因;不能把第二轮write的45.21%中位数点估计写成已确认收益。
off Ready保留956.412 ms的慢值,其余四个821.542–829.375 ms;auto为819.801–826.299 ms。metadata分布也较宽,第三轮off96.469–147.020 ms、auto76.363–138.723 ms,未检出差异。所有慢值均保留,不据小样本假设稳定分簇。
独立计数确认FLUSH覆盖及新增成本
每臂N1均有13个注册实例、每实例恰一个final;每挂载54个同步token、全环境216个组件区间。两臂共26实例、216帧、432区间。实际worker/CLI环境证明off为显式0、auto为缺省;rootfs/workspace的FLUSH requested/enabled分别0/0与1/1,DATA/NE及其对象/回复计数显式为0。
| 第三轮七工具 / 挂载 | OPEN off→auto | READ | FLUSH | RELEASE |
|---|---|---|---|---|
| rootfs | 1052→1052 | 0→0 | 1028→0 | 1052→1052 |
| workspace | 2681→2681 | 2480→2480 | 2681→542 | 2682→2682 |
第一/二轮rootfs FLUSH为1160/1028→0/0,workspace为4785/2681→563/542;三轮七工具的OPEN、READ、RELEASE均保持。rg workspace每轮FLUSH2051→1,OPEN/READ/RELEASE各2051不变;npm rootfs每轮FLUSH731→0、OPEN/RELEASE736不变,READ774/0/0保持。只读FLUSH消除没有消除这些OPEN或重复数据读取。
整个挂载实例生命周期的实际marked OPEN为rootfs3680、workspace8501;off均0。auto额外产生四类native资格查询尝试36543次:F_GETFL、fstat、fstatfs各12181,statx0;其中rootfs11040、workspace25503。七工具三轮区间内为35412次,不能与whole数混用。Core父叶查询和这四类调用分列,分类计数与inclusive spans不加入查询总数,也不能据计数推时间份额或磁盘I/O。
其他N1调用形状并非完全相同:第三轮rg workspace GETATTR237→3、Core13721→12323,而npm rootfs GETATTR383→396、Core20013→20063;不能把这些差异认定为FLUSH直接消除。metadata workspace第二/三轮GETATTR2050保持,stream_write每轮WRITE8192、FSYNC1、FLUSH3保持。native主compact journal的append345、transaction1276、refresh1277、sync8两臂相同;初始化owner另有相同refresh/sync。任务区间与实例整个生命周期分开保留,profile时钟不进入正式样本。
自动请求的边界
产品仅在Linux x86_64、认证prepared rootfs且owner/root/final lower精确匹配的fresh native入口、调用者未指定变量时自动请求。显式0保留旧行为;旧guest或不合格fd保留backend FLUSH,guest原写同步与错误检查保留。未选择并认证prepared rootfs的SDK调用(包括仅有 with_rootfs_base owner)和macOS的缺省行为不变;capture/restore仍按原来源合同拒绝。DATA、NE、SQ、Core缓存、WB、DAX不由此默认开启。
未变化的VM/0047机制可复用已有SDK的旧lower fd/整页copy-up、mmap/close、ATIME及旧peer证据;这些不是新CLI语义矩阵的重跑。既有fstat对象语义、copy_file_range边界仍未修复;short-read的19项C程序证据不等于完整内核故障注入。该结果支持限定入口的只读FLUSH默认接入,不扩大到任意SDK、live lower、长TTL或写回策略。
耗时摘要、全部32项比较、耗时来源保留全部原值;逐工具计数、实例生命周期、计数来源保留独立N1与实际caller证据。原始报告、新制品与原准备费用关联保存在本地 benchmark/.data/af17-cli/,不与旧批次合并。
Linux:普通 CLI 的标准负项 entry 对照
固定 DATA=0、只读 FLUSH=1 后,标准负项 entry 缓存未检出三轮七工具累计收益:4132.526→4060.983 ms,降幅1.73%,95% CI [-3.45%, 5.26%]。 第三轮 npm 有12.27%的改善信号,前两轮未重复支持;第三轮 hot_open 慢2.50%。NE继续默认关闭。
相同来源与计时范围
2026-10-17,B-FS-ENG 以真实 pvisor run、fresh 私有 Host、VmExecutor 和 native runner 比较 NE=0/1。两组复用同一个已验证 GNU CLI release、0047固件、经 catalog 认证且持 lease 的 prepared rootfs/workspace generation;workspace 保持 frozen baseline,live apply target 独立。没有新构建、导入或封存,原准备收据只说明既存费用,不把旧计时或其他批次收益叠入结果。
Linux x86_64/KVM,guest 2 vCPU/16 GiB,整父组 CPU0/1、两核 quota、16 GiB、swap0;guest cache=1、目录FD容量256。DATA、SQ、两项Core缺项缓存、WB、DAX全0,只读FLUSH固定1。标准负项使用 inode0、entry TTL1秒、attr TTL0,不增加私有 peer 能力或延长属性/正项TTL。
每臂五个新私有 Host/VM、九操作三轮,按五个环境块 seeded 随机交替。10/10正式环境、2/2正确性预检、2/2独立计数环境全部通过;保留唯一Ready/Result、正常退出、terminal Job/Bundle、实际selector/baseline receipt、lower/cache隔离和全部256个写文件及三个stream文件的字节检查。使用独立 namespace/pivot_root/Host authority,不接触既有用户listener。
Ready包含fresh Host+VM启动并排除退出;工具保持原worker时钟,stream_write自身fsync/close保留。正式时序关闭profiling,无额外预热、安静期、干扰或每轮全量清单门禁,所有有效慢样本保留。主要指标仅为逐环境三轮七工具累计;32个95%区间均未校正多重比较,5000次配对bootstrap以五个环境块抽样,三轮不是15个独立样本。
整体未检出,单项信号保留
| 指标 | NE关 ms | NE开 ms | 降幅 | 95% CI % | 结论 |
|---|---|---|---|---|---|
| 三轮七工具累计 | 4132.526 | 4060.983 | 1.73% | [-3.45, 5.26] | 主要;未检出 |
| Ready | 830.839 | 825.440 | 0.65% | [-0.35, 11.50] | 未检出 |
| 第一轮npm | 739.523 | 701.769 | 5.11% | [-6.54, 5.81] | 未检出 |
| 第二轮npm | 484.441 | 500.858 | -3.39% | [-22.46, 16.88] | 未检出 |
| 第三轮npm | 511.013 | 448.324 | 12.27% | [0.37, 20.88] | 未校正改善信号 |
| 第三轮hot_open | 10.210 | 10.466 | -2.50% | [-2.50, -0.66] | 未校正退化信号 |
其余30个区间均跨零,包括所有rg、stream_write及各轮七工具合计。累计的五对原值(ms,按相同pair顺序)为关 [4132.525580,3925.428389,4211.135883,4211.219659,4130.488754]、开 [4132.123292,4060.983456,4127.717011,3992.961109,3913.385616]。四对下降、一对上升;其中一对只省0.402 ms,另一对多135.555 ms。第三轮npm五对均下降,但一对仅省1.737 ms;hot_open五对均慢,不能只保留有利结果。
写入有明显观察间隙。第二轮write,关组较低2/5、中位78.788 ms,较高3/5、150.504 ms;开组较低1/5、78.646 ms,较高4/5、152.404 ms。第三轮关组较低2/5、78.530 ms,较高3/5、143.744 ms;开组较低2/5、82.954 ms,较高3/5、146.267 ms。开组第二轮metadata有76.749 ms的单值,其余四个137.968–151.234 ms;关组Ready保留923.247 ms,其余四个824.922–833.673 ms。N=5不支持稳定分簇、尾延迟或原因归因,全部原值保留。
减少的查询与仍在的工作
每臂独立N1计数环境均有13个注册实例及唯一final,每挂载54个同步token、全环境216个组件区间;合计26个实例、216帧、432区间。关组NE requested/enabled均为0,开组均为1;DATA0且所有对象/标记为0,FLUSH1。完整生命周期的只读FLUSH标记rootfs3680、workspace8501,两臂相同。
| 三轮七工具 / 挂载 | NE关 | NE开 |
|---|---|---|
| rootfs LOOKUP | 3384 | 2023 |
| rootfs Core父叶查询 | 82206 | 64295 |
| workspace LOOKUP | 1176 | 1129 |
| workspace Core父叶查询 | 127565 | 127098 |
rootfs npm三轮LOOKUP分别1335→882、953→532、934→513。第三轮npm的MissingLeaf667→246、parent identity尝试5811→3012、Core父叶查询20063→14465;GETATTR396、OPEN/RELEASE各736、READ/FLUSH0和四类native资格查询尝试2208均保持。第三轮全部七工具rootfs LOOKUP947→521、Core21652→16014;workspace LOOKUP306、Core36962均不变。
三轮七工具rootfs OPEN/READ/FLUSH/RELEASE均为3304/1231/0/3304;workspace均为9859/9520/1647/10144。两臂native journal完整生命周期也均为append345、transaction1276、refresh1277、sync8。计数确认缺项查询减少,同时大量OPEN、属性与其他工作保留,不能按计数直接推算耗时份额或磁盘I/O。
NE开启的整个owner生命周期回复rootfs1056、workspace421,路径回退分别14、0。回复不是guest缓存命中、唯一缺失名或省掉的LOOKUP;rootfs七工具少1361次LOOKUP不能除以1056当命中率。workspace第一轮npm即使有70次回复,LOOKUP仍140→142。当前无kernel负项命中、逐errno及逐拒绝原因计数;fallback只覆盖已启用路径中的受保护前缀或后端回退。计数区间含checked子进程启动、工作和校验,比worker时钟更宽,inclusive spans不相加。
使用边界与下一候选
同机制源的既有SDK诊断覆盖TTL到期、namespace修改、失败rename、权限、Mutable外部创建及exclusion祖先/子树;它使用DATA1/FLUSH1,与此次CLI的DATA0/FLUSH1不同,不冒充新的普通CLI语义全验收。新CLI环境通过原有输出、来源、Bundle和完整字节合同。既有namespace fd属性、copy_file_range、短读原语桩及legacy数据页隔离边界保持;WB的unlink→syncfs ENOENT未在此修复,WB始终0。
结果不支持默认开启NE或继续盲目扩大缓存。静态代码检查找到一个更窄的候选:一次解析内复用已有完整Immutable父身份向量,减少miss为组装完整证明而重复查询祖先;Mutable/upper最终重查、merged可见性、权限/alias和失败语义须保留。该候选尚未实现或测量。
耗时摘要、全部32项比较及耗时来源保留64组五值向量;逐工具计数、owner生命周期及计数来源保留独立N1证据。原始样本、旧制品关联与新审计位于本地 benchmark/.data/cne17-cli/。
Linux:普通 CLI 的数据页与只读 FLUSH 四臂对照
固定已认证的 prepared rootfs、prepared workspace 与 frozen baseline 后,同时启用 DATA 和只读 FLUSH 消除,三轮七工具累计从 4403.334 ms 降至 3983.409 ms,下降 9.54%,95% CI [3.83%, 13.31%]。只读 FLUSH 单项下降 8.86%;在该单项基础上加入 DATA,整体未检出额外收益。 rg 三轮的组合收益为 33.93%–36.55%,相对任一单项也有改善信号。DATA仍默认关闭;只读FLUSH已在限定prepared-rootfs入口自动请求,通用VM worker默认仍关闭。
固定来源,只比较两项机制
2026-10-17,B-FS-ENG 通过真实 pvisor run、fresh Host、VmExecutor 与 native runner 比较四臂。四组复用同一个已验证 GNU release CLI、0047 固件及物理 rootfs/workspace generation;两项公开 selector 均经 catalog 认证并持有 lease。workspace 始终为唯一 Immutable lower、frozen baseline,live apply target 独立,所有权与读观察/journal 语义不随处理变化。
Linux x86_64/KVM,guest 2 vCPU/16 GiB,父预算 CPU 0/1、两核 quota、16 GiB、swap 0;guest cache=1、目录 FD 容量256。SQ、标准负项 entry、两项 Core 缺失缓存、WB、DAX 全部为0。唯一变量是独立 lower DATA 与只读 backend FLUSH 消除的偏好:
| 条件 | DATA | 只读 FLUSH 消除 |
|---|---|---|
| base | 0 | 0 |
| data | 1 | 0 |
| flush | 0 | 1 |
| both | 1 | 1 |
每臂五个 fresh 私有 Host/VM 环境,按五个环境块随机交替,每环境九操作三轮。20/20 正式环境、4/4 正确性预检和4/4 独立计数环境均通过,保留唯一 Ready/Result、正常退出、terminal Job/Bundle、实际 selector/baseline receipt、lower 隔离和全部写文件/stream 字节检查。每样本独立 namespace、pivot_root 和 Host authority,不复用用户 listener。
Ready 包含 fresh Host+VM 启动,worker 保持原内部时钟,两者均排除退出;stream_write 自身 fsync/close 保留。正式时序关闭诊断,无额外预热、安静期、干扰或每轮全量清单门禁,所有有效慢样本保留。没有新增构建、导入或封存;旧 workspace 约1.415 s及更早 rootfs 的准备范围仅引用原收据,不重记为新发生费用,也不把旧计时叠入结果。
累计收益与局部差异
累计先在每个环境内合计三轮七工具,再求五个环境的中位数。预登记的三个主要指标仅为下表前三个累计对照;另两个累计对照及所有单项均为补充。五对照×32指标共160个95%区间,均未校正多重比较;5000次配对 bootstrap 按环境块抽样,三轮不是15个独立样本。全部128组五值向量保留;这些配对差异不估计交互项,也不能与其他 CLI 入口或 SDK 批次的收益相加、相乘。
| 三轮七工具累计:基线 → 候选 | 基线 ms | 候选 ms | 降幅 | 95% CI % | 范围与结论 |
|---|---|---|---|---|---|
| base → both | 4403.334 | 3983.409 | 9.54% | [3.83, 13.31] | 主要;五对均改善 |
| flush → both | 4013.044 | 3983.409 | 0.74% | [-3.02, 2.77] | 主要;未检出差异 |
| data → both | 4208.870 | 3983.409 | 5.36% | [2.62, 8.30] | 主要;五对均改善 |
| base → data | 4403.334 | 4208.870 | 4.42% | [-2.28, 6.49] | 补充;未检出差异 |
| base → flush | 4403.334 | 4013.044 | 8.86% | [4.36, 11.53] | 补充;五对均改善 |
rg 的两项机制互补,组合相对关闭组和任一单项的三轮区间都在零以上。下表为耗时降幅及95% CI;与关闭组相比,组合三轮中位数分别为312.027→199.419、299.491→197.878、305.158→193.608 ms。
| rg 轮次 | base → both | flush → both | data → both |
|---|---|---|---|
| 1 | 36.09% [35.42, 36.76] | 23.35% [20.25, 24.80] | 22.49% [21.28, 23.19] |
| 2 | 33.93% [28.74, 36.31] | 20.97% [19.47, 26.01] | 22.26% [20.23, 24.90] |
| 3 | 36.55% [34.52, 38.17] | 22.08% [19.39, 23.76] | 20.86% [17.60, 24.75] |
base → both 的 npm 三轮均未检出差异;base → flush 的第三轮 npm 则从512.552降至473.029 ms,下降7.71%,CI [2.77%, 21.26%],是未校正的单项信号,不能表述为所有 npm 对照均无收益。全部15个 stream_write 区间(三轮×五对照)跨零,未建立顺序写提速或退化。
base → both 的 Ready 为827.932→826.950 ms,降幅0.12%,CI [-12.72%, 2.35%],未检出差异。另有三个未校正的退化信号,负降幅表示变慢:
| 对照 / 指标 | 基线 ms | 候选 ms | 降幅 | 95% CI % |
|---|---|---|---|---|
| flush → both / Ready | 824.493 | 826.950 | -0.30% | [-9.98, -0.17] |
| base → flush / 第二轮 metadata | 138.278 | 139.915 | -1.18% | [-26.85, -0.20] |
| flush → both / 第三轮 metadata | 137.446 | 149.483 | -8.76% | [-92.88, -5.21] |
写入和属性任务的样本有明显分离,限制单个中位数的解释。按观察间隙描述第二轮 write 的低/高组如下;这不是预登记的稳定分簇模型,也不支持对宿主干扰或机制成本的归因。
| 第二轮 write 条件 | 较低值占比 / 组中位数 ms | 较高值占比 / 组中位数 ms |
|---|---|---|
| base | 4/5 / 80.090 | 1/5 / 157.763 |
| data | 3/5 / 79.654 | 2/5 / 140.320 |
| flush | 3/5 / 79.220 | 2/5 / 128.578 |
| both | 1/5 / 79.122 | 4/5 / 145.552 |
flush 的第三轮 metadata 还有2/5较低值(组中位数76.880 ms)和3/5较高值(138.501 ms)。both Ready 保留943.019 ms的单个慢值,其余四个为817.904–829.986 ms。N=5不足以确认稳定混合分布、尾延迟或原因,所有原值均保留,不事后剔除或用单个 P50 宣称写入变化。
独立请求计数确认实际覆盖
每臂另一个诊断环境都有13个注册实例及各自唯一 final,每挂载54个同步 token、全环境216个组件区间;四臂合计52实例、432帧、864区间。每个 rootfs/workspace owner 显式记录与条件匹配的 requested/enabled,SQ、负项/Core开关为0,容量256。计数区间包含 checked 子进程启动、任务与原校验,不等同 worker_ms;诊断时钟不进入正式样本,inclusive spans 不相加。
| 第三轮七工具 / 挂载 / 协议 calls | base | data | flush | both |
|---|---|---|---|---|
| workspace READ | 2480 | 277 | 2480 | 277 |
| workspace FLUSH | 2681 | 2681 | 542 | 542 |
| workspace OPEN / RELEASE | 2681 / 2682 | 2681 / 2682 | 2681 / 2682 | 2681 / 2682 |
| rootfs READ | 0 | 0 | 0 | 0 |
| rootfs FLUSH | 1028 | 1028 | 0 | 0 |
| rootfs OPEN / RELEASE | 1052 / 1052 | 1052 / 1052 | 1052 / 1052 | 1052 / 1052 |
第三轮 rg 的 workspace READ、FLUSH 各从2051降至1,DATA标记及复用均为2050;OPEN、RELEASE各2051保留。两项分别启用时也分别消除相应请求。所有 owner 的对象拒绝和容量拒绝均为0。完整实例生命周期中,DATA组的 rootfs 有873次注册、2807次复用、3680次标记;workspace为2157、6344、8501次,FLUSH启用组标记数量分别相同。生命周期数包含任务区间之外的启动/收尾,不能与七工具阶段值混用。
节省 RPC 同时新增资格成本:第三轮两挂载七工具的四类 native 资格查询尝试合计为 base 0、data 12764、flush 9573、both 22337。它们与 Core 父/叶软件查询分列,不能把 Core 计数当全部 OPEN 成本或磁盘 I/O。四组 native workspace journal 的完整生命周期均为 append345、transaction1276、refresh1277、sync8,未新增 journal 消除;preimage/journal span也不等于持久写次数。
metadata 第二、三轮在四臂仍各有2050个 workspace GETATTR;stream_write 每轮8192个 WRITE、1个 FSYNC、3个 FLUSH保持。两项机制没有消除这些属性查询或可写关闭屏障,计数不能换算为耗时份额。
按全部五环境×三轮的七个互不重叠 worker 时钟作描述性组成,base 的 npm/rg 占40.82%/20.74%,both 为43.67%/14.71%。这不是新增配对指标或 inclusive profile 归因,npm 占比上升不表示其变慢。组合后的独立第三轮 rootfs npm 仍有934次 LOOKUP、667次 MissingLeaf 和20063次 Core 父/叶查询;READ/FLUSH为0,OPEN/RELEASE各736,另有5152次四类资格查询尝试。下一候选应针对实际 CLI 的缺项查询,属性 GETATTR 与写入屏障则分开诊断,计数本身尚不证明提速。
正确性、准备成本与使用边界
此前同机制源、同0047固件的独立 SDK 探针保留18 VM、310 case、216 final和648同步帧:覆盖整页、旧 lower fd、EOF、mmap、关闭与ATIME。冻结源逐摘要核对有263个 VM、18个 Core和6个 guest 共有文件一致;其中组合的整页/data/close/ATIME 76例使用NE1,DATA-only 25例及FLUSH-only 11例为NE0;配置范围保留在复用审查中。SDK binary 与普通 CLI binary不同,这些案例不冒充新的普通 CLI 语义全验收。新CLI的20正式、4预检与4计数环境通过其原输出、Bundle、字节及来源契约检查。
已有 fstat 与 copy_file_range 边界仍未修复;真实 O_PATH 使用 raw openat/F_GETFL/EBADF 硬断言,musl 构造差异仅作诊断。19个实际短读函数/调用方 C 案例使用原语桩,不是完整 guest/kernel 故障注入。Mutable、upper、多硬链接、远端等不合格来源继续回退;协商后的快照捕获/恢复仍拒绝,prepared workspace 仍限 fresh 入口,见CLI 条件。
该批结果支持优先接通普通 CLI 的只读FLUSH,后续已完成限定prepared-rootfs自动请求;DATA适合重复小文件读取,但未证明在FLUSH基础上的整体额外收益,仍默认关闭。通用VM worker的FLUSH缺省仍关闭,不据此放宽属性TTL、开启WB或修改用户跨运行时表。耗时摘要、全部比较与耗时来源保留128组向量和160个区间;逐工具计数、实例生命周期与计数来源保留独立N1证据。原始报告、冻结制品关联和复用审查留在本地 benchmark/.data/cdf17-cli/。
Linux:普通 CLI 的封存工作区入口
两组都使用 prepared rootfs 时,将普通 CLI 的 live 工作区改为认证的固定 generation 与 frozen baseline,三轮七工具累计从 4688.372 ms 降至 4443.913 ms,下降 5.21%,95% CI [0.44%, 10.91%]。 五对环境的累计都缩短;Ready 未检出差异。第三轮 git 下降 73.74%,但第二轮 stream_write 慢 5.05%。这是工作区所有权/缓存资格与读观察、journal 基线语义的联合处理,不能与prepared-rootfs 独立对照的 18.11% 相加或相乘。
问题与实验设计
普通 CLI 接通 rootfs 所有权后,live Mutable 工作区仍会保留读观察和重复查找。这个对照检验显式封存工作区能否在真实 pvisor run、Host 服务、stage/journal、VmExecutor 与 native runner 路径中进一步降低工具耗时。两组 rootfs 指向同一认证封存物理目录,均声明不支持 execution checkpoint;该值来自 Bundle 的 executor_plan,实际 native binding 未留存、值未知。工作区对照组读取新复制的 live lower,处理组读取持有 lease 的 workspace catalog 固定 generation,并保留独立 live apply target。
公开 pvisor-cache prepare-workspace 在正式时钟外准备一次约 1.415 s;后续启动认证已保留的 generation,不重新封存。固定 generation 不会吸收宿主项目的后续修改;普通 apply 仍以 live 项目为目标,对所选写入路径检查基线冲突。入口条件和逻辑 checkpoint fork/恢复、execution checkpoint 捕获/恢复等限制见CLI与配置参考。准备费用单列,不计入运行收益。
2026-10-17,B-FS-ENG 使用同一冻结 GNU release CLI 与 0047 固件。Linux x86_64/KVM,guest 2 vCPU/16 GiB,父预算 CPU 0/1、两核 quota、16 GiB、swap 0。guest cache=1、目录 FD 容量 256;WB、DAX、独立 lower DATA、只读 FLUSH 消除、标准负项 entry、两项 Core 缺失缓存和同次 OPEN 资格复用均为 0。工作区真实 Immutable 资格可以启用既有目录镜像;这里没有开启独立 lower 数据页缓存。
每组五个 fresh Host/VM 环境,每环境九操作三轮,固定种子按五个环境块随机交替。每样本使用独立 user/mount/PID namespace、owned pivot_root、私有 Host authority 与真实 CLI 制品,不复用用户既有 Host。Ready 从启动 CLI 前计至唯一 guest Ready,包含 fresh Host+VM 启动;worker 保持原任务内部时钟,两者均排除退出。stream_write 自身的 fsync/close 仍在任务内。正式时序关闭 profiling、startup diagnostics 与 Rust logging;无预热、安静期、干扰或全量清单门禁,保留全部有效慢样本。
正式耗时
10/10 正式环境、2/2 预检环境及 2/2 独立诊断环境均通过。正式结果重新核对唯一 Ready/Result、正常 CLI 退出、terminal Job、同 run ID 的 VM Bundle、实际来源参数与 workspace receipt;256 个写文件及三份 stream 文件的完整字节、lower 隔离、工具/Python cache 检查均通过。主要指标先在各环境内合计三轮七工具,再求五环境中位数;5000 次配对 bootstrap 以环境块抽样,三轮不作十五个独立样本,32 个区间未校正多重比较。
单位 ms;降幅为 100 × (1 − 封存/live),负值表示更慢。逐行中位数不要求相加为累计中位数。
| 指标 | live 工作区 | 封存工作区 | 降幅 % | 95% CI % |
|---|---|---|---|---|
| 三轮七工具累计,主要指标 | 4688.372 | 4443.913 | 5.21 | [0.44, 10.91] |
| Ready,fresh Host+VM | 823.420 | 823.755 | -0.04 | [-0.41, 14.16] |
| 第 1 轮七工具合计 | 2288.425 | 2171.404 | 5.11 | [2.66, 18.78] |
| 第 2 轮七工具合计 | 1226.979 | 1158.533 | 5.58 | [-0.87, 16.26] |
| 第 3 轮七工具合计 | 1131.460 | 1144.181 | -1.12 | [-5.06, 4.91] |
第一轮合计有改善信号,第二、三轮合计未检出差异;不能将累计改善写成每轮或每项工具都改善。
| 重点单项 | live 工作区 | 封存工作区 | 降幅 % | 95% CI % |
|---|---|---|---|---|
| metadata 第 1 轮 | 165.958 | 49.680 | 70.06 | [58.14, 72.35] |
| read 第 1 轮 | 109.257 | 77.354 | 29.20 | [28.35, 30.29] |
| git 第 1 轮 | 348.148 | 488.195 | -40.23 | [-45.83, 29.29] |
| git 第 2 轮 | 22.534 | 6.287 | 72.10 | [57.50, 76.64] |
| git 第 3 轮 | 25.534 | 6.706 | 73.74 | [68.06, 78.15] |
| rg 第 1 轮 | 381.784 | 310.505 | 18.67 | [15.95, 20.01] |
| rg 第 2 轮 | 332.679 | 306.725 | 7.80 | [6.68, 9.11] |
| rg 第 3 轮 | 330.227 | 305.918 | 7.36 | [7.13, 8.88] |
| stream_write 第 2 轮 | 398.455 | 418.566 | -5.05 | [-5.05, -1.67] |
首轮 git 的点估计更慢、区间跨零;npm 三轮均未检出差异,stream_write 第二轮有退化信号。所有 32 项及完整精度保留在耗时摘要与配对比较。
累计五对原值按配对次序为 live [4640.929, 4976.164, 4688.372, 4461.678, 4722.226]、封存 [4545.601, 4433.041, 4443.913, 4442.037, 4511.719] ms。五对均改善,其中一对仅缩短 19.641 ms,不能只看累计中位数忽略幅度差异。
以下是观察到的分离取值,分别报告比例与组内中位数,单位 ms;这些组别只描述五个原值,不证明稳定双峰或原因。
| 操作 / 条件 | 较低一组 | 较高一组 |
|---|---|---|
| write 第 2 轮,live | 2/5,89.075 | 3/5,150.359 |
| write 第 2 轮,封存 | 3/5,79.076 | 2/5,152.137 |
| metadata 第 3 轮,live | 2/5,96.377 | 3/5,166.624 |
live Ready 包含 957.248 ms,其余四个为 820.363–831.455 ms;live 首轮 git 包含 690.396 ms,其余为 340.424–359.138 ms。慢值全部保留,不归因宿主干扰,不据 N5 推导尾延迟或删除样本缩窄区间。
独立计数:目录与读观察成本下降,OPEN/READ/FLUSH 保留
每组另跑一个 N1 诊断 VM,不进入正式耗时。每个 VM 的 13 个注册实例均有唯一 final:Core 3、preimage-log 2、log-read 2、Overlay/protocol/dispatch 各 2。每挂载 54 token、27 个操作阶段,共 216 个挂载组件区间完整;两个 mounted owner 的实际目录容量与关闭的实验开关逐一核对。区间包含 checked() 子进程树启动、工作与原有校验,比 worker 时钟更宽。
下表为 workspace 七工具阶段次数,箭头为 live→封存;Core 为 parent 与 leaf 软件查询之和。
| workspace 计数 | 第 1 轮 | 第 2 轮 | 第 3 轮 |
|---|---|---|---|
| LOOKUP | 3673 → 464 | 1918 → 405 | 2044 → 306 |
| GETATTR | 752 → 628 | 677 → 2658 | 646 → 2680 |
| Core 查询 | 156149 → 48314 | 89390 → 42224 | 90544 → 36969 |
| OPEN | 4497 → 4497 | 2681 → 2681 | 2681 → 2681 |
| READ | 4560 → 4560 | 2480 → 2480 | 2480 → 2480 |
| FLUSH | 4785 → 4785 | 2681 → 2681 | 2681 → 2681 |
| RELEASE | 4780 → 4780 | 2682 → 2682 | 2682 → 2682 |
LOOKUP 与 Core 查询明显减少,内容读取和句柄往返没有减少。metadata 第二、三轮单项 GETATTR 为 80→2050、81→2050;这说明正项 lookup 的减少没有消除属性重验证;ATIME 与其他属性失效来源仍需单独核对,不能把 GETATTR 增加单归因于 TTL 到期。
首轮 git 的实际 fingerprint_content span 为 2055→1、内容指纹读取字节为 2,261,307→0;封存组剩余一次复用内容索引。七工具首轮对应为 2156→1、69,375,691→0 字节。frozen baseline 跳过 live 读取时的 preimage 发布,修改仍须保留基线与冲突证据;内容索引复用也保留 metadata/xattr/身份检查。journal_log 包含已有记录检查与提升,调用次数不等于新持久写入次数。本地加工 CSV 的 core_fingerprint_calls 对应非 compact 路径的 generic fallback 标签;其值为 0 不表示 compact 路径没有指纹工作。
两个挂载的全生命周期 READINDEX 均不为零,可能发生在首个工具阶段之前;阶段差分不能代表整个 owner。逐操作计数、owner 累计与计数来源保留完整范围。这些是软件请求与查询计数,不是磁盘 I/O,也不能与 inclusive span 相加计算工具耗时占比。
普通 CLI 下独立lower数据页和只读FLUSH的增量覆盖已由独立四臂对照计时;GETATTR/写入分离取值的具体原因仍需同批对照和原有copy-up、old fd/mmap、别名及冲突oracle。该入口没有修复既有共享页边界或 WB 的 unlink→syncfs 问题,也不支持自动开启未受测组合。复用准备输入的收益取决于实际启动次数,1.415 s 的准备成本应单独摊销。来源摘要保留制品、源码与正式/诊断证据的精简 hash 关联;完整原始记录保留在本地工程证据中。
Linux:同次 OPEN 资格证据复用
复用同一个 native FD 的资格证据,使受测路径的四类资格查询尝试减少 57.14%,但没有检出七工具累计或 Ready 的改善,候选继续默认关闭。 三轮七工具累计中位数为 3809.365→3644.779 ms,耗时降幅点估计 4.32%,95% CI [-4.71%, 9.06%];查询数量下降不能解释为已确认的整体提速。这与普通 CLI prepared-rootfs 的联合处理是独立实验,不叠加收益。
机制与实验设计
独立 lower 数据对象和只读 FLUSH 同时开启后,一次合格 OPEN 原本分别执行两组资格查询:合计两次 F_GETFL、两次 fstat(File::metadata 调用点)、一次 statx 和两次 fstatfs。候选在本次调用栈中共享同一实际 FD 的完整 statx、状态标志和本地文件系统证据,变为 F_GETFL、statx、fstatfs 各一次。只统计这四类资格查询的 7→3,即减少 57.14%;四类均为插桩调用点的尝试计数,未使用 syscall tracer,不能据此确定底层实际 ABI,也不是整个 OPEN 的全部 syscall。
原 Core resolve、授权、别名、journal、native OPEN、FD lease、第二次 backend 检查和数据对象 ID/固定 EOF 约束保留。证据不跨 OPEN 保存,不缓存授权或命名空间结论,也没有新增 wire capability、持久 handle 字段或 snapshot schema。SQ 是 host 偏好;DATA 与 FLUSH 仍分别协商,fallback 保留。两臂内部 open inclusive span 的边界不同,不能直接比较,更不能与其他 span 相加推导耗时。
2026-10-17,B-FS-ENG 使用同一冻结 GNU host 与既有 0047 固件,仅切换默认关闭的 PVISOR_VM_FS_SHARED_OPEN_QUALIFICATION=0|1。DATA=1、只读 FLUSH=1、标准负项 entry=0、两项 Core 缺失缓存=0、目录 FD 容量256、WB=0、DAX=0、guest cache=1。两组复用相同 owned Immutable rootfs/workspace generation 和 frozen workspace baseline;已有封存准备在时钟外,没有按每次启动重新导入。Linux x86_64/KVM,guest 2 vCPU/16 GiB,父预算 CPU0/1、两核 quota、16 GiB、swap0。保留 PVisor、ManagedJob、stage/journal、VmExecutor 与 native runner,省略普通 CLI Host 服务。
每臂五个 fresh 环境、每环境九操作三轮,固定种子按环境块随机交替,正式 profiling 与 Rust logging 关闭。Ready 从启动至 guest Ready,worker 使用原任务内部时钟,均排除退出。保留正常退出、唯一 completed receipt、同 Job Bundle、cache/lower 隔离、256 个写文件和三份 stream 文件的完整字节检查。无安静期、干扰或全量清单门禁,不删除有效慢样本。主要指标先在每个环境内合计三轮七工具,再比较五个环境的中位数;配对 bootstrap 5000次以环境块抽样,三轮不作独立样本,32个区间未校正多重比较。
正式耗时:没有建立整体收益
10/10环境有效、零失败。下表为每臂五个环境的中位数,单位 ms;降幅为 100 × (1 − 开启/关闭),负值表示更慢。各轮先在环境内求和,不要求表中中位数相加等于累计中位数。
| 指标 | 关闭 | 开启 | 降幅 % | 95% CI % |
|---|---|---|---|---|
| 三轮七工具累计,主要指标 | 3809.365 | 3644.779 | 4.32 | [-4.71, 9.06] |
| Ready | 636.570 | 630.220 | 1.00 | [-10.52, 17.08] |
| 第1轮七工具合计 | 1843.590 | 1836.860 | 0.37 | [-9.82, 8.46] |
| 第2轮七工具合计 | 1016.808 | 917.108 | 9.81 | [-1.87, 9.82] |
| 第3轮七工具合计 | 948.748 | 922.674 | 2.75 | [-8.51, 9.42] |
各轮 npm 和 rg 也都未检出差异。三轮累计五对原值按配对次序为关闭 [3839.372, 3809.365, 3654.956, 3504.987, 3912.779]、开启 [3644.779, 3464.083, 3599.055, 3670.007, 3906.615] ms:四对缩短,一对增加 165.020 ms,变化幅度不一致。第一轮 git 的关闭组包含 227.544 ms,其余为 382.786–405.386 ms;第二轮 write 的范围为 77.930–154.502 ms 与 77.935–156.292 ms,metadata 为 76.061–145.899 ms 与 75.564–137.783 ms。全部观察保留,N5不足以确认稳定分簇、尾延迟或原因,不作宿主干扰归因。
32个未校正区间中,只有第二轮 stream_write 有改善信号:435.356→375.640 ms,降幅13.72%,95% CI [0.65%, 15.22%]。第一、三轮没有重复支持,独立诊断中该阶段 workspace 四类资格查询均为零;rootfs 仍有子进程启动查询。因此不能把这个单项信号解释成共享资格直接加速了写入。完整32项分布和区间保留在耗时摘要及配对比较。
独立计数:消除重复分类,没有消除 OPEN
每臂一个独立 N1 诊断环境;每个 VM 的17个注册实例均有唯一 final,构造库存为 Core4、preimage-log3、log-read4、Overlay/protocol/dispatch各2。每挂载54个token、27个操作阶段完整,共216个挂载组件区间。两个 mounted owner 逐一确认实际 SQ=0或1、DATA/FLUSH=1、负项 entry及两项Core缺失缓存=0、容量256。计数区间包含 checked() 子进程树启动、工具和原有校验,比 worker 时钟更宽。
下表为七工具各轮的四类资格查询尝试总和,次数,关闭→开启。只加 F_GETFL、fstat、statx、fstatfs 的尝试计数;其余五个流程标签不重复加入。
| 范围 | 第1轮 | 第2轮 | 第3轮 |
|---|---|---|---|
| rootfs | 8400 → 3600 | 7364 → 3156 | 7364 → 3156 |
| workspace | 29554 → 12666 | 14973 → 6417 | 14973 → 6417 |
两挂载各轮均减少57.14%。完整 owner 生命周期中,rootfs 资格查询为25760→11040,workspace 为59507→25503;相应 shared-attempt/receipt-hit 在开启组分别为3680和8501,旧 FLUSH/DATA分类尝试均为零。关闭组 shared-attempt/receipt-hit 均为零,旧两条分类各执行3680和8501次。receipt hit 包括复用不合格结论,不等于成功发出了数据对象 ID;计数也不是 guest cache hit 或磁盘 I/O。
| 第3轮七工具范围 | OPEN | READ | FLUSH | RELEASE | Core parent+leaf 查询 |
|---|---|---|---|---|---|
| rootfs | 1052 → 1052 | 0 → 0 | 0 → 0 | 1052 → 1052 | 21652 → 21652 |
| workspace | 2681 → 2681 | 277 → 277 | 542 → 542 | 2682 → 2682 | 36601 → 36597 |
第三轮 LOOKUP/GETATTR 也分别保持 rootfs 947/450、workspace 306/2626。两挂载各轮 OPEN、FLUSH、RELEASE 均不变;READ不能笼统说全部相同,rootfs 第一轮为1231→1236,后两轮为零,workspace各轮相同。这支持“重复资格分类被消除”的机制判断,不能据此计算资格查询在工具耗时中的占比。逐操作计数、请求摘要、owner累计和计数来源保留全部九个资格标签与边界。
正确性与覆盖边界
18个独立真实 guest 通过310项硬case、216个注册final和648个同步checkpoint。两SQ设置各保留完整五模式、NE开启的92项case,另测NE关闭16项、DATA-only25项、FLUSH-only11项及旧0046 peer适用的close/fallback11项。原整页、固定EOF、别名/copy-up、mmap、direct I/O、raw O_PATH/EBADF、ATIME、负项、exclusion、权限、修改并发及关闭 oracle 保持。
合格跨fd三轮OPEN/RELEASE均为 [1,1,1]、READ为 [1,0,0];组合资格分类为7→3,DATA-only为4→3。FLUSH-only与旧peer DATA实际为0、FLUSH为1、共享分类尝试为零;Mutable的DATA/FLUSH/负项资格均为0。普通重复负项在NE开启时为1次LOOKUP,关闭时为32次;Mutable和两exclusion区间都保持32次、负项回复0,TTL到期后重新查找。硬case清单与探针来源保留范围;这些不是普通CLI、远端backend、真实snapshot恢复或不支持statx故障的VM验证。
候选没有修复既有 namespace fd fstat 与 copy_file_range 边界,也没有修复WB开启时已知的 unlink→syncfs ENOENT。受测WB为0;本节不支持默认开启新机制,也不把SDK入口结果外推到普通CLI或完整Agent。来源摘要只公开精简 hash 关联及 499 个冻结源文件的来源摘要;冻结制品、源文件、完整报告及全部原始观察保留在本地 benchmark/.data/sq17b/、benchmark/.data/sq17bm/ 与 benchmark/.data/sq17bp/。
Linux:普通 CLI 的 prepared-rootfs 入口
普通 CLI 的 prepared-rootfs 真实入口在受测配置下,将三轮七工具累计耗时从 5659.783 ms 降至 4634.557 ms,下降 18.11%,95% CI [2.00%, 31.90%];Ready 下降 3.26%,95% CI [2.55%, 13.46%]。 五对环境的累计与 Ready 都缩短,但这是 rootfs 所有权/缓存资格和 checkpoint 能力准入同时变化的联合处理,不能将 18.11% 全归给 cache。结果适用于已有可信封存输入的显式入口,不代表任意 live rootfs 或默认 CLI 都有同等收益。
问题与实验设计
工程入口取得缓存资格后,用户仍需要知道普通 CLI 连同真实 Host 启动、stage/journal 和 live workspace 是否受益。因此两组都运行真实 pvisor run,只改变 rootfs 来源参数:普通 --rootfs PATH 与 --rootfs-base-store STORE --rootfs-base ID 指向同一个封存物理目录。prepared 入口通过公开 SnapshotStore 认证取得 lease;持久 catalog pin 由公开 API 保留,原始封存与一次性 catalog 准备在时钟外。没有按每次启动重新导入,本实验也不测首次封存或首次注册的总等待时间。
2026-10-17,B-FS-ENG 两组使用同一冻结 GNU release CLI 与 0047 固件。工作区均为新复制的 live Mutable lower/apply target,没有接入 workspace snapshot 或 frozen baseline。guest cache=1、目录 FD 容量 256、WB=0、DAX=0;独立 lower 数据对象协议、只读 FLUSH 消除、标准负项 entry 和两项 Core 缺失缓存全部为 0。Linux x86_64/KVM,guest 2 vCPU/16 GiB;父预算 CPU 0/1、两核 quota、16 GiB、swap 0。已有的 guest 目录镜像与 root 设备页保留可随 rootfs 的真实 Immutable 资格生效,不应与本组关闭的新 DATA 协议混为一谈。
固定工具负载的完整字节检查没有修复既有 root KEEP_CACHE 的lower/upper 共享页边界。旧 lower fd/mmap 在 copy-up 后的文件对象隔离仍受该边界限制;本组关闭新 DATA 协议,入口性能结果不能作为全局文件对象语义验收。
每组五个 fresh Host/VM 环境,固定种子在五个块内随机交替,每环境九操作三轮。每样本独立 user/mount/PID namespace、owned pivot_root、真实复制的 CLI、私有 /tmp Host authority 与 HOME/XDG;不会重用或停止用户既有 Host。Ready 从 CLI 启动前计至唯一 guest Ready,包含对称 fresh Host+VM 启动;worker 保持任务内部时钟,两者均排除退出。正式计时关闭 profiling、startup diagnostics 和 Rust logging,无预热、安静期、干扰或全量清单门禁,保留全部有效慢样本。
正式耗时
10/10 正式环境有效、零失败。真实 CLI 均正常退出;唯一 Ready/Result、terminal Job、相同 run ID 的 Run Bundle、工具/Python 缓存、live lower 隔离、256 个写文件和三份 stream 文件的完整字节检查通过。分析重新核对冻结配置/制品、随机顺序与原日志,拒绝计时样本中的 filesystem profile/debug 记录。主要指标先在各环境内累计三轮七工具,再求五个环境的中位数;5000 次配对 bootstrap 以环境块抽样,三轮不作独立样本,32 个区间未作多重比较校正。表中单位 ms,降幅为 100 × (1 − prepared/path);各行中位数不要求相加为累计中位数。
| 指标 | 普通 path | prepared | 降幅 % | 95% CI % |
|---|---|---|---|---|
| 三轮七工具累计,主要指标 | 5659.783 | 4634.557 | 18.11 | [2.00, 31.90] |
| Ready,fresh Host+VM | 863.692 | 835.578 | 3.26 | [2.55, 13.46] |
| 第 1 轮七工具合计 | 2864.324 | 2247.333 | 21.54 | [-4.30, 41.32] |
| 第 2 轮七工具合计 | 1431.477 | 1181.038 | 17.50 | [11.00, 30.70] |
| 第 3 轮七工具合计 | 1351.539 | 1206.185 | 10.75 | [4.26, 18.49] |
第二、三轮合计有改善信号,第一轮合计未检出差异。较明确的单项信号如下;其他单项保留在完整比较,不能将七工具累计改善写成每项工具都改善。
| 单项 | 普通 path | prepared | 降幅 % | 95% CI % |
|---|---|---|---|---|
| cargo 第 1 轮 | 477.596 | 363.002 | 23.99 | [19.05, 43.30] |
| cargo 第 2 轮 | 35.362 | 19.490 | 44.88 | [43.47, 58.12] |
| cargo 第 3 轮 | 33.537 | 19.927 | 40.58 | [35.82, 46.17] |
| npm 第 1 轮 | 905.754 | 781.599 | 13.71 | [12.14, 37.27] |
| npm 第 2 轮 | 777.578 | 523.573 | 32.67 | [18.04, 35.21] |
| npm 第 3 轮 | 699.517 | 517.478 | 26.02 | [18.27, 26.24] |
| rg 第 2 轮 | 346.466 | 332.988 | 3.89 | [1.65, 15.52] |
| rg 第 3 轮 | 340.846 | 331.029 | 2.88 | [2.44, 4.70] |
累计五对原值按配对次序为 path [5262.059, 5661.812, 5659.783, 5254.040, 6909.506]、prepared [4400.809, 4634.557, 4571.396, 5148.752, 4705.643] ms。所有值均保留;其中一对仅缩短 105.287 ms,不能只看中位数忽略幅度变化。path Ready 有一个 962.967 ms 值,其余为 857.432–870.931 ms;首轮 git 两组都有分离取值,path 为 345.917–1007.694 ms、prepared 为 332.105–679.683 ms。第三轮 write 与 metadata 的中位数反而更高,区间均跨零。N5 不足以确认稳定分簇、尾延迟或原因,不归因宿主干扰,也不删除慢值缩窄区间。
独立计数与归因边界
每组另一个 N1 诊断环境,计数时钟不进入正式结果。按冻结真实 CLI 构造核对的每 VM 13 个实例库存完整,注册与唯一 final 全等:Core 3、preimage-log 2、log-read 2、Overlay/protocol/dispatch 各 2;覆盖 Host stage/journal、两个 VM 挂载及 workspace journal 和准备/Bundle 读取。每挂载 54 token、27 操作,合计 216 个挂载组件区间完整;每个 mounted owner 实际容量为 256、各新实验开关为 0。计数区间包含 checked() 子进程启动、工作与原有校验,比 worker 时钟更宽。
下表为七工具各轮请求次数,箭头表示 path→prepared;Core 为 parent 与 leaf 查询之和。rootfs 取得缓存资格后,第二、三轮 READ 为零,但正常 OPEN 与 FLUSH 保留。
| rootfs 计数 | 第 1 轮 | 第 2 轮 | 第 3 轮 |
|---|---|---|---|
| READINDEX | 0 → 125 | 0 → 21 | 0 → 0 |
| OPEN | 1200 → 1200 | 1052 → 1052 | 1052 → 1052 |
| READ | 2339 → 1234 | 1475 → 0 | 1475 → 0 |
| LOOKUP | 4307 → 1474 | 3791 → 966 | 3794 → 947 |
| GETATTR | 518 → 253 | 455 → 456 | 453 → 454 |
| FLUSH | 1160 → 1160 | 1028 → 1028 | 1028 → 1028 |
| Core 查询 | 110969 → 38607 | 101564 → 22015 | 101568 → 21660 |
第三轮 rootfs npm 的 READ 为 891→0、LOOKUP 2943→934、Core 85315→20012,但 GETATTR 为 211→383;cargo 对应为 READ 147→0、LOOKUP 189→4、Core 3198→330。元数据调用不会一律下降,也不能将 Core 全局查询差额当作 native OPEN 资格开销或某个工具的精确耗时占比。
| live workspace 计数 | 第 1 轮 | 第 2 轮 | 第 3 轮 |
|---|---|---|---|
| READINDEX | 1 → 1 | 0 → 0 | 0 → 0 |
| OPEN | 4497 → 4497 | 2681 → 2681 | 2681 → 2681 |
| READ | 4560 → 4560 | 2480 → 2480 | 2480 → 2480 |
| LOOKUP | 3673 → 3621 | 1917 → 2167 | 2122 → 1927 |
| GETATTR | 748 → 755 | 679 → 679 | 650 → 650 |
| FLUSH | 4785 → 4785 | 2681 → 2681 | 2681 → 2681 |
| Core 查询 | 156125 → 155551 | 89391 → 92646 | 91577 → 89088 |
工作区 OPEN、READ、FLUSH 未变,LOOKUP 与 Core 有双向变化,第二轮还增加;workspace 首轮 fingerprint 字节两组同为 69,375,691,后两轮为零。这里没有 frozen baseline 或工作区数据缓存处理。软件查询不是磁盘 I/O,inclusive span 不可相加推导 worker 时间。逐工具计数和计数来源保留全部阶段与实际开关。
联合处理还改变 checkpoint 准入:Bundle 的 executor_plan.supports_checkpoint 声明为 path=true、prepared=false,这是计划声明而非一次 checkpoint 成功的观测。记录保留 control socket/pool 配置;私有临时 RunnerSpec 的 native binding 未留存,实际值未知,只能从冻结源码推断 prepared 跳过 binding、普通无网络路径可在 drivers 提供 store 时绑定。没有为对照关闭普通路径能力,Ready 差异不能单独归因于 cache,也不证明普通路径每次进行了全树快照审计。
该结果支持继续完善有明确所有权的普通 CLI prepared-rootfs 入口;它不支持将活目录误标 Immutable、自动开启未受测的新协议,或把不同批次的收益相加/相乘。封存准备成本和缺失的首次导入时钟需要在产品决策中单独考虑。耗时摘要、完整比较和来源保留五对样本、32 个区间与冻结证据关联。原始时序、独立计数、输入准备和制品证据保留在本地 benchmark/.data/pc17b/。
Linux:标准负项 entry 缓存
标准负项缓存将三轮七工具累计耗时从 3725.942 ms 变为 3602.273 ms,下降 3.32%,95% CI [-2.83%, 4.09%],未检出整体收益;第三轮 npm 有 13.08% 的改善信号,候选继续默认关闭。 独立诊断中,rootfs 七工具三轮累计 LOOKUP 减少 40.26%,workspace 变化较小。该机制覆盖了重复不存在查询,没有建立 Ready 或整组任务加速的结论。
要回答的问题是:在已开启独立 lower 数据页和只读 FLUSH 消除的 owned-input 路径中,用标准 FUSE 负项 entry 保存合格的不存在结果,能否进一步缩短普通工具任务?软件查询数量减少只能说明机制覆盖了请求,不能代替耗时证据。
机制与实验范围
同一冻结 GNU host 与既有 0047 固件,仅切换默认关闭的 PVISOR_VM_FS_NEGATIVE_ENTRY_CACHE=0|1。两组 DATA=1、只读 FLUSH=1、目录 FD 容量 256、两项 Core 缺失缓存=0、WB=0、DAX=0、guest cache=1;复用相同 owned Immutable rootfs/workspace generation 和 frozen workspace baseline。Linux x86_64/KVM,guest 2 vCPU/16 GiB,保留 PVisor、ManagedJob、stage/journal、VmExecutor 和 native runner,省略 CLI Host 服务。已有封存输入的准备不在 Ready 或工具时钟内,也没有按每次启动重新导入。
候选只将成功完成 Core 命名空间、策略、别名和缺失观察检查的 merged absence 返回为标准 nodeid=0、entry TTL 1 秒、attr TTL 0 的成功回复,不分配 inode。Core exclusion 的 ENOENT 仍为错误;exclusion 与 synthetic 名称的祖先、自身和后代均走原普通 lookup,同名 component 的兄弟路径可独立合格。这样 rootfs 中的 host-authority 隐藏路径不会使无关名字失去资格。正项和属性 TTL 不延长,Mutable、非默认授权规则、远端/未知 backend、WB/DAX 等仍回退;显式资格还要求 upper namespace、目录权限、物理根、祖先和挂载身份在 owner 生命周期内受独占稳定合同约束。负项可缓存不等于 lower 数据页可复用,两种资格分别检查。新偏好没有新增 wire capability,既有 DATA/FLUSH 的协商及快照限制继续保留。
正式设计为每组五个 fresh 环境、每环境九操作三轮,按固定种子在环境块内随机交替。Ready 从启动计至 guest Ready,worker 只计任务,两者均排除退出;正式计时关闭 profiling。保留原输出、cache、Bundle、lower 隔离、256 个写文件和三份 stream 文件的逐字节检查及全部有效慢样本,无安静期、干扰或全量清单门禁。主要指标为每环境内先求三轮七工具累计,再比较五个环境的中位数;环境块配对 bootstrap 5000 次,三轮不作独立样本,32 个指标区间未校正多重比较,不合并旧批次。
正式耗时
正式 10/10 环境有效、零失败;正常退出、唯一 completed receipt、同 Job Bundle、全部写文件与 stream 字节重新审计通过。下表为每组五环境的中位数,单位 ms;降幅为 100 × (1 − 开启/关闭),负值表示更慢。各轮合计与三轮累计均先在每个环境内求和,因此不要求逐行中位数相加等于累计中位数。
| 指标 | 关闭 | 开启 | 降幅 % | 95% CI % |
|---|---|---|---|---|
| 三轮七工具累计,主要指标 | 3725.942 | 3602.273 | 3.32 | [-2.83, 4.09] |
| Ready | 626.342 | 628.624 | -0.36 | [-1.36, 8.32] |
| 第 1 轮七工具合计 | 1855.661 | 1830.526 | 1.35 | [-1.38, 6.52] |
| 第 2 轮七工具合计 | 930.908 | 940.753 | -1.06 | [-11.31, 6.91] |
| 第 3 轮七工具合计 | 895.260 | 857.833 | 4.18 | [-4.95, 14.56] |
| 第 3 轮 npm | 470.086 | 408.606 | 13.08 | [5.95, 20.50] |
主要指标、Ready 和三轮各自合计的区间均跨零。第三轮 npm 的五对样本都向更短耗时变化,但它是未校正多重比较的单项信号;第一、二轮 npm 和三轮 rg 均未检出差异。32 个指标中另有第二轮 stream_write 的 8.58% 信号,95% CI [0.10%, 15.02%],不据此推导写路径改善。全部分布和区间保留在配对比较中。
三轮累计五个观察的范围为关闭 3595.534–3755.754 ms、开启 3576.400–3697.274 ms,存在重叠。write 的取值较分散:第二轮关闭 78.188–154.617 ms、开启 78.542–154.637 ms;第三轮关闭 78.335–141.832 ms、开启 77.793–154.746 ms。metadata 第二轮也有 75.493–148.861 ms 与 90.182–138.570 ms 的跨度。所有这些有效观察均保留;N5 不足以确认稳定分簇或解释原因,不作宿主干扰归因,也不通过删除慢值收窄区间。
独立计数:收益集中在 rootfs 的 npm 查找
B-FS-DIAG 每组一个独立新环境。每个 VM 的 17 个注册实例均有唯一 final;每个挂载 54 个 token、27 个操作阶段完整,共 216 个挂载组件区间。两个 mounted Overlay 在关闭组均实际为 0,在开启组均实际为 1;DATA/FLUSH 均为 1,两项 Core 缺失缓存均为 0,容量逐实例核对为 256。实际资格来自这两个独立诊断 VM,不是十个 profile-off 时序 VM 的逐实例计数。
下表为每组 N1 的次数,箭头均表示关闭→开启。Core 查询是 parent stat 与 leaf stat 之和;区间包含 checked() 子进程树启动、工具工作和原有校验,比 worker 时钟范围更大。
| rootfs 范围 | LOOKUP | GETATTR | Core 查询 |
|---|---|---|---|
| npm 第 1 轮 | 1335 → 883 | 115 → 116 | 33347 → 27199 |
| npm 第 2 轮 | 952 → 533 | 395 → 396 | 20417 → 14843 |
| npm 第 3 轮 | 935 → 514 | 384 → 396 | 20013 → 14466 |
| 七工具第 1 轮 | 1436 → 939 | 248 → 249 | 38051 → 31515 |
| 七工具第 2 轮 | 965 → 540 | 450 → 451 | 22006 → 16391 |
| 七工具第 3 轮 | 947 → 521 | 438 → 451 | 21601 → 16014 |
| 七工具三轮累计 | 3348 → 2000 | 1136 → 1151 | 81658 → 63920 |
第三轮 rootfs npm 的 LOOKUP 减少 45.03%、Core 查询减少 27.72%;七工具对应减少 44.98% 和 25.86%。GETATTR 没有同步下降,七工具三轮累计反而增加 15 次。该机制没有清除全部元数据工作。
| workspace 范围 | LOOKUP | GETATTR | Core 查询 |
|---|---|---|---|
| 七工具第 1 轮 | 463 → 448 | 622 → 617 | 48267 → 48095 |
| 七工具第 2 轮 | 419 → 380 | 2628 → 2629 | 42104 → 41663 |
| 七工具第 3 轮 | 307 → 306 | 2629 → 2628 | 36617 → 36609 |
| 七工具三轮累计 | 1189 → 1134 | 5879 → 5874 | 126988 → 126367 |
workspace 七工具三轮 LOOKUP 减少 4.63%、Core 查询减少 0.49%。其中 npm 各轮 LOOKUP 为 138→137、127→87、15→13;Core 为 2794→2764、7336→6895、1849→1840。该计数对照在 workspace 的查询节省远小于 rootfs。
下列请求逐轮在两组完全相同,表中数组依次为第 1/2/3 轮,均只统计七工具阶段:
| 范围 | OPEN | READ | FLUSH | RELEASE |
|---|---|---|---|---|
| rootfs | 1200 / 1052 / 1052 | 1231 / 0 / 0 | 0 / 0 / 0 | 1200 / 1052 / 1052 |
| workspace | 4497 / 2681 / 2681 | 2494 / 277 / 277 | 563 / 542 / 542 | 4780 / 2682 / 2682 |
开启组完整 owner 生命周期的负项回复为 rootfs 1041 次、workspace 420 次;七工具三轮阶段分别为 974 次和 418 次,差额属于其他操作或启动/退出等范围。它们是 host 决定返回标准负项 entry 的次数,不是 guest cache hit 数,也不是全部 ENOENT。全局 Core 物理查询不等于 native OPEN 资格检查次数、磁盘 I/O 或耗时占比;inclusive span 不能相加推导 worker 时间。逐工具计数与计数来源保留边界及实际资格。
正确性与产品覆盖
两组共 10 个独立真实 guest VM,通过 184 个硬 case,120 个注册实例各有唯一 final,612 个同步 token 完整。每组保留原 14 个负项 case,并新增现有 exclusion 子项与缺失 exclusion 祖先两例;原整页 4、data 25、close 11、ATIME 36 个 case 的 oracle 保持。稳定普通名字的 32 次重复缺失查询从 32 次 LOOKUP 降至 1 次,Mutable 和两个受保护区间仍为 32→32,受保护区间负项回复为 0→0;TTL 到期后重新查询。create/link/rename/unlink、失败修改、权限和并发可见性继续检查,已有 fstat 与 copy_file_range 边界没有因此修复。
普通 CLI 的 prepared-rootfs 接入已单独通过一次真实 VM 正向烟测,验证配置、持久化 selector、退出及 live workspace/stage 隔离;该次 workspace 为 Mutable,DATA、FLUSH 和负项缓存均关闭,性能样本数为零。该烟测不测量 Ready 或工具提速;普通 CLI 的独立计时测量了关闭这些新机制的入口联合处理,DATA/FLUSH/负项缓存开启组合仍无普通 CLI 正式性能样本。CLI 验证摘要保留该范围。本节工程入口结果不改写普通 CLI 用户表,不与旧批次收益相加或相乘,也不构成默认开启建议。耗时摘要、配对比较与来源保留正式结果和范围。原始时序、独立计数与冻结/探针证据分别保留在本地 benchmark/.data/nf17m/、benchmark/.data/nf17p/ 和 benchmark/.data/nf17/。
Linux:数据页缓存与只读 FLUSH 的同批四臂对照
组合相对全关、仅 FLUSH、仅 data 的三项主要三轮七工具累计区间均跨零,未检出整体差异。 rg 三轮相对全关有 36.46%、35.87%、35.85% 的改善信号,相对任一单项也有改善信号。Ready 未检出差异。git 和写入存在明显分离观察,累计也有有效慢样本;这些结果不建立稳定的整体速度水位;该批SDK入口的两项默认均关闭。当前DATA仍默认关闭,限定prepared-rootfs入口的只读FLUSH已接通。
同批条件与逐环境分布
2026-10-17,B-FS-ENG 以 PVISOR_VM_FS_LOWER_DATA_CACHE 与 PVISOR_VM_FS_READONLY_FLUSH_ELISION 构成完整四臂:全关 (0,0)、仅 data (1,0)、仅 FLUSH (0,1)、两者开启 (1,1)。产品 host、0047 固件和 guest 与下述独立数据页实验逐 SHA 相同,没有产品代码差异;实验 harness 增加严格的四组合声明和验证。两项缺失缓存关闭,目录 FD 容量 256、WB=0、DAX=0、guest cache=1;四臂使用同一 owned Immutable rootfs/workspace 和 frozen baseline。Linux x86_64/KVM,guest 2 vCPU/16 GiB,沿用正常 PVisor、ManagedJob、stage/journal、VmExecutor 和 native runner,省略 CLI Host 服务。封存准备在时钟外,正式计时关闭 profiling。
每臂五个 fresh VM,按固定种子在五个配对环境块内随机交替,每环境九操作三轮,无预热。20 个正式环境全部通过输出、工具缓存继承、正常退出、唯一完成收据、同一 Run Bundle、lower 隔离及全部写入/流写字节校验,失败为零。没有安静期、干扰或全量清单门禁,全部有效慢样本保留。Ready 只计可用输出,排除工具和退出;worker 时钟排除启动与退出,stream_write 保留自身 fsync/close。三轮相关,独立单位仍为每臂五个环境。累计先逐环境合计七工具的 21 个 worker 时钟,不是完整任务墙钟。
下表列出容易被单一中位数掩盖的原值,单位 ms;每格按相同五个配对块顺序排列,没有重新排序或删值。
| 配置 | 三轮七工具累计五值 | 第一轮 git 五值 | 第二轮 write 五值 |
|---|---|---|---|
| 全关 | 4194.020, 4053.891, 4381.354, 4166.841, 4194.600 | 483.359, 478.957, 481.103, 473.820, 409.048 | 78.694, 78.204, 144.111, 78.653, 78.265 |
| 仅 data | 3900.397, 4282.989, 4140.359, 3906.282, 4180.700 | 500.143, 497.963, 488.727, 490.670, 494.632 | 78.744, 154.757, 78.521, 79.988, 142.362 |
| 仅 FLUSH | 3893.136, 3949.882, 3806.316, 4011.330, 3989.992 | 393.816, 388.706, 237.472, 394.793, 395.724 | 135.390, 78.518, 156.306, 155.250, 79.216 |
| 两者开启 | 4240.425, 3709.847, 3743.222, 3623.802, 3826.109 | 407.036, 402.128, 387.853, 219.856, 404.665 | 144.888, 141.439, 78.563, 154.812, 148.075 |
第二轮 write 按观察间隙呈现低/高分离:四臂低值分别为 4、3、2、1 个,约 78–80 ms;其余高值约 135–156 ms。这个事后描述不是预登记分簇,N=5 也不足以建立稳定簇或尾延迟;不以单一中位数给出写入提速/退化结论。第一轮 git 的仅 FLUSH 和组合组各有四个约 388–407 ms 的值及一个更低的 237.472/219.856 ms 值,区间因此很宽。第二轮 metadata 在全关/仅 data 中也有约 75–83 与 123–144 ms 的分离观察。没有将这些现象归因为宿主干扰或具体机制。
仅 data 的累计原值也有两个处于 3900–3906 ms、三个处于 4140–4283 ms;组合组四个处于 3624–3826 ms,另一个为 4240.425 ms。这些是观察间隙,不建立持久分簇。组合组同一个有效环境还包含第二轮 npm 742.262 ms、第三轮 read 85.993 ms;其余四个组合 read 为 27.170–27.281 ms。这些慢值全部进入 bootstrap。全部 32 个指标的逐环境值保留在完整统计中;累计的单一中位数投影不作为稳定整体排名。
预登记对照与局部工具信号
三项主要对照为全关→组合、仅 FLUSH→组合、仅 data→组合,补充全关→两个单项,共五对各 32 个指标。下表为预登记的累计中位数降幅投影,正值表示更快;95% CI 使用五个环境块的 5,000 次配对 bootstrap,解释时须保留上述完整分布。
| 对照 | 角色 | 三轮累计降幅 % | 95% CI % | 结论 |
|---|---|---|---|---|
| 全关→组合 | 主要 | 10.75 | [-1.11, 14.56] | 未检出差异 |
| 仅 FLUSH→组合 | 主要 | 5.23 | [-8.92, 9.66] | 未检出差异 |
| 仅 data→组合 | 主要 | 9.59 | [-8.72, 13.38] | 未检出差异 |
| 全关→仅 data | 补充 | 1.28 | [-5.65, 7.00] | 未检出差异 |
| 全关→仅 FLUSH | 补充 | 5.82 | [2.57, 13.12] | 改善信号 |
补充对照的信号不能替代三项主要累计均跨零的结果。rg 各轮的降幅与 95% CI 如下,单位 %。
| rg 轮次 | 全关→组合 | 仅 FLUSH→组合 | 仅 data→组合 |
|---|---|---|---|
| 第一轮 | 36.46 [35.10, 37.78] | 23.64 [20.97, 25.84] | 22.15 [18.74, 25.42] |
| 第二轮 | 35.87 [34.61, 36.85] | 23.11 [22.19, 26.92] | 21.01 [18.86, 23.25] |
| 第三轮 | 35.85 [31.00, 36.76] | 22.62 [17.07, 24.30] | 22.04 [15.72, 29.38] |
第一轮 git 的组合相对全关有 16.04% 信号,CI [1.07%, 53.60%];相对仅 data 为 18.70%,CI [18.19%, 55.19%],相对仅 FLUSH 则未检出差异:降幅 -2.11%,CI [-63.33%, 44.31%]。仅 data 相对全关的第一轮 git 有 3.27% 退化信号,降幅 CI [-20.92%, -1.58%]。这些区间须结合 git 的分离观察,不能把一个点估计当作稳定 git 水位。组合的第二轮 read 相对全关有 14.98% 信号,CI [11.82%, 15.21%];第三轮因保留慢值,CI [-167.40%, 15.42%],未检出差异,不能外推第二轮结果。
五个对照的 Ready 均未检出差异。160 项配对比较与来源摘要保留全部指标和统计方法。160 个逐项区间未校正多重比较,指标、轮次与对照相互相关;不进行两个单项互比或交互作用项检验,不从这些信号推出全面七工具改善,也不将旧批次的 data/FLUSH 百分比相加。
独立请求计数与组合正确性
B-FS-DIAG 为四臂各跑一个独立 fresh 环境,不混入正式计时。每臂 17 个注册实例均有恰一个 final,54 个 token 在 rootfs/workspace 两设备均完整,共 216 个阶段组件区间;每个挂载 owner 的 data/FLUSH 实际协商值严格对应四组合,容量为 256、两项 Core 缓存为 0。计数区间包含 checked() 子进程树启动、工具和原有校验,超过 worker 时钟边界。下表为第三轮计数,N=1/臂。
| 范围 / 请求 | 全关 | 仅 data | 仅 FLUSH | 两者开启 |
|---|---|---|---|---|
| rootfs 七工具 READ | 0 | 0 | 0 | 0 |
| rootfs 七工具 FLUSH | 1028 | 1028 | 0 | 0 |
| rootfs 七工具 OPEN / RELEASE | 1052 / 1052 | 1052 / 1052 | 1052 / 1052 | 1052 / 1052 |
| workspace 七工具 READ | 2480 | 277 | 2480 | 277 |
| workspace 七工具 FLUSH | 2681 | 2681 | 542 | 542 |
| workspace 七工具 OPEN / RELEASE | 2681 / 2682 | 2681 / 2682 | 2681 / 2682 | 2681 / 2682 |
| workspace rg READ / FLUSH | 2051 / 2051 | 1 / 2051 | 2051 / 1 | 1 / 1 |
| workspace rg OPEN / RELEASE | 2051 / 2051 | 2051 / 2051 | 2051 / 2051 | 2051 / 2051 |
| workspace rg data 标记 / FLUSH 标记 | 0 / 0 | 2050 / 0 | 0 / 2050 | 2050 / 2050 |
两机制分别减少 READ 与 FLUSH,组合保留了这两类请求节省;OPEN/RELEASE 没有减少。组合 rg 的对象复用为 2050 次,各 owner 的对象容量拒绝为零。逐工具计数与计数来源保留各轮和完整覆盖。native fstat、F_GETFL、statx、fstatfs 资格调用未单列计数,OPEN 标记与对象 ID 复用不等于这些调用次数;Core 查询也不覆盖全部资格成本。inclusive span 不相加,不能精确归因 git 变化或推算 worker 加速比例。
两项同时启用的独立真实 guest 四模式分别通过原整页 4、data 25、close 11、ATIME 36 个 case,共 76 个;四个 VM 的 48 个注册实例各有唯一 final,296 个同步 token 完整。组合探针、探针来源与同步阶段保留原字节、EOF、关闭与 ATIME oracle,没有正式性能样本。真实 O_PATH 仍使用 raw openat/F_GETFL/EBADF 硬断言,musl Rust 构造差异仅作诊断;已有 fstat 与 copy_file_range 边界没有因此修复。协商后的快照捕获/恢复仍拒绝,该批未覆盖普通 CLI 的 owned-input 接入,其通用SDK默认值均为 0。后续普通 CLI 四臂计时已覆盖DATA/FLUSH开启组合,但未扩大完整语义验收。现有封存 rootfs 入口另有普通 CLI 对照,该对照保持两项新机制关闭。原始计时、计数和冻结证据分别在 benchmark/.data/df17m/、benchmark/.data/df17p/ 和 benchmark/.data/df17/,与旧实验独立。
Linux:Immutable lower 独立数据页缓存
三轮七工具累计从 4251.227 ms 变为 4052.522 ms,下降 4.67%,95% CI [-0.20%, 7.40%],未检出整体收益;rg 三轮有 17.54%、17.40%、17.73% 的改善信号,候选继续默认关闭。 第二、三轮 read 分别有 12.47%、13.30% 的改善信号,第一轮 git 反而有 2.79% 的退化信号。Ready 未检出差异。独立 guest 探针支持受测范围内的 lower/upper 数据页与固定 EOF 隔离,结果不代表完整文件对象语义已修复,也不改写普通 CLI 用户表。
条件与正式计时
2026-10-17,B-FS-ENG 使用同一冻结 GNU host 与 0047 固件,仅切换 PVISOR_VM_FS_LOWER_DATA_CACHE=0|1。两组均复用 owned Immutable rootfs/workspace 与 frozen baseline;目录 FD 容量 256、WB=0、DAX=0、guest cache=1,lower 负项缓存、upper 不存在缓存和只读 FLUSH 消除全部关闭。Linux x86_64/KVM,guest 2 vCPU/16 GiB,保留正常 PVisor、ManagedJob、stage/journal、VmExecutor 和 native runner,省略 CLI Host 服务;既有输入封存在时钟外,正式计时关闭 profiling。
每组五个 fresh VM,同轮 seeded 随机配对,每环境九操作三轮、无预热。十个正式环境全部通过正常退出、输出、工具缓存继承、Run Bundle、lower 隔离、全部写文件及流写字节校验,失败为零。没有安静期、干扰或全量清单门禁,保留全部有效慢样本。Ready 排除工具与退出,worker 时钟排除启动与退出;stream_write 保留自身 fsync/close。三轮相关,独立样本数仍为每组五个。累计值先逐环境合计 21 个七工具 worker 时钟,再取中位数,不是完整任务墙钟。
下表为 ms 中位数;降幅为正表示更快,负值表示退化。95% CI 使用五个环境块上的 5,000 次配对 bootstrap。
| 指标 | 关闭 | 开启 | 降幅 % | 95% CI % |
|---|---|---|---|---|
| Ready | 630.046 | 631.095 | -0.17 | [-2.30, 2.08] |
| 三轮七工具累计 | 4251.227 | 4052.522 | 4.67 | [-0.20, 7.40] |
| 第一轮七工具合计 | 2087.586 | 2057.554 | 1.44 | [-2.87, 3.90] |
| 第二轮七工具合计 | 1107.654 | 1055.036 | 4.75 | [-0.28, 12.00] |
| 第三轮七工具合计 | 1114.969 | 973.086 | 12.73 | [-12.29, 16.34] |
| 第一轮 rg | 304.234 | 250.860 | 17.54 | [16.27, 18.40] |
| 第二轮 rg | 298.140 | 246.262 | 17.40 | [15.65, 30.67] |
| 第三轮 rg | 299.072 | 246.034 | 17.73 | [14.40, 20.92] |
| 第二轮 read | 31.112 | 27.234 | 12.47 | [12.05, 15.26] |
| 第三轮 read | 31.378 | 27.203 | 13.30 | [12.05, 17.16] |
| 第一轮 git | 481.001 | 494.406 | -2.79 | [-4.38, -2.16] |
| 第一轮 hot_open | 10.186 | 10.321 | -1.32 | [-2.58, -1.16] |
完整统计、32 项配对比较与来源摘要保留逐环境值和完整精度。三轮各合计与累计均未检出差异,write、metadata、npm 也均未检出差异;第一轮 hot_open 另有退化信号。所有逐项区间未校正多重比较,三轮和各合计相互相关,N=5 不支持尾延迟或全面无退化保证。不能将 rg 的局部改善、其他候选的百分比或跨批次绝对时间相加为整体收益。
实际协商、请求变化与剩余成本
独立 B-FS-DIAG 每组一个新环境,两组均有效。每组 17 个注册实例都有唯一 final record,rootfs/workspace 的 216 个阶段组件区间与 54 个同步 token 完整;逐挂载确认容量 256、实际 data 协商值为该组的 0/1,其余三项实验开关关闭。启用计数表示 owner 生命周期内曾成功协商,该批均为单会话 fresh VM。区间包含 checked() 子进程树启动、工具和原有校验,比 worker 时钟更大;诊断时间不进入正式分布。
下表为第三轮请求数,N=1/组;七工具合计只汇总对应七个阶段,Core 查询为 parent-stat 与 leaf-stat 单位之和。
| 范围 / 请求或标记 | 关闭 | 开启 |
|---|---|---|
| rootfs 七工具 READ | 0 | 0 |
| rootfs 七工具 OPEN / FLUSH / RELEASE | 1052 / 1028 / 1052 | 1052 / 1028 / 1052 |
| rootfs 七工具 Core 物理查询 | 21653 | 21652 |
| workspace 七工具 READ | 2480 | 277 |
| workspace 七工具 OPEN / FLUSH / RELEASE | 2681 / 2681 / 2682 | 2681 / 2681 / 2682 |
| workspace 七工具 Core 物理查询 | 37346 | 36590 |
| workspace rg READ | 2051 | 1 |
| workspace rg OPEN / FLUSH / RELEASE | 2051 / 2051 / 2051 | 2051 / 2051 / 2051 |
| workspace rg 合格 OPEN 标记 / 对象 ID 复用 | 0 / 0 | 2050 / 2050 |
workspace 第三轮七工具 READ 下降 88.83%。rg 的 READ 三轮分别从 2051 变为 2、1、1;其首轮标记中有 2049 次 ID 复用,说明同一轮也复用已登记对象,不能把全部收益解释为跨轮预热。各挂载 owner 的对象容量拒绝均为零。该机制减少数据读取往返,普通 OPEN、FLUSH、RELEASE 与 Core 路径仍有成本;本对照的只读 FLUSH 消除关闭。逐工具计数与计数来源保留各轮及生命周期范围。
Core 查询降低不表示全部 host 查询成本降低:新的合格 OPEN 还检查 native fstat、F_GETFL、完整 statx 身份及 fstatfs,这些不计入 Core parent/leaf 单位。每次 OPEN 的资格检查是后续可定位的成本假说,现有计数不能将第一轮 git 退化精确归因于它。inclusive span 不相加,不换算为 worker 耗时占比,也不据 N1 请求数推导工具加速比例。
对象所有权、真实 guest 证据与保留边界
INIT bit 44 与 OPEN bit 28 显式协商后,合格 OPEN 用固定 24 字节回复携带稳定对象 ID 和物理 lower 的固定 size。guest 为这个对象使用独立 data inode/mapping,使关闭再打开的 lower fd 可复用页面,同时让 copy-up 后 upper 写入与截断不改变旧 lower 页和 EOF。普通 Core 解析、权限、策略、baseline 观察、native OPEN、每个 fd 的 FH 与 RELEASE 保留。资格限于显式 Immutable lower、固定只读本地 native FD、regular 且 nlink=1 等条件;upper、Mutable、多硬链接及不合格来源回退。每 owner 最多 4096 个 ID,已分配含义不回收重用;协商过该能力的 owner 暂拒绝快照捕获/恢复,默认开关仍为 0。该批未覆盖普通 CLI;普通 CLI 封存 rootfs 对照保持此能力关闭,该批当时未测量开启后的普通 CLI 性能,后续已由独立四臂对照计时。
真实 guest 开启组的 review-data、原 review-pages、review-flush、atime 分别为 25/25、4/4、11/11、36/36 通过;关闭组保留 data 的 17 个失败和原整页的 4 个失败,其他两个模式通过。这些是 case 结果,不是 21 个独立产品缺陷。受测范围包括 bound/unbound lower、整页与部分页写、截断/扩展、固定 EOF/SEEK_END、mmap/COW、关闭后映射、rename/unlink、sendfile/splice、切换 O_DIRECT 和回退路径。独立跨 fd 三次 open/read/close 的 READ 由关闭组 [1,1,1] 变为开启组 [1,0,0],两组 OPEN/RELEASE 均为 [1,1,1],提供实际关闭后复用的证据。旧 readonly MAP_SHARED 在 fd 关闭、upper copy-up 后 msync(MS_SYNC) 两组均成功;该结果只覆盖只读映射的调用,不扩展为可写共享映射的同步保证。
O_PATH 硬断言使用已核验的 raw openat 构造 fd:两组 F_GETFL 都保留 O_PATH,raw pread 均为 -1/EBADF。原 Rust OpenOptions::custom_flags(O_PATH) 在该 musl target 上因 O_ACCMODE 包含 O_PATH 而清位,实际得到普通只读 fd;其可读结果保留为构造诊断。修正打开方式后仍要求真实 O_PATH 与 EBADF,没有降低语义断言;前三次尝试的原始失败与来源保留。最终八个 VM 的 96 个注册实例均有恰一个 final,592 个 token 和 296 个同步区间完整。真实 guest 探针、探针来源与同步阶段记录完整证据,探针耗时不作为性能样本。
独立兼容诊断使用三个 fresh VM。新 host 配旧 0046 固件时,11 个 review-flush case 全通过,原 review-pages 四个基线失败保留,data 计数明确为 requested=1、enabled=0,且无对象标记;旧 host 配新 0047 固件时,11 个 review-flush case 全通过。两个方向的 FLUSH 探针结果与协议调用数一致。三次运行的 36 个注册实例均有恰一个 final record。旧 host 缺少新 data 计数器,JSON 保留 NULL、CSV 留空,不能当作实际开关为 0;其回退结论依据冻结旧 host 源码/制品及正常 legacy RPC,未声称已解码 INIT。兼容性结果与兼容性来源独立保存,探针时间不作为性能证据。
固定数据 EOF 尚未扩展到全部文件 API:旧 fd 的 fstat 仍可能取 namespace inode 属性;copy_file_range 的 VFS namespace-size 边界也未修复,其 16384 字节源在当前 namespace size=4105 时只复制 4105 字节,始终单列为观察,未计作完整复制通过。另有 19 个 short-read C 用例通过,执行的是从实际 kernel patch 提取的 helper、单 folio 与 readahead 回调,配合最小内核原语 stub;这支持提前短读返回错误、保持固定 EOF 的局部逻辑,不是完整 guest 内核的传输故障注入。并发压力、回收后的热页保留与快照仍需独立验证;普通CLI性能随后已由独立四臂对照计时,不构成完整语义验收。原始计时、计数与冻结证据分别保留在 benchmark/.data/dc17m/、benchmark/.data/dc17p/ 和 benchmark/.data/dc17/。
Linux:只读本地 FLUSH 消除
rg 三轮分别出现 17.55%、16.91%、17.22% 的改善信号;三轮七工具累计从 4315.230 ms 降至 3880.882 ms,下降 10.07%,95% CI [-0.97%, 12.84%],尚未检出整体收益;该批SDK/通用VM worker的缺省仍关闭,当前限定入口见自动FLUSH请求。 第一轮七工具合计下降 9.21%,区间未跨零;Ready 和第三轮 npm 未检出差异。结论只覆盖同条件的五个独立环境,不改写跨运行时用户表。
条件与正式计时
2026-10-17,B-FS-ENG 使用同一冻结 GNU host 和新增 0046 协议的固件,仅切换 PVISOR_VM_FS_READONLY_FLUSH_ELISION=0|1。两组均复用 owned Immutable rootfs/workspace 与 frozen baseline;目录 FD 容量 256,lower 负项缓存与 upper 不存在缓存关闭,WB=0、DAX=0、guest cache=1。Linux x86_64/KVM,guest 2 vCPU/16 GiB,沿用正常 PVisor、ManagedJob、stage/journal、VmExecutor 和 native runner,省略 CLI Host 服务;封存准备在时钟外。
每组五个 fresh VM,同轮 seeded 随机配对,每环境九操作三轮、无预热。十个正式环境全部通过正常退出、输出、工具缓存继承、Run Bundle、lower 隔离、全部写文件及流写字节校验,失败为零。没有安静期、干扰或全量清单门禁,保留全部有效慢样本。Ready 排除工具与退出,worker 时钟排除启动与退出;stream_write 保留操作自身的 fsync/close。三轮相关,独立样本数仍为每组五个。累计值先逐环境合计 21 个七工具 worker 时钟,再取中位数,不是完整任务墙钟。
下表为 ms 中位数;降幅为正表示更快。95% CI 使用五个环境块上的 5,000 次配对 bootstrap。
| 指标 | 关闭 | 开启 | 降幅 % | 95% CI % |
|---|---|---|---|---|
| Ready | 651.685 | 652.971 | -0.20 | [-8.47, 1.29] |
| 三轮七工具累计 | 4315.230 | 3880.882 | 10.07 | [-0.97, 12.84] |
| 第一轮七工具合计 | 2078.682 | 1887.289 | 9.21 | [7.45, 11.37] |
| 第二轮七工具合计 | 1141.847 | 1003.565 | 12.11 | [-12.96, 19.68] |
| 第三轮七工具合计 | 1099.857 | 1010.897 | 8.09 | [-8.35, 11.86] |
| 第一轮 rg | 304.416 | 250.993 | 17.55 | [16.27, 18.91] |
| 第二轮 rg | 298.962 | 248.401 | 16.91 | [14.91, 19.14] |
| 第三轮 rg | 299.662 | 248.057 | 17.22 | [15.94, 28.40] |
| 第三轮 npm | 475.724 | 477.645 | -0.40 | [-31.96, 12.00] |
完整统计、32 项配对比较与来源摘要保留完整精度、范围和逐环境值。逐项区间未校正多重比较,三个 rg 结果与各合计也不独立;N=5 不支持尾延迟或全面无退化保证。第一轮合计的信号不能替代三轮累计跨零的区间。 写入和 npm 各轮均未检出差异;写入出现较低和较高值,metadata/npm 也有明显波动。N=5 不足以建立正式分簇或精确归因,不以写入点估计宣称提速,也不事后剔除样本。
请求变化与正确性边界
独立 B-FS-DIAG 每组一个新环境,两组均有效。各 17 个注册实例均有唯一 final record,rootfs/workspace 的 216 个阶段组件区间及 54 个 token 完整;逐挂载实际协商值为该组的 0/1、容量 256,两项 Core 缓存均确认关闭。每个 owner 的启用计数表示其生命周期内成功协商过一次;该批为单会话 fresh VM。计数区间包含 checked() 子进程树启动、工具和原有校验,比 worker 时钟范围更大。
下表为第三轮计数,N=1/组;七工具合计仅汇总这七个阶段。
| 范围 / 请求或标记 | 关闭 | 开启 |
|---|---|---|
| rootfs 七工具 FLUSH | 1028 | 0 |
| rootfs 七工具 OPEN / READ / RELEASE | 1052 / 0 / 1052 | 1052 / 0 / 1052 |
| workspace 七工具 FLUSH | 2681 | 542 |
| workspace 七工具 OPEN / READ / RELEASE | 2681 / 2480 / 2682 | 2681 / 2480 / 2682 |
| rootfs npm FLUSH | 731 | 0 |
| workspace rg FLUSH | 2051 | 1 |
| workspace rg 合格 OPEN 标记 | 0 | 2050 |
| workspace write FLUSH | 513 | 513 |
rg 的 OPEN、READ、RELEASE 各 2051 次保持不变,说明候选减少的是合格只读句柄的 FLUSH 往返;write 阶段没有合格标记,原 513 次 FLUSH 保留。rootfs/workspace 的 Core parent+leaf 查询分别为 21652→21601、36962→36962,不能据此称全部 host 查询不变:开启时每个候选 OPEN 还以 native fstat、F_GETFL、fstatfs 检查资格,这些不属于 Core 查询计数。实际工具收益由正式配对时间判断;诊断 inclusive span 不相加,也不换算为精确 worker 耗时占比。逐工具计数及计数来源保留完整范围。
连接 bit 43 和每次 OPEN 的 bit 29 显式协商后,guest 仍执行 write_inode_now、fuse_sync_writes、filemap_check_errors 及错误返回,再省略 backend FLUSH;显式 fsync 与 RELEASE 不变。资格来自正常 OPEN 后固定的只读 native FD、Immutable lower 和本地文件系统白名单,不延长 TTL 或扩大 KEEP_CACHE。协商该能力的会话暂不支持快照捕获/恢复;去除内部 dup/close 也不提供逐资源 errno 等价保证。
真实 guest 的新固件关闭/开启及旧固件回退三组各 11 个 close case 全部通过;该探针 FLUSH 总数 15→6,其他协议调用数完全相同。ATIME 两组各 36 个 case 通过,请求掩码与缓存读的机制保持不变。已知整页旧 lower fd 检查在两组仍各 4 个失败,输出与已确认的页缓存对象隔离问题逐字相同,不能把它们当作本功能通过或扩大 workspace 数据页缓存的依据。独立探针与探针来源保留全部七次运行、84 个注册实例的唯一 final record。探针时间不进入正式性能分布。另一个独立的旧 host / 新固件兼容性运行通过 36 个 ATIME case,其协议调用数与新 host 关闭候选的对应观察相同,保留 FLUSH;反向兼容结果及来源单独保存。旧 host 没有新计数器,字段留空,不能解释为实际开关为 0。原始计时、计数与冻结证据分别保留在 benchmark/.data/lf17m/、benchmark/.data/lf17p/ 和 benchmark/.data/lf17/。
Linux:独占 upper 的物理不存在缓存
开启 upper 物理不存在缓存后,三轮七工具累计耗时从 4325.818 ms 变为 4321.941 ms,下降 0.09%,95% CI [-3.04%, 4.93%],未检出整体收益;该缓存继续默认关闭。 rootfs 第三轮物理查询下降 71.47%,但 workspace 查询增加,第三轮 rg 有 2.18% 的退化信号,不能宣称工具整体加速。
问题、条件与计时结果
Immutable lower 命中后,重复解析仍需验证 upper 的物理父链。显式独占 upper 契约允许在连续只读 epoch 内保留 MissingLeaf / UnavailableParent,工程对照检验这些重复查询是否构成当前工具等待的主要成本。
2026-10-17,B-FS-ENG 使用同一新 GNU 工程制品与 0045 固件,仅切换 PVISOR_VM_FS_EXCLUSIVE_UPPER_ABSENCE_CACHE=0/1。两组使用相同 owned Immutable rootfs/workspace generation,workspace 为 frozen baseline;目录 FD 缓存容量 256、lower 负缓存关闭、WB=0、DAX=0、guest cache=1,正式计时关闭 profiling。Linux x86_64/KVM、guest 2 vCPU/16 GiB,使用正常 PVisor、ManagedJob、stage/journal、VmExecutor 与 native runner;省略 CLI Host 服务,已有输入封存成本排除在时钟之外,不更新普通 CLI 用户表。
每组五个新环境,在固定种子的配对块内随机交替,每环境九操作三轮,无预热。十个环境全部通过正常退出、输出、缓存继承、Run Bundle、lower 隔离及完整写入和 stream 字节检查,零失败。没有干扰、安静期或全量清单门禁,保留所有有效慢样本。Ready 排除工具和退出;工具使用 worker 时钟,排除启动和退出,stream_write 保留其操作本身的 fsync/close。每环境三轮相关,独立样本数仍为五;三轮七工具累计先在每个环境内合计 21 次操作,再统计中位数,不代表完整任务墙钟。
下表为 ms 中位数;降幅为正表示更快,区间为五个环境块上 5,000 次配对 bootstrap 的 95% CI。
| 指标 | 关闭 upper 缓存 | 开启 upper 缓存 | 降幅 % | 95% CI % |
|---|---|---|---|---|
| Ready | 659.383 | 654.450 | 0.75 | [-0.41, 5.96] |
| 三轮七工具累计 | 4325.818 | 4321.941 | 0.09 | [-3.04, 4.93] |
| 第一轮七工具合计 | 2086.825 | 2061.889 | 1.19 | [0.45, 7.23] |
| 第二轮七工具合计 | 1129.029 | 1141.184 | -1.08 | [-10.31, 5.60] |
| 第三轮七工具合计 | 1081.312 | 1063.091 | 1.69 | [-4.10, 7.67] |
| 第一轮 npm | 764.821 | 702.667 | 8.13 | [0.54, 16.58] |
| 第三轮 rg | 297.383 | 303.871 | -2.18 | [-2.65, -1.23] |
第一轮合计和 npm 有改善信号,第三轮 rg 有退化信号;Ready、第二/三轮合计和三轮累计均未检出差异。32 项逐项比较未校正多重比较,N=5 不支持尾延迟或全面无退化保证。不能用第一轮改善替代整体结论。完整统计、配对区间和来源摘要保留全部操作、轮次和分布。
查询收益、实现额外工作与边界
独立 B-FS-DIAG 每组一个新环境,两次均有效。每组九操作三轮共 27 个阶段、54 个同步 token,rootfs/workspace 各四组件的阶段记录完整,各 17 个注册实例均有唯一 final record。实际容量逐挂载验证为 256,两个 Core 的实际开关均与该组的 0/1 设置一致。计数区间包含 checked() 子进程树的启动、工作和原有校验,比 worker 时钟范围更大;诊断时间不作为性能结果。
下表为第三轮七工具计数合计,N=1/组。Core 物理查询为 parent-stat 加 leaf-stat,缓存命中仅指 physical upper。
| 范围 / 计数 | 关闭 upper 缓存 | 开启 upper 缓存 |
|---|---|---|
| rootfs Core 物理查询 | 21652 | 6178 |
| rootfs upper 缺失命中 | 0 | 15475 |
| rootfs MissingLeaf / UnavailableParent 命中 | 0 / 0 | 2410 / 13065 |
| rootfs OPEN / READ | 1052 / 0 | 1052 / 0 |
| workspace Core 物理查询 | 36903 | 38661 |
| workspace upper 缺失命中 | 0 | 4748 |
| workspace MissingLeaf / UnavailableParent 命中 | 0 / 0 | 4414 / 334 |
| workspace upper-present miss | —(关闭) | 12444 |
| workspace OPEN / READ | 2681 / 2480 | 2681 / 2480 |
rootfs 减少 15474 次物理查询,workspace 增加 1758 次。启用分支为取得完整父证明,在 cache miss 上绕过同一次逻辑 walk 的短前缀复用;不缓存的 upper Entry 也走完整验证,因此 12444 次 upper-present miss 带来候选实现的额外路径工作。这些 present 查询包含已有 ancestor 目录,不能由其数量推断 rg 语料位于 upper;该语料和 payload 仍来自 sealed lower。计数揭示了未被该缓存消除的工作形状,未独立测量其耗时贡献,不能据此精确归因 rg 退化。开启组的缓存错误类 miss、容量 eviction 均为零,关闭组不执行缓存查询分类。逐工具计数与计数来源保留全部阶段、清空和分类记录;软件查询计数不等于磁盘 I/O 或精确时间分解。
缓存只在显式 upper 独占、目录权限及 root/物理祖先/mount 稳定契约下使用。每个独占 namespace 操作先禁用并清空,guard 退出再清空并恢复,覆盖失败、部分发布、快照和 teardown;与 upper 同路径、父子或符号链接别名重叠的 journal 拒绝启用。仅保留 physical upper 的 MissingLeaf、UnavailableParent 和完整成功父证明,不保存 Entry、错误、merged winner、策略、whiteout/opaque 或 journal 决策,也不改变 guest TTL 或数据页策略。Core/HOST 普通路径不推断这一契约,默认仍为 0。
lower 物理元数据缓存、guest 目录镜像资格、frozen baseline 的读观察省略和跨 OPEN 的数据页保留是不同机制。upper 缺失命中没有减少工作区的 2480 次 READ;Immutable workspace 的元数据资格也不自动提供安全的 KEEP_CACHE。进一步减少读取成本需要先隔离旧 lower FD 与新 upper FD 在同一个 guest inode 下的页缓存语义,再验证 workspace 数据页保留。当前证据不足以默认开启物理 upper 缓存,WB 同样继续关闭。原始计时与诊断分别在 benchmark/.data/uc17m/、benchmark/.data/uc17p/,冻结来源、harness 和分析在 benchmark/.data/uc17/。
Linux:属性 TTL 候选被拒绝与页缓存对象隔离
仅延长 Immutable regular lower 属性 TTL 的候选因 hardlink 源的 nlink 陈旧被拒绝并撤除,正式性能样本为 0。 2026-10-17 的独立 B-FS-DIAG 使用同一冻结 host、guest 探针和 0045 固件,仅切换候选开关;WB=0、DAX=0。保留的只读 fd 先用 AT_EMPTY_PATH|AT_STATX_FORCE_SYNC 预热属性,执行 link(a,b),等待 1.1 秒越过普通 TTL,再直接在同一 fd 上查询,期间不做路径 stat。关闭候选时普通查询与强制同步都返回 nlink=2;开启时普通查询仍为 1,强制同步为 2。这证明候选没有完整覆盖 hardlink 源属性的失效,不能据此宣称 GETATTR 减少或工具加速。冻结旧开关不再作为当前产品配置。 原探针将这个 case 命名为 link-opath,但当前 musl 的 O_ACCMODE 包含 O_PATH,Rust OpenOptions::custom_flags 会清除此位,因此实际保留的是普通只读 fd;这些结果不证明 O_PATH 行为。数据映射探针的原始 openat、F_GETFL 和 EBADF 对照已确认该构造差异,历史原始输出保留。
| 独立诊断 | 候选关闭 | 候选开启 | 已确认的范围 |
|---|---|---|---|
| 只读 fd 的 hardlink 源:普通 / 强制同步 nlink | 2 / 2 | 1 / 2 | 候选新增属性陈旧 |
| 旧 lower fd:整页写后完整内容检查 | 4/4 失败 | 4/4 失败 | 已有页缓存对象隔离不足 |
| ATIME 请求掩码与属性检查 | 36/36 通过 | 36/36 通过 | 单独的属性诊断通过 |
整页探针在 Immutable root lower 上打开旧只读 fd,再由可写 fd 触发 copy-up,以 pwrite 在 offset 0 写入 4 KiB 或 8 KiB;旧 fd 在可写 OPEN 前已显式绑定或仍为延迟绑定,形成四个独立 case;后者仍须经过 mutation drain。使用同一可写 fd 交替读取 upper,先检查旧 fd,每次核对完整 16 KiB。两种开关下,四个 case 的旧 fd 都在首字节出现内容差异,upper 内容校验没有报告差异。这确认既有 guest 共享 inode/page-cache 路径不能完整隔离原 lower 对象与新 upper 对象,问题已存在于候选关闭时。扩大 workspace KEEP_CACHE 前须解决这一对象隔离边界;这些结果不覆盖 mmap、并发、其他 offset 或所有挂载类型。
ATIME 两组各 36 个 case 通过,不提供性能结论,也不能抵消上述失败。其余 review-attrs 断言保留为待单独审查的原始诊断;粗略失败数量不等于独立产品缺陷数。原始输出和拒绝决定保存在 benchmark/.data/ac17/probes/ 与 decision.json,冻结候选源码、二进制和固件身份一并保留。12 行决定性证据及来源摘要仅整理上述八个整页 case、两个保留 fd 的属性结果及两条 ATIME 汇总。
Linux:Immutable 物理 lower 负项缓存
开启负项缓存后,三轮七工具累计耗时从 4380.075 ms 变为 4304.291 ms,下降 1.73%,95% CI [-4.91%, 4.18%],未检出整体收益;负项缓存仍默认关闭。 独立诊断中,第三轮 rootfs 的 Core 物理查询减少 20.47%,证明机制消除了重复不存在项查询,但没有建立工具加速结论。
问题、条件与时间结果
重复解析中,Immutable lower 上已确认不存在的叶子仍会触发物理查询。工程对照检验保存这一结果能否减少 Ready 和驻留工具的等待,同时保持 upper、其他 lower、权限与 journal 语义。
2026-10-17,B-FS-ENG 在同一新 GNU 工程制品与 0045 固件上,仅切换 PVISOR_IMMUTABLE_LOWER_NEGATIVE_CACHE=0/1。两组使用相同的真实 owned Immutable rootfs 和 workspace generation,workspace 保持 frozen baseline;目录 FD 缓存容量均为 256,WB=0、DAX=0、guest cache=1,正式计时关闭 profiling。Linux x86_64/KVM、guest 2 vCPU/16 GiB,使用正常 PVisor、ManagedJob、stage/journal、VmExecutor 与 native runner,省略 CLI Host 服务。已有封存输入的准备排除在计时之外,结果不改写普通 CLI 用户表。
每组五个新环境,固定种子在配对块内随机交替,每环境运行九操作三轮,无预热。十个环境全部通过输出、缓存继承、Run Bundle、lower 隔离、全部写入和 stream 字节及正常退出校验,无失败。无干扰、安静期或全量清单门禁,保留全部有效慢样本。Ready 截止唯一就绪输出,排除工具和退出;工具使用 worker 时钟,排除启动和退出,stream_write 保留操作本身的 fsync/close。三轮相互关联,独立样本数为每组五个环境;七工具累计先逐环境合计 21 次操作,再统计中位数,不代表完整任务墙钟。
下表为 ms 中位数;降幅为正表示更快,区间为五个环境块上 5,000 次配对 bootstrap 的 95% CI。
| 指标 | 关闭负项缓存 | 开启负项缓存 | 降幅 % | 95% CI % |
|---|---|---|---|---|
| Ready | 656.562 | 652.746 | 0.58 | [-0.62, 0.95] |
| 三轮七工具累计 | 4380.075 | 4304.291 | 1.73 | [-4.91, 4.18] |
| 第一轮七工具合计 | 2106.067 | 2107.373 | -0.06 | [-7.14, 5.96] |
| 第二轮七工具合计 | 1136.160 | 1115.354 | 1.83 | [-7.60, 4.49] |
| 第三轮七工具合计 | 1127.554 | 1108.215 | 1.72 | [-13.52, 10.31] |
Ready、九操作各三轮、三个分轮合计和三轮累计,共 32 项比较的区间均跨零,未检出单项或整体差异。逐项区间未校正多重比较;N=5 不支持尾延迟或全面无退化保证。完整统计、配对区间和来源摘要保留逐工具分布与完整精度。
查询变化与优化边界
独立 B-FS-DIAG 每组一个新环境,两次均有效。每组覆盖九操作三轮的 27 个阶段、54 个同步 token;rootfs/workspace 四组件的阶段记录完整,各 17 个注册实例均有唯一 final record。实际容量逐挂载核对为 256,每组两个 Core 的实际负项开关均与该组的 0/1 设置一致。计数区间包含 checked() 子进程树的启动、工作和原有校验,比 worker 时钟范围更大;插桩时间不作为性能数据。
下表为第三轮七工具计数总和,N=1/组。物理查询为 Core parent-stat 与 leaf-stat 之和。
| 范围 / 计数 | 关闭负项缓存 | 开启负项缓存 |
|---|---|---|
| rootfs Core 物理查询 | 21652 | 17220 |
| rootfs MissingLeaf miss | 674 | 0 |
| rootfs 负项命中 | 0 | 674 |
| rootfs OPEN / READ | 1052 / 0 | 1052 / 0 |
| workspace Core 物理查询 | 37861 | 38323 |
| workspace MissingLeaf miss | 2 | 0 |
| workspace 负项命中 | 0 | 2 |
| workspace UnavailableParent miss | 8 | 8 |
| workspace OPEN / READ | 2681 / 2480 | 2681 / 2480 |
rootfs 的 674 次重复 MissingLeaf 查询变为负项命中,物理查询减少 4432 次;workspace 只替代两次 MissingLeaf,八次父目录不可用仍重新查询。两组错误类 miss 均为零。工作区的物理查询没有下降,实际 OPEN/READ 也保持不变。软件查询计数不等于磁盘 I/O,不能换算为精确耗时或解释全部工具差异。逐工具计数与计数来源保留完整阶段和实例覆盖。
该机制只保存 eligible Immutable 物理 lower 的 MissingLeaf 与完整父身份;upper、whiteout、opaque、其他 lower、访问策略和读观察仍逐次检查。它不保存错误、UnavailableParent 或合并视图不存在,也不延长 guest 的负 dentry TTL。正负项共用原有 4096 项上限和清空淘汰策略。只有 namespace、祖先、挂载身份和 hardlink 别名在 owner 生命周期内真正稳定的 lower 才能使用;普通目录、只读挂载和 frozen baseline 本身不构成资格。未设置或设为 0 保持关闭。
后续优化须先处理已确认的页缓存对象隔离边界,并减少保留真实对象绑定的 OPEN 路径重复工作。属性 TTL 候选已因 hardlink nlink 陈旧被拒绝并撤除,正式性能样本为 0。负缓存的计数收益不足以支持默认开启;WB 继续关闭,unlink 后最终 syncfs 的 ENOENT 问题未由此修复。原始计时与诊断分别在 benchmark/.data/nc17m/、benchmark/.data/nc17p/,冻结来源、harness 和分析在 benchmark/.data/nc17/。
Linux:目录 FD 缓存容量与 ATIME 属性失效
将目录 FD 缓存从 256 扩至 1024,三轮七工具累计耗时从 4279.878 ms 变为 4267.253 ms,下降 0.29%,95% CI [-0.91%, 1.89%],未检出整体收益,默认容量保留 256。 rootfs 的热目录缓存 miss 和 eviction 虽然消失,Core 的物理查询几乎不变;独立 ATIME 探针进一步区分了读数据与请求属性的作用。
条件与时间结果
2026-10-17,B-FS-ENG 在同一个冻结 GNU 工程制品与 0045 固件上,仅切换目录 FD 缓存容量 256 / 1024。两组 rootfs 和 workspace 均为真实 owned Immutable,workspace 使用 frozen baseline;WB=0、DAX=0、guest cache=1。沿用正常 PVisor、ManagedJob、stage/journal、VmExecutor 与 native runner,省略 CLI Host 服务,因此 Ready 不与普通 CLI 用户表跨批比较。封存输入复用已有 generation,准备成本不计入 Ready 或工具时钟。
每组五个新环境,同轮 seeded 随机交替,每环境运行原九操作三轮。十个正式环境全部通过正常退出、输出、缓存继承、Run Bundle、lower 隔离和全部写入字节校验;无干扰、安静期或全量清单门禁,保留全部有效慢样本。Ready 排除工具和退出,工具使用 worker 时钟;三轮七工具累计先在每个环境内合计 21 次操作,再取中位数,独立样本数仍为五。
下表为 ms 中位数;降幅为正表示更快,区间为 5,000 次配对 bootstrap 的 95% CI。
| 指标 | 容量 256 | 容量 1024 | 降幅 % | 95% CI % |
|---|---|---|---|---|
| Ready | 653.418 | 652.628 | 0.12 | [-0.62, 5.38] |
| 三轮七工具累计 | 4279.878 | 4267.253 | 0.29 | [-0.91, 1.89] |
| 第一轮 npm | 751.310 | 674.267 | 10.25 | [1.63, 11.91] |
第一轮 npm 有改善信号,Ready 与整体累计均未检出差异。32 项逐项比较未校正多重比较,N=5 不支持尾延迟结论;该单项信号尚不足以支持默认扩容。完整统计、配对区间和来源摘要保留各操作与轮次。
计数与后续优化范围
独立 B-FS-DIAG 每容量一个新环境,两次均有效,rootfs/workspace 的四组件阶段记录与全部注册实例 final record 完整。第三轮七工具合计中,rootfs 目录 FD cache miss 和 eviction 均从 252 降为 0,Core parent-stat 加 leaf-stat 仅从 21,653 变为 21,652。减少原生目录句柄的重建没有同步消除 Core 的路径验证,不能由 cache miss 的降幅推导工具加速比。
两种容量下,rootfs 的 674 次 Immutable cache miss 全部是物理 lower 叶子不存在,错误类为 0;workspace 为 2 次叶子不存在和 8 次父目录不可用,错误类同样为 0。这些分类限定了后续调查对象。独立负项缓存对照已减少重复 MissingLeaf 查询,尚未检出工具累计耗时收益;upper、whiteout 与合并命名空间的检查仍需保留。逐工具计数和计数来源区分阶段边界与完整实例覆盖,软件查询计数不代表磁盘 I/O 或精确时间归因。
read→statx 的 ATIME 因果诊断
现有固件的独立 SDK 探针对 root lower、root upper、Immutable share lower 和 Mutable share lower,分别请求 SIZE|MTIME、ATIME、BASIC_STATS。每次先以 AT_STATX_FORCE_SYNC 刷新基本属性,再比较不读、首次读和同 fd 的缓存读;prime、read、首次 stat、重复 stat 分别用同步 ioctl 包围。36 个 case、144 个阶段和 288 个 token 全部完整,三设备各四组件共 12 个注册实例均有唯一 final record;没有 sleep。
| 数据访问与后续请求 | case 数 | 读阶段宿主 OPEN / READ | 首次 stat 的 GETATTR |
|---|---|---|---|
| 不读,任意三种 mask | 12 | 0 / 0 | 0 |
| 首次读,再请求 SIZE/MTIME | 4 | 4 / 4 | 0 |
| 首次读,再请求 ATIME/BASIC | 8 | 8 / 8 | 8 |
| 同 fd 缓存读,任意三种 mask | 12 | 0 / 0 | 0 |
36 次强制 prime 各产生一次 GETATTR,36 次紧接的重复 stat 均不产生 GETATTR。prime 到首次查询仅 2.535–4.834 ms,远小于普通属性的 1 秒期限;八次 ATIME/BASIC 查询均观察到访问时间变化。结果支持实际宿主 READ 后选择性失效 ATIME,同 fd 的页缓存命中没有再次触发该失效;它不说明所有 GETATTR 都由 ATIME 引起。插桩 syscall 时长与 inclusive span 均不作为性能结果。case 与计数 CSV、诊断来源保留完整边界;原始时间、计数与探针来源分别在 benchmark/.data/fc17m/、benchmark/.data/fc17p/ 和 benchmark/.data/fc17/。
Linux:封存输入接通缓存后的四组对照
封存 rootfs 接通 Immutable 缓存资格后,第三轮七工具合计从 1581.62 ms 降至 1173.57 ms,下降 25.80%;同时启用工作区快照为 1267.91 ms,下降 19.83%。工作区单独处理在第三轮合计未检出差异,七工具合计尚未达到两倍加速。 rootfs 数据缓存已减少实际 READ;工作区的 metadata 优化保留了真实读取与文件打开成本。
条件与计时范围
B-FS-ENG 使用同一冻结 GNU 工程制品和 0045 固件,经正常 PVisor、ManagedJob、stage/journal、VmExecutor 与 native runner 执行。入口省略 CLI Host 服务;普通 CLI 默认输入尚未自动取得这些所有权和缓存资格。Linux x86_64/KVM,guest 2 vCPU/16 GiB,整父组 CPU 0,1、两核 quota、16 GiB、swap 0,热宿主输入、独立 upper、Job、工作区和任务工具缓存。WB=0、DAX=0、guest cache=1,正式计时关闭 profiling。
四组 rootfs 共用一个真实导入并封存的物理目录,只切换 Mutable / Immutable 声明。基线和 rootfs-only 的工作区使用独立 live Mutable 拷贝;workspace-only 和两者启用组使用初始字节相同的 sealed snapshot、frozen baseline 和 Immutable lower,apply target 仍是独立 trial 工作区。因此工作区对照同时改变缓存资格及读观察/journal 工作,属于联合处理。SnapshotBase 从可信 store 认证 generation,并持有覆盖 Job 和 native teardown 的 lease;运行后保留 store,没有额外创建持久 pin。一次导入与封存准备为 51.048 秒,独立于 Ready 和工具计时。
每组五个新环境,同轮 seeded 随机交替,每环境执行九操作三轮,共 20 个有效环境、零失败。Ready 结束于唯一就绪输出,排除工具和退出;各工具使用 worker 时钟,stream_write 保留显式 fsync/close。正常退出、工具输出、缓存继承、Run Bundle、lower 隔离、256 文件和三份 stream 完整字节均校验。无安静期、干扰监控或全量清单门禁,保留全部慢有效样本。三轮相关,统计独立单位仍是五个环境。
时间结果
单位 ms,中位数,每条件 N=5。七工具先在每个环境每轮求和,再求中位数。
| 指标 | 基线 | 封存 rootfs | 快照 workspace | 两者启用 |
|---|---|---|---|---|
| Ready | 679.46 | 659.22 | 665.09 | 652.77 |
| 七工具合计,第 1 轮 | 2448.27 | 2479.10 | 2325.91 | 2009.04 |
| 七工具合计,第 2 轮 | 1955.95 | 1348.25 | 1470.78 | 1432.07 |
| 七工具合计,第 3 轮 | 1581.62 | 1173.57 | 1545.61 | 1267.91 |
以下降幅为正表示更快,95% CI 使用 5,000 次五环境配对 bootstrap:第三轮 rootfs 为 25.80% [10.27%, 45.13%],两者启用为 19.83% [1.07%, 56.33%],workspace-only 为 2.28% [-5.29%, 44.11%],后者未检出差异。第一轮两者启用下降 17.94% [13.87%, 33.87%]。Ready 的 rootfs 与两者启用分别下降 2.98% [2.02%, 29.88%]、3.93% [1.99%, 40.32%];workspace-only 区间跨零。基线 Ready 保留 1093.86 ms 的慢样本,第三轮七工具保留 2903.71 ms 的慢样本,区间较宽。N=5 不支持尾延迟结论;93 项单独比较未作多重比较校正。
第三轮七项工具分别如下;各行中位数之和不等于逐环境合计的中位数。
| 第三轮工具 | 基线 | 封存 rootfs | 快照 workspace | 两者启用 |
|---|---|---|---|---|
| 遍历 2048 文件 | 138.23 | 164.51 | 121.75 | 137.17 |
| 读取并校验 64 MiB | 82.90 | 32.93 | 83.34 | 79.71 |
| 覆盖写入 256 文件 | 118.57 | 84.65 | 130.81 | 153.37 |
| git status | 35.31 | 24.99 | 14.66 | 8.23 |
| rg 搜索 | 348.42 | 327.20 | 323.56 | 299.50 |
| Cargo 增量编译 | 34.14 | 20.64 | 33.04 | 19.72 |
| npm 安装检查 | 767.75 | 548.32 | 788.16 | 536.36 |
两者启用时,npm、Cargo、git、rg 分别下降 30.14%、42.23%、76.68%、14.04%,各自区间未跨零;遍历、读取、写入未检出差异。热 open 和 stream_write 各组区间也跨零。组合处理尚未证明优于只启用 rootfs,不能据总和中位数高低断言哪组更优。四组统计、配对区间和来源摘要保留完整数值与范围。
请求证据与剩余机会
独立 B-FS-DIAG 每组一个新环境,覆盖九操作三轮的 27 阶段、54 个 token;每个 token 对 rootfs/workspace 同步 checkpoint。四组分别有 13/13/17/17 个注册实例,全部有 final record,两挂载各组件阶段完整。计数区间覆盖 checked() 子进程树启动、操作及原有校验,范围大于 worker 时钟;不将插桩耗时用于性能结论。
下表为第三轮七工具合计。Core 物理查询为 parent-stat 与 leaf-stat 的 units 之和,属于软件查询计数,不能当作磁盘 I/O 或精确耗时归因。
| scope / 计数 | 基线 | 封存 rootfs | 快照 workspace | 两者启用 |
|---|---|---|---|---|
| rootfs OPEN | 1052 | 1052 | 1052 | 1052 |
| rootfs READ | 1475 | 0 | 1475 | 0 |
| rootfs LOOKUP | 3656 | 948 | 3618 | 948 |
| rootfs Core 物理查询 | 99828 | 21653 | 99679 | 21807 |
| workspace OPEN | 2681 | 2681 | 2681 | 2681 |
| workspace READ | 2480 | 2480 | 2480 | 2480 |
| workspace LOOKUP | 2102 | 2084 | 306 | 306 |
| workspace Core 物理查询 | 91327 | 91160 | 38745 | 36962 |
rootfs 的 READ 消失而 OPEN 保持,支持数据页复用生效、真实读取仍需对象绑定。工作区 LOOKUP 和物理查询下降,但 OPEN/READ 完全不变,解释了它没有兑现全面工具收益。第三轮 READINDEX 为零不能推出目录镜像没有使用:导入发生在更早阶段。三轮七工具的 workspace 指纹计算从基线 2156 次、69,375,691 字节降到快照条件 1 次、0 字节,进一步表明工作区结果包含 frozen-baseline 免除读观察成本的作用。逐阶段计数和计数来源保留范围与完整覆盖证据。
该批当时尚未覆盖普通CLI;后续真实rootfs所有权、workspace快照和数据/FLUSH组合已分别由prepared-rootfs、prepared-workspace与四臂对照独立计时,保留lease、stage/apply及外部修改边界,并不构成完整语义验收。该批 KEEP_CACHE 主要限于 root 设备,Immutable workspace 的 metadata 资格没有自动带来同等数据缓存;后续独立数据页协议另行测量对象隔离与页面复用,默认仍关闭。普通 OPEN 的检查和绑定成本继续保留。WB 始终关闭,unlink 后最终 syncfs 的 ENOENT 尚未修复;这些结果不构成开启写合并的依据。原始时间和诊断分别保留 benchmark/.data/oc16m/、benchmark/.data/oc16p/,准备、制品、harness 与分析在 benchmark/.data/oc16/。
Linux:guest 生命周期修补的快速复测
0045 修补解决了已复现的 deferred-open 串读与 poll 错误掩码,尚未显示整体性能提升。 Ready 和三轮七工具合计的区间均跨过零;第三轮 npm 有回退信号。写合并开启的普通 CLI 在两版固件中都遇到 unlink 后最终同步 ENOENT,该组没有有效性能结论。
动机与实验设计
确认目录镜像、延迟 OPEN 和批量写回遵循原有 lookup、对象绑定及最终 RELEASE 生命周期后,测量修补的成本。0045 复用原生 READDIRPLUS 的 parallel lookup/alias-splicing;普通文件 mutation 从排空 pending open 到 host 回复持续阻止新 deferred-open 发布;补齐时间戳、xattr 与 hard-link 的绑定点;队列最后引用保留 auto-submount 同步 RELEASE;poll 绑定失败返回 EPOLLERR。独立的 host profile 注册补丁补全诊断实例核对。
B-FS-ENG 批次 flife16b 固定同一个当前 GNU release/gateway host,SHA256 0bc3de591c8444d74b8b67a409bab17dc8712311e81477d42d0281469f8678f0,只切换最终 0044 与追加 0045 的固件。两版均启用 guest cache、关闭写合并和 DAX、关闭 profiling。Linux x86_64/KVM,CPU 0,1、整父组两核 quota / 16 GiB / swap 0;CLI guest 2 vCPU/16 GiB、Btrfs workspace,独立 SDK guest 2 vCPU/512 MiB、私有 tmpfs fixture/upper,SDK 使用显式 Immutable share、无 journal。两种 cohort 分开统计。
每版各五个 CLI 和五个 SDK 新环境,同轮随机交替、seed 20261016,无额外预热;每环境内部三轮。CLI 使用同样九操作、工具缓存、完整字节/Bundle/lower 隔离校验;SDK 执行 256 路径 stat、300 子目录扫描和 10,000 次 open/fstat/close,校验固定数量/大小及退出。启动只计唯一 Ready,操作时钟排除启动和退出;七工具先在每环境每轮求和,再计算中位数。20 个环境全部有效,零失败;不设干扰或全量清单门禁,不剔除有效慢样本。普通 Mutable CLI 不代表目录镜像命中。
数据与分析
下表为中位数,负变化表示更快;区间为 5,000 次配对 bootstrap,按五个独立环境索引重采样。三轮不是十五个独立样本。49 项完整结果、范围和逐次值保存在本地加工 CSV,制品和失败来源保存在同批来源 CSV。单项区间未校正多重比较,N=5 只作快速观察,不给尾延迟或整体性能无回退保证。
| 指标 | 轮次 | 0044 ms | 0045 ms | 变化 | 95% CI % |
|---|---|---|---|---|---|
| CLI Ready | — | 761.446 | 724.310 | -4.88% | [-32.23, +2.42] |
| CLI 七工具合计 | 1 | 3085.999 | 3055.917 | -0.97% | [-24.78, +8.06] |
| CLI 七工具合计 | 2 | 1821.624 | 1793.154 | -1.56% | [-5.46, +7.92] |
| CLI 七工具合计 | 3 | 1696.279 | 1673.227 | -1.36% | [-3.61, +6.48] |
| CLI 热 open ×10,000 | 3 | 10.298 | 10.346 | +0.46% | [-13.86, +16.49] |
| CLI 8 MiB 流写+fsync/close | 3 | 467.809 | 489.954 | +4.73% | [-15.89, +8.95] |
| CLI npm | 3 | 866.880 | 890.301 | +2.70% | [+1.86, +10.90] |
| SDK stat ×256 | 1 | 4.452 | 4.402 | -1.11% | [-3.49, +4.41] |
| SDK 扫描 300 目录 | 1 | 31.887 | 29.767 | -6.65% | [-27.91, +5.89] |
| SDK 扫描 300 目录 | 3 | 0.174 | 0.171 | -1.66% | [-6.94, +8.23] |
| SDK stat ×256 | 2 | 0.153 | 0.187 | +22.32% | [+0.78, +26.96] |
| SDK 热 open ×10,000 | 3 | 5.089 | 5.047 | -0.84% | [-3.35, -0.01] |
49 个区间中 44 个跨过零。第三轮 npm 增加 23.42 ms(+2.70%);第二轮 SDK stat 增加 0.034 ms;第二、三轮 SDK 热 open 分别减少 0.067/0.043 ms;第二轮 stream close 减少 0.024 ms。保留这些双向变化,不据单项信号宣称稳定提速。Ready 基线中有 1148.71 ms 的有效慢样本,完整保留。
正确性证据与未解决路径
独立真实 guest 的 verified-current.json 共 27 个检查符合预期:时间戳、setxattr、removexattr、hard-link 在写合并关/开各四个失败,以及 poll 一个失败,共九个原固件失败用例,在 0045 均通过。原 reader 从错误的 modified 恢复为 original;poll 从多余事件位恢复为单独 POLLERR。full 的并发目录访问、别名、unlink、copy-up、partial image 和卸载检查通过;writeback 正常写入、背压、关闭/卸载及 EIO→125 故障注入通过。BDI 探针按实际挂载设备检查根和附加 share,保留原有 strict/max/min 断言。
计数器独立诊断覆盖 12 个启动时注册的 PID/component/instance,全部有 final record,包含 protocol、dispatch、overlay 和 Core 四类。Python 检查会拒绝丢失整实例、整 component 和非 final 的记录。原无注册日志仍只能作为 partial 证据。Rust Core 146 项、VM 417 项通过;诊断 Python 14 项、固件 bundle/ABI 2 项通过。未运行 KASAN 或长时间竞态/同连接 auto-submount 压测,普通并发/多挂载用例通过不能证明 P1 风险已无遗漏。目录 rename 递归 materialize 子树时,后代 deferred fd 的绑定仍需专项验证,当前 gate 只覆盖普通文件端点。
首批 flife16 的两版写合并开启条件均以 125 退出,错误为最终 workspace syncfs 的 ENOENT,整批未用于性能结论。最小诊断 flifediag16b 显示:目录 open 成功,已关闭文件 unlink 后的首次 syncfs 返回 ENOENT,第二次返回零;host 已移除 inode 路径且没有存活句柄,随后 ctime SETATTR 失败。该路径尚未修复。不能跳过错误或退回旧 supervisor 来获得有效时间。
原始来源保留 benchmark/.data/flife16b/report.json 及逐任务日志;benchmark/.data/fs-review-20261016/ 保存补丁、两版固件/来源、构建日志、冻结启动入口、derive.py 与正确性日志。复用 target 目录最初带入旧 guest supervisor 的尝试只保留为诊断;最终构建重新执行 VM build script,核验当前 supervisor 并重跑全部功能检查。结果不覆盖已有跨运行时用户表,不推断相对 main 的优化收益。
Linux:文件系统优化与写合并默认关闭的 N30 配对对照
独立 B-FS-ENG 批次 fof1,每臂 N=30、3 次预热。下表只归因于这次同条件版本及默认配置组合;不与筛选批次、历史开关实验或跨运行时用户批次合并。
基线为 SHA939 冻结构建,所选 C3 为 SHA884 冻结构建,包含队列热路径、handle lease 与 Linux 普通文件元数据路径优化,以及新 VM 写合并默认关闭。两臂均不设置 WRITEBACK/WORKERS 环境覆盖,基线采用自身默认开启,C3 采用自身默认关闭;因此只归因于代码与默认配置的组合。冻结源码、制品和固件身份保存在本地批次来源记录中。Linux/KVM/FUSE/Btrfs,热宿主缓存;每次新 VM、私有 user/mount/PID namespace、owned pivot_root、独立工作区与工具缓存,整父组 CPU 0,1、两核 quota、16 GiB、swap 0,guest 2 vCPU/16 GiB。每次新 Host listener 的启动计入完整任务,不能与 listener 复用的跨后端用户批次相减。每臂 3 次预热、30 个 seed 20261011 随机配对,60 正式任务及 6 预热全部通过七工具输出、256×64KiB 全字节、Run Bundle、宿主隔离、输入/制品/预算与外部干扰门禁。环境观察只证明可见进程 exec 时变量继承,不证明精确 FUSE INIT 协商;短暂、不可见或未识别干扰可能漏检。不开 profiling,不按速度剔除;此前 N5/N10 筛选只用于选定 C3,不进入这批样本或置信区间。
所选 C3(新 VM 写合并默认关)
| 指标 | 每臂 N | 基线 ms | 候选 ms | 变化 | 95% CI ms | 95% CI % | 结论 |
|---|---|---|---|---|---|---|---|
| 首条有效输出 Ready | 30 | 693.90 | 692.75 | -0.16% | [-5.30, +2.71] | [-0.76, +0.39] | 未检出差异 |
| 启动至完整结果 | 30 | 4333.52 | 4257.06 | -1.76% | [-285.78, -7.65] | [-6.29, -0.18] | 更快 |
| 启动至正常退出 | 30 | 4546.35 | 4467.53 | -1.73% | [-269.88, -9.92] | [-5.70, -0.22] | 更快 |
| 内部七工具总耗时 | 30 | 3641.73 | 3562.54 | -2.17% | [-284.47, -9.52] | [-7.39, -0.27] | 更快 |
| 遍历 2,048 文件 | 30 | 149.13 | 132.08 | -11.43% | [-36.77, +9.16] | [-23.74, +6.36] | 未检出差异 |
| 读取并校验 64 MiB | 30 | 114.58 | 115.66 | +0.95% | [-0.43, +5.00] | [-0.37, +4.38] | 未检出差异 |
| 写入 256 文件 | 30 | 159.77 | 137.11 | -14.19% | [-28.72, -14.98] | [-17.58, -9.82] | 更快 |
| git status | 30 | 381.61 (n=22); 770.02 (n=8) | 369.18 (n=24); 736.44 (n=6) | — | — | — | 分离簇,不作整体排名 |
| Ripgrep 搜索 | 30 | 422.94 | 424.78 | +0.43% | [-5.80, +9.07] | [-1.36, +2.18] | 未检出差异 |
| 离线 Cargo 编译 | 30 | 484.65 | 482.34 | -0.48% | [-6.58, +4.43] | [-1.35, +0.92] | 未检出差异 |
| 离线 npm 安装 | 30 | 937.03 | 920.09 | -1.81% | [-34.38, -0.98] | [-3.63, -0.10] | 更快 |
单位 ms;负变化表示耗时下降。区间来自同批 5,000 次配对 bootstrap;有效慢样本保留,分离簇不报告整体 P50、百分比或排名,不报告 P95/P99。
同批完整精度 CSV 与制品、配置和来源记录保存在本地批次或归档中;原始证据为 benchmark/.data/fof1/report.json,验收为 benchmark/.data/fof1/derived/audit.json。
Linux:关闭 guest 写合并的配对对照
关闭写合并使 256 × 64 KiB 写入从 162.10 ms 降至 131.61 ms,减少 18.81%,95% CI [-25.06%, -12.87%]。 完整任务和内部七工具总耗时均未检出差异;rg 和 Cargo 分别增加 1.82%、1.08%,Git 与关闭组 npm 呈分离簇。因此关闭写合并的收益仅能归于这组写入负载。
对照与计时边界
B-FS-ENG 使用同一个冻结 GNU release/gateway 制品,SHA256 为 ae221676e4bb04231c88f2ce17c2570824f4064f8a3a63d6ef32817b0e2afa98,包含直接队列服务、重操作 stealing 和局部 I/O 屏障。两组仅将宿主 runner 的 PVISOR_VM_FS_WRITEBACK 设为 1 / 0,原环境由专用 worker 恢复并核对;相同固件、七工具负载、输入、工作区与工具缓存策略,rootfs/workspace 均无 DAX 窗口。
Linux/KVM/FUSE/Btrfs,热宿主缓存、每次新 VM、独立 user/mount/PID namespace 和 owned pivot_root。整父组 CPU 0,1、两核 quota、16 GiB、swap 0;guest 2 vCPU/16 GiB。输入和 namespace 准备不计时,新的 Host listener、VM 启动和退出计入完整任务;单项为原 workload 的内部时间,包含输出校验。profiling 关闭。
每臂 3 次预热、30 个固定种子随机配对轮次,共 60 次正式任务;66 次运行全部通过输出、正常退出、Run Bundle、宿主隔离及 256 个 upper 文件的完整字节检查,输入和制品摘要一致,无 OOM、0 失败、0 剔除。0.5 秒外部构建/测试扫描未检出干扰,可能漏掉短暂或不可见活动。5,000 次配对 bootstrap;有效慢样本保留,先检查分布,不报告 P95/P99。
七项操作与完整等待
单位 ms,每臂 N=30;变化为关闭相对开启,95% CI 为中位耗时差。分离分布展示每簇中位数与样本数,不给整体 P50、百分比或排名。
| 指标 | 写合并开 ms | 写合并关 ms | 变化 | 95% CI ms | 结论 |
|---|---|---|---|---|---|
| 首条有效输出 Ready | 696.95 | 694.99 | -0.28% | [-4.96, +2.39] | 未检出差异 |
| 启动至完整结果 | 4409.19 | 4363.77 | -1.03% | [-247.19, +262.05] | 未检出差异 |
| 启动至正常退出 | 4616.37 | 4564.87 | -1.12% | [-250.56, +271.96] | 未检出差异 |
| 内部七工具总耗时 | 3699.55 | 3660.70 | -1.05% | [-259.00, +263.60] | 未检出差异 |
| 遍历 2,048 文件 | 148.93 | 145.89 | -2.04% | [-26.36, +19.23] | 未检出差异 |
| 读取并校验 64 MiB | 114.83 | 116.22 | +1.21% | [-1.53, +2.47] | 未检出差异 |
| 写入 256 × 64 KiB | 162.10 | 131.61 | -18.81% | [-41.05, -20.17] | 更快 |
| git status | 391.26 (n=23); 759.78 (n=7) | 375.22 (n=21); 751.37 (n=9) | — | — | 分离分布,不作整体排名 |
| rg | 420.05 | 427.67 | +1.82% | [+1.09, +14.25] | 更慢 |
| 离线 Cargo 编译 | 485.05 | 490.29 | +1.08% | [+0.35, +12.54] | 更慢 |
| 离线 npm 安装 | 941.86 | 937.78 (n=22); 1661.33 (n=8) | — | — | 分离分布,不作整体排名 |
完整任务的中位数差为 -51.50 ms,95% CI [-250.56, +271.96] ms;内部总耗时差为 -38.86 ms,区间 [-259.00, +263.60] ms。写入改进没有转化为可检出的整体收益,也不能从这些时间推断 READ 请求数量或具体锁成本。Git 两组均分簇,关闭组 npm 也分簇,相关样本保留并单独展示。
完整统计 CSV 与制品、开关、预算和来源记录保存在本地批次或归档中。原始证据在 benchmark/.data/writeback-quick-20261011/,冻结 harness、执行与验收记录在 benchmark/pvisor/.data/writeback-ab-20261011/。该批实际每臂 N=30,独立于 N=10 的队列快速复测和只读 DAX 实验;该历史批次的开启/关闭条件不变;当前新 VM 的默认值以所选冻结源码为准。
Linux:不可变只读 share 的 DAX 配对对照
DAX 在这组负载上有明显取舍,不能作为默认加速方案。 64 MiB 双线程首次读取快 29.69%,顺序重复读取快 17.38%;顺序首次读取慢 8.72%,小文件重复读取慢 44.37%,64 MiB mmap 首次逐页访问慢 339.59%。metadata 未检出差异。测量范围是显式不可变 share,CLI 的可写 workspace 和启动、退出退化没有在此实验中复测。
对照与计时边界
B-FS-ENG 使用同一个冻结的 performance 制品(opt-level 3、Thin LTO),两组都调用公开 API immutable_filesystem 创建只读设备及 128 MiB DAX 窗口,仅 guest 挂载选项 dax=never / dax=inode 不同。每次 statx 都验证预期 DAX 属性,关闭组同时保留相同的设备和窗口配置。宿主为 Ryzen 7 9700X / Linux 7.2.8,guest 为 Linux 6.12.109;相同 Btrfs backing 和固件,宿主内容缓存预热,每次新 VM 和独占 rootfs upper/work。
完整 campaign 及 VM 使用 CPU 0,1 的继承 affinity、两核 quota、2 GiB memory.max、swap 0、65,536 FD 上限;guest 2 vCPU/512 MiB。用户 cgroup 没有 cpuset 控制器,实际 affinity/quota 在前后核验。计时期间不启用 profiling。每组 3 次预热,再执行预先平衡随机顺序的 30 对(共 60 次正式 VM);6 次预热与 60 次正式运行全部正确、正常退出。输入与制品前后摘要一致、无 OOM、0 失败、0 剔除;组外每 0.5 秒扫描一次,共 123 次,未检测到外部构建/测试,短暂或其他宿主活动仍可能漏检。
同一 guest 按 metadata → 小文件 → 顺序读取 → mmap → 双线程读取执行,各数据类使用独立文件,共享窗口及其回收状态。metadata 是 2,048 路径 stat;小文件是 128×64 KiB 的 open/read/close,其 2 MiB 映射槽需求超过窗口容量。大文件各 64 MiB:read 为已打开 FD 的 64 KiB pread;mmap 首次包括建立映射并每 4 KiB 读一个字节,重复访问保留映射;parallel 含创建和回收两个读取线程。全量内容验证在各阶段计时之外。首次文件数据访问不表示磁盘冷缓存或空 DAX 窗口。
guest CLOCK_MONOTONIC_RAW 记录阶段时间。重复 read/parallel 是 4 遍的每遍均值,mmap 是 16 遍的每遍均值,其余一遍;表中为这 30 个样本的中位数。CI 用 5,000 次配对 bootstrap,对每次重采样的两组中位数计算差值及百分比;区间跨零标为未检出差异。按预先登记的相邻间隙/簇大小规则未检出分离簇,有效慢样本全部保留,不报告 P95/P99。
同批结果
单位 ms;变化为 DAX 开相对关,正值表示更慢,95% CI 为百分比变化区间。
| 操作 | DAX 关 ms | DAX 开 ms | 变化 | 95% CI | 结论 |
|---|---|---|---|---|---|
| 2,048 路径 stat:首次 | 129.0957 | 130.0621 | +0.75% | [-8.33%, +11.32%] | 未检出差异 |
| 2,048 路径 stat:重复 | 0.9369 | 0.9690 | +3.43% | [-5.26%, +11.44%] | 未检出差异 |
| 128×64 KiB open/read/close:首次 | 40.2088 | 41.4687 | +3.13% | [-0.68%, +5.74%] | 未检出差异 |
| 128×64 KiB open/read/close:重复 | 25.3731 | 36.6306 | +44.37% | [+36.47%, +47.98%] | 更慢 |
| 64 MiB 顺序 pread:首次 | 60.6072 | 65.8917 | +8.72% | [+7.11%, +9.84%] | 更慢 |
| 64 MiB 顺序 pread:重复 | 5.5443 | 4.5805 | -17.38% | [-21.40%, -10.10%] | 更快 |
| 64 MiB mmap 逐页访问:首次 | 23.8292 | 104.7507 | +339.59% | [+328.77%, +352.40%] | 更慢 |
| 64 MiB mmap 逐页访问:重复 | 0.0964 | 0.1252 | +29.90% | [+27.00%, +33.71%] | 更慢 |
| 64 MiB 双线程 pread:首次 | 54.4338 | 38.2736 | -29.69% | [-32.16%, -28.25%] | 更快 |
| 64 MiB 双线程 pread:重复 | 4.7336 | 4.1625 | -12.07% | [-16.90%, +0.74%] | 未检出差异 |
首次 mmap 增加约 80.92 ms,而顺序热读取每遍减少约 0.96 ms,说明减少数据 READ 请求并不足以抵消当前首次访问成本。小文件的重复 open/read/close 也出现稳定退化。首次映射、逐页 fault、窗口回收及宿主映射竞争仍需要独立诊断;这些配对时间不能将差额全部归因于某一把锁或某一步。DAX 默认关闭,保留显式 opt-in;先定位首次 mmap 和窗口压力,再决定是否接入只读工具/镜像路径。实验关闭组仍预留窗口,不能将其成本当作普通无窗口设备的精确成本。
完整统计 CSV、来源与校验摘要保存在本地批次或归档中。入口与复现见仓库 benchmark/filesystem/README.md;原始日志、冻结源码和制品保存在本地 benchmark/filesystem/.data/dax-20261011-final/。该工程批次独立于七工具、跨运行时和历史启动数据。
Linux:直接队列服务与局部屏障,60 样本快速复测
调度修复呈现改善趋势,写入退化仍未解决。 相对上轮并发版,VM 的 rg、Cargo、npm 在本批分别快约 7.54%、4.10%、4.64%;内部总耗时下降约 2.71%,但区间跨零。相对先前优化版,写入仍慢约 32.40%。本轮每格仅 N=10,用于快速判断方向,不作为 30 次配对的正式性能验收。
修改与实验设计
队列线程直接等待和消费自己的 kick,取请求、执行和发布完成;普通请求不再由协调线程转发唤醒。stealing 只考虑重操作持续至少 2 ms 且有真实积压的普通队列,认领时在 ring 锁内复核,短 metadata 操作不会仅因 busy 被偷取。2 ms 是耗时启发式,不证明内核阻塞;控制线程每 2 ms 检查救援,队列线程空闲时无限期等待。
普通 I/O 在 handle map 和 admission 短锁下取得原生 Arc lease,不取得 namespace operation guard。namespace 仍串行,但只关闭相关文件、目录子树及已知对象别名的 handle admission,并等待对应 I/O;release 只等自身 handle。局部屏障保持到修改完成,失败也释放;等待时无关 handle 的新 I/O 仍能进入。快照、恢复、销毁继续使用全局 admission 屏障并排空全部 I/O。writeback 和宿主 FUSE dispatch 未改。
候选冻结 GNU release/gateway 制品 SHA256 为 ae221676e4bb04231c88f2ce17c2570824f4064f8a3a63d6ef32817b0e2afa98。同批参照为上轮并发 build2 和更早的 candidate6,后者是恢复参考,不是 cf8bfa5 的字面父提交。沿用原七项 workload、固件、完整工具输入与计时边界;Linux/KVM/FUSE/Btrfs,整父组 CPU 0,1、两核 quota、16 GiB、swap 0,VM 2 vCPU/16 GiB。每样本独立 namespace、pivot_root、工作区和工具缓存,热宿主缓存,新的 Host listener/VM 启动退出计入完整任务,输入和 namespace 准备不计时,profiling 关闭。
用户要求将 180 样本缩到 60:原批次取消并单独保留,新批次三个版本、两个后端各 3 次预热、10 个随机配对轮次,seed 20261010。60 个计时任务和 18 次预热全部通过原 workload、Run Bundle、隔离和 256 × 64 KiB upper 全字节检查,输入与制品前后校验一致,未检测到外部构建/测试干扰。0.5 s 检测可能漏掉短暂或不可见活动。有效慢样本全部保留,不报告 P95/P99;5,000 次配对 bootstrap 区间仅供探索。
快速结果与剩余问题
单位 ms,每臂 N=10;前版为同批并发制品,候选为直接队列制品。95% CI 是中位数差的探索区间,全部七项、内部总耗时、Ready/Result 和正常退出分别列出。
| 后端 | 指标 | 前版 ms | 候选 ms | 变化 | 95% CI ms | 结论 |
|---|---|---|---|---|---|---|
| staged | 首条有效输出 Ready | 218.77 | 217.92 | -0.39% | [-2.07, +2.81] | 未检出差异 |
| staged | 启动至完整结果 | 1432.62 | 1431.14 | -0.10% | [-9.49, +15.92] | 未检出差异 |
| staged | 启动至正常退出 | 1668.79 | 1667.37 | -0.09% | [-20.76, +28.91] | 未检出差异 |
| staged | 内部七工具总耗时 | 1213.94 | 1213.16 | -0.06% | [-7.08, +16.04] | 未检出差异 |
| staged | 遍历 2,048 文件 | 66.31 | 65.26 | -1.58% | [-1.32, -0.31] | 更快 |
| staged | 读取并校验 64 MiB | 68.04 | 68.75 | +1.03% | [-1.30, +4.92] | 未检出差异 |
| staged | 写入 256 × 64 KiB | 27.67 | 27.12 | -1.99% | [-1.64, +0.56] | 未检出差异 |
| staged | git status | 143.37 | 141.31 | -1.43% | [-5.07, +1.35] | 未检出差异 |
| staged | rg | 106.64 | 106.09 | -0.52% | [-1.78, +0.69] | 未检出差异 |
| staged | 离线 Cargo 编译 | 77.50 | 76.54 | -1.24% | [-1.90, +9.94] | 未检出差异 |
| staged | 离线 npm 安装 | 226.99 | 230.30 | +1.46% | [+0.62, +6.67] | 更慢 |
| VM | 首条有效输出 Ready | 691.96 | 693.36 | +0.20% | [-7.61, +5.32] | 未检出差异 |
| VM | 启动至完整结果 | 4408.21 | 4303.32 | -2.38% | [-198.58, +264.50] | 未检出差异 |
| VM | 启动至正常退出 | 4595.45 | 4484.43 | -2.42% | [-222.17, +248.70] | 未检出差异 |
| VM | 内部七工具总耗时 | 3707.29 | 3606.71 | -2.71% | [-200.10, +264.86] | 未检出差异 |
| VM | 遍历 2,048 文件 | 148.97 | 142.88 | -4.09% | [-34.00, +57.34] | 未检出差异 |
| VM | 读取并校验 64 MiB | 116.58 | 116.24 | -0.29% | [-5.80, +2.48] | 未检出差异 |
| VM | 写入 256 × 64 KiB | 153.00 | 157.08 | +2.67% | [-21.79, +28.41] | 未检出差异 |
| VM | git status | 404.51 | 387.07 | -4.31% | [-43.16, +362.83] | 未检出差异 |
| VM | rg | 453.05 | 418.87 | -7.54% | [-52.35, -19.30] | 更快 |
| VM | 离线 Cargo 编译 | 508.94 | 488.07 | -4.10% | [-30.01, -11.13] | 更快 |
| VM | 离线 npm 安装 | 975.21 | 929.92 | -4.64% | [-142.85, -34.51] | 更快 |
相对上轮并发版,VM 内部总耗时 P50 为 3707.29 → 3606.71 ms(-2.71%),差值区间 [-200.10, 264.86] ms;完整任务为 4595.45 → 4484.43 ms(-2.42%),区间 [-222.17, 248.70] ms。二者均跨零,不能宣称整体已恢复。
- rg 为 453.05 → 418.87 ms(-7.54%),差值探索区间 [-52.35, -19.30] ms。
- Cargo 为 508.94 → 488.07 ms(-4.10%),区间 [-30.01, -11.13] ms。
- npm 为 975.21 → 929.92 ms(-4.64%),区间 [-142.85, -34.51] ms。
- 写入为 153.00 → 157.08 ms(+2.67%),区间 [-21.79, 28.41] ms,未检出改善。metadata/read/Git 也未检出差异。
相对同批 candidate6,VM 内部总耗时为 3621.29 → 3606.71 ms(-0.40%),区间跨零;rg/npm 也未检出差异。写入为 118.64 → 157.08 ms(+32.40%),探索差值区间 [9.88, 63.74] ms,仍是未解决的重点。staged 内部总耗时为 1213.94 → 1213.16 ms,完整任务为 1668.79 → 1667.37 ms,均未检出差异;metadata/npm 的小样本变化不归因于未使用的 VM 执行改动。以上只比较本批三个版本,不与上轮中位数拼接,也不能拆分三项修复各自的贡献。
363 项 VM 库测试通过、8 项跳过,Clippy 全 targets 与 warnings-denied rustdoc 通过。回归验证直接 kick 与停止、短请求不偷取、长请求积压的原 ring 完成、同对象等待、无关 namespace 修改及等待期间新的无关 I/O admission;快照与生命周期测试保留。测量构建后仅将既有 cfg(test) device 测试移至文件末尾以满足 lint,生产实现一致。
快速统计、探索区间及制品、取消和来源记录保存在本地批次或归档中。原始证据在 benchmark/.data/direct-queue-quick-20261011/;源码冻结、构建、预检、取消批次、校验与静态检查记录在 benchmark/pvisor/.data/direct-queue-retest-20261011/。本轮不扩样、不更新跨运行时用户表;写入还需独立定位,未覆盖冷磁盘、并发吞吐或 macOS。
Linux:并发重构复测,2026-10-11
本轮未解决全部文件系统退化。 相对重构前制品,staged 完整七项任务下降约 5.00%,但操作内部总耗时未检出差异;VM 操作内部总耗时上升约 4.78%,写入、rg 与 npm 均有可检出的退化。多队列、专有服务线程和 handle lease 的实现不能代替性能验收。
动机与实验设计
本轮检验专用 hiprio 服务、多个普通队列及队列线程、直接执行和 pending descriptor stealing、staged guest writeback、leased I/O 与启动/退出清理改动能否恢复性能。候选是当前未提交源码的冻结 GNU release/gateway 构建 build2,SHA256 为 87ebb0658f2df6a84f9e4eca29c8d3d8bc01923817f04432780272c8b1b30309。同批另外两臂为此前 candidate6 和只撤销 65e65c93、09bd1d59 的回退控制;回退控制保留其余改动和默认 stage 同步,并非 cf8bfa5 的字面父提交。此处是版本比较,不能把差值全部归因于某一个优化。
Linux/KVM/FUSE/Btrfs,同一 firmware 和完整工具输入。整父组固定 CPU 0,1、两核 quota、16 GiB、swap 0;VM 为 2 vCPU、16 GiB。每臂、每后端 3 次预热、30 个随机配对轮次,seed 20261010;热宿主缓存,每样本新工作区、工具缓存、user/mount/PID namespace 和 owned pivot_root。namespace 与输入准备不计时,新的 Host listener、VM 启动与退出计入完整任务。使用原七项 reference workload 及其计时器,正式测量关闭 profiling,不是 hyperfine。
数据与分析
单位 ms,每臂 N=30;前版为同批重构前优化制品,候选为并发重构制品。95% CI 是中位数差;分离分布保留各簇中位数与样本数。
| 后端 | 指标 | 前版 ms | 候选 ms | 变化 | 95% CI ms | 结论 |
|---|---|---|---|---|---|---|
| staged | 首条有效输出 Ready | 229.99 | 219.25 | -4.67% | [-11.62, -9.23] | 更快 |
| staged | 启动至完整结果 | 1452.13 | 1424.04 | -1.93% | [-38.42, -8.24] | 更快 |
| staged | 启动至正常退出 | 1755.90 | 1668.16 | -5.00% | [-99.79, -66.71] | 更快 |
| staged | 内部七工具总耗时 | 1221.64 | 1204.69 | -1.39% | [-21.77, +0.03] | 未检出差异 |
| staged | 遍历 2,048 文件 | 66.75 | 66.35 | -0.60% | [-0.71, +0.03] | 未检出差异 |
| staged | 读取并校验 64 MiB | 67.20 | 67.62 | +0.62% | [-0.82, +1.47] | 未检出差异 |
| staged | 写入 256 × 64 KiB | 27.76 | 26.67 | -3.92% | [-1.84, -0.68] | 更快 |
| staged | git status | 142.65 | 141.87 | -0.54% | [-2.02, +1.26] | 未检出差异 |
| staged | rg | 107.21 | 107.58 | +0.34% | [-0.41, +1.26] | 未检出差异 |
| staged | 离线 Cargo 编译 | 71.79 | 70.61 | -1.64% | [-2.77, +0.59] | 未检出差异 |
| staged | 离线 npm 安装 | 230.26 | 230.26 | -0.00% | [-2.28, +2.13] | 未检出差异 |
| VM | 首条有效输出 Ready | 701.29 | 693.92 | -1.05% | [-15.10, +0.22] | 未检出差异 |
| VM | 启动至完整结果 | 4278.45 | 4446.60 | +3.93% | [+65.69, +210.06] | 更慢 |
| VM | 启动至正常退出 | 4535.76 | 4635.26 | +2.19% | [-1.90, +148.13] | 未检出差异 |
| VM | 内部七工具总耗时 | 3578.18 | 3749.07 | +4.78% | [+107.48, +210.48] | 更慢 |
| VM | 遍历 2,048 文件 | 157.80 | 138.86 | -12.00% | [-35.21, +1.45] | 未检出差异 |
| VM | 读取并校验 64 MiB | 117.67 | 116.86 | -0.69% | [-3.52, +0.19] | 未检出差异 |
| VM | 写入 256 × 64 KiB | 131.05 | 163.68 | +24.90% | [+15.38, +42.35] | 更慢 |
| VM | git status | 375.05 (n=24); 749.92 (n=6) | 399.04 (n=25); 798.60 (n=5) | — | — | 分离分布,不作整体排名 |
| VM | rg | 426.74 | 450.55 | +5.58% | [+16.56, +36.92] | 更慢 |
| VM | 离线 Cargo 编译 | 501.38 | 502.77 | +0.28% | [-6.34, +10.58] | 未检出差异 |
| VM | 离线 npm 安装 | 923.22 | 973.34 | +5.43% | [+31.98, +62.59] | 更慢 |
180 个正式任务、18 次预热均通过原任务、Run Bundle、隔离、upper 全部 256 × 64 KiB 文件的逐字节校验,完整输入清单前后相同。配对 CI 为 5,000 次同轮 bootstrap;慢有效样本全部保留,不报告 P99。相对 candidate6:
- staged 完整任务 P50 为 1755.90 → 1668.16 ms,差值 -87.74 ms,95% CI [-99.79, -66.71];操作内部总耗时为 1221.64 → 1204.69 ms,差值区间 [-21.77, 0.03] 跨零。写入约快 3.92%,其余操作未检出差异。
- VM 操作内部总耗时为 3578.18 → 3749.07 ms,差值 +170.89 ms,95% CI [107.48, 210.48]。写入为 131.05 → 163.68 ms(+24.90%),rg 为 426.74 → 450.55 ms(+5.58%),npm 为 923.22 → 973.34 ms(+5.43%),三项差值区间均未跨零;metadata、read、cargo 未检出差异。
- VM 完整任务为 4535.76 → 4635.26 ms,差值区间 [-1.90, 148.13] 跨零,不能用退出改善掩盖内部任务变慢。Git 两臂均呈分离簇:基线 24/6 次的簇中位数为 375.05/749.92 ms,候选 25/5 次为 399.04/798.60 ms,不作整体中位数排名。
- 相对同批回退控制,VM 内部任务仍慢 4.45%、写入慢 24.59%、rg 慢 6.17%、npm 慢 4.86%,这些差值区间均未跨零;staged 内部总耗时未检出差异。
首个正式批次因外部 Cargo 活动被拒绝,27 个已有样本单独保留;上面只使用新批次,0.5 s 外部构建/测试检测未检出干扰。检测可能漏掉短暂、不可见或未识别活动。初次 VM 预检还发现空队列检查与 guest 新 descriptor 发布之间的竞态,修复后重新冻结构建并通过预检;新增 5,000 次并发发布回归测试通过。相关库 633 项通过、19 项跳过,修复后 VM 库 361 项通过、8 项跳过;完整 CLI 集成测试有 Host listener/命名空间环境失败,不计作全套通过。
完整统计、配对区间及制品、控制范围和来源记录保存在本地批次或归档中;另见启动与退出复测。原始报告与逐次证据在 benchmark/.data/concurrency-formal2-20261011/,构建、失败批次和校验脚本在 benchmark/pvisor/.data/concurrency-retest-20261011/。这些工程数据不替换历史跨运行时用户表,不证明冷磁盘、并发吞吐或 macOS 性能;需要单独诊断 VM 写入/工具成本与 staged 启动波动。
Linux staged 的空闲请求调度
同条件工程 A/B 中,空闲请求调度修复使 staged 写入耗时下降 19.27%、Git 下降 12.78%、搜索下降 12.88%,完整七项任务下降 2.86%;读取与启动未检出差异。 结果只覆盖 Linux staged,不用于重算跨运行时用户表,也不代表 VM、macOS、冷磁盘或并发吞吐。
动机、实现与实验设计
复制期间的响应能力与日常工具成本需要一起评估。原调度把空闲时的短请求也交给 worker,增加线程切换。修复让无需 copy preparation 的修改在修改队列空闲时直接执行;读请求仅在两条队列都空闲时直接执行。至少 64 KiB 的 READ 保留 worker 路径,维持大块读的流水处理。有已接纳请求或复制正在准备时,读请求仍进入独立有界队列;inode pin、FIFO、容量限制与关闭排空继续生效。基线指纹、journal、持久化和隔离检查保持原有语义。
2026-10-10,Linux x86_64 / Fedora 7.2.8-200.fc44.x86_64 / Ryzen 7 9700X / Btrfs。两份 release 制品来自同一冻结源码,候选只改变宿主 dispatch 实现、私有测试及 API/README 说明。整组 CPU 固定 0,1、quota 两核、内存 16 GiB、swap 0;热宿主缓存、每次新工作区和独立工具缓存,Python 不读取 bytecode,Node 缓存启用。七项负载与 B-FS-TOOLS 相同,stage 同步使用默认串行。
每个样本使用独立 user/mount/PID namespace 与 owned pivot_root,工作区和 stage 绑定同一 Btrfs 存储。namespace、制品复制与输入准备不计时,新的 Host listener 启动计入完整任务;因此绝对时间不与用户页的跨运行时配置拼接。每组 3 次预热、30 个随机配对轮次,seed 20261010,正式计时不开 profiling,使用原 reference task timer,并非 hyperfine。60 个正式任务及 6 个预热全部通过输出、Run Bundle、宿主未写入与 upper 全部 256 个文件的逐字节校验,输入清单前后相同。外部每 0.5 s 检查同用户构建/测试,发现干扰则拒绝整批;本组未检出干扰,该检查可能漏掉短暂、不可见或未识别的活动。
工程结果与正确性边界
单位 ms,P50,每组 N=30;变化为候选相对基线,区间来自 5,000 次按同轮配对的 bootstrap。所有分布均未触发分离簇判据,不报告 P99。
| 指标 | 基线 ms | 修复 ms | 变化与 95% CI |
|---|---|---|---|
| 工具 Ready | 231.34 | 231.15 | -0.08% [-0.87%, +0.41%],未检出差异 |
| 完整七项任务与退出 | 1826.42 | 1774.15 | -2.86% [-3.57%, -1.22%] |
| 遍历 2,048 文件 | 67.69 | 66.88 | -1.20% [-1.99%, -0.81%] |
| 读取并校验 64 MiB | 72.05 | 70.12 | -2.68% [-6.31%, +4.80%],未检出差异 |
| 写入 256 文件 | 35.09 | 28.33 | -19.27% [-20.37%, -18.47%] |
| git status | 162.31 | 141.56 | -12.78% [-13.35%, -12.15%] |
| Ripgrep 搜索 | 122.74 | 106.93 | -12.88% [-13.50%, -12.17%] |
| 离线 Cargo 编译 | 79.37 | 77.06 | -2.92% [-4.21%, -1.63%] |
| 离线 npm 安装 | 231.70 | 229.50 | -0.95% [-1.74%, -0.06%] |
完整任务中位数差为 -52.27 ms,95% CI [-65.35, -22.30] ms。读取差异区间包含零,不能宣称读取加速。68 项普通 Rust 测试、7 项真实 Linux FUSE 挂载测试、targeted Clippy 和 warnings-denied rustdoc 通过;保留复制期间 metadata/只读访问、队列饱和、FIFO、worker 与 inline 关闭排空、缓存通知和挂载并行压力覆盖。尚无该修复的 macOS 性能验收。
空闲调度统计 CSV 与源码、制品和来源记录保存在本地批次或归档中。原始报告、stdout、预算与 namespace 收据在 benchmark/.data/fr10fixf3/;冻结源码、构建收据、发布校验与外部干扰记录在 benchmark/pvisor/.data/filesystem-regression-20261010/。原始及中间诊断样本保留,不混入正式统计。
Linux VM 的 worker 调度与完成唤醒
同条件 Linux VM 工程配对中,worker 调度修复使完整七项任务与退出耗时下降 3.15%、读取并校验 64 MiB 耗时下降 3.06%、离线 Cargo 编译耗时下降 3.14%。其余指标未检出差异或呈分离分布。 相对仅撤销两项近期改动的回退对照,遍历 2,048 文件、读取并校验 64 MiB、离线 Cargo 编译仍有可检出的成本,不能宣称全部单请求成本恢复。结果属于 B-FS-ENG,不与 staged 工程批次或跨运行时用户表合并,不外推 macOS、冷磁盘或并发吞吐。
动机、实现与实验设计
长读和目录请求交给线程池后,后续 metadata/hiprio 可以继续接纳,但无竞争请求的线程迁移、接收端 selector 和完成唤醒会增加工具延迟。修复在全部在途请求清空时复用固定的首个 worker,减少无竞争请求的线程迁移;已有在途请求时继续使用原共享 FIFO,保留突发负载的并行接收。专用空闲入口容量为 1,计入同一个总在途上限;排队、执行与未发布完成的总额度不变,RAM lease 仍由 owner 管理。owner 等待前先原子 arm,再检查完成 channel;worker 提交完成后原子 disarm,只有已 arm 才写唤醒。已有完成时零超时轮询,仍先检查停止事件。大 READ/目录请求保持异步,owner 独占 used ring,关闭时先排空再 join 所有 worker。
2026-10-11,Linux x86_64 / Fedora 7.2.8-200.fc44.x86_64 / Ryzen 7 9700X / Btrfs。三份 release 制品来自同一冻结的 10 月 10 日源码:回退对照只撤销 65e65c93 与 09bd1d59;当前基线保留这些优化和宿主空闲调度修复;候选相对当前基线只改变 VM worker 实现、私有测试与 crate README。回退对照保留其余源码和默认串行 stage 同步,与 10 月 6 日历史批次无关。
整父组 CPU 0,1、quota 两核、16 GiB、swap 0;VM 为 2 vCPU、16 GiB guest RAM,使用同一固件、工具与输入。热宿主缓存、每次新工作区与独立工具缓存、Python 不读写 bytecode、Node 缓存启用。每样本独立 user/mount/PID namespace、owned pivot_root、fresh VM 与 Host listener;namespace/输入准备不计时,启动与退出计入完整任务,Btrfs 工作区/stage 保持绑定。每版本 3 次预热、30 个随机配对轮次,seed 20261010,使用原 reference task timer,不是 hyperfine,正式计时关闭 profiling。
90 个正式任务及 9 个预热均通过输出、Run Bundle、宿主未写入、upper 全部 256 文件逐字节与输入前后清单校验。0.5 s 同用户构建/测试干扰门禁未检出活动,短暂、不可见或未识别活动可能漏检。所有有效慢样本保留;本批样本独立保存,不补入其他批次统计。
同条件结果与剩余成本
单位 ms,每版本 N=30。通常为 P50,分离簇列各簇中位数与数量且不作整体排名。区间为 5,000 次按同轮配对 bootstrap;不报告 P99。
| 指标 | 当前基线 ms | 修复 ms | 变化与 95% CI |
|---|---|---|---|
| 工具 Ready | 702.39 | 701.45 | -0.13% [-0.39%, +0.41%],未检出差异 |
| 完整七项任务与退出 | 4741.87 | 4592.36 | -3.15% [-6.14%, -1.23%] |
| 遍历 2,048 文件 | 154.58 | 159.74 | +3.34% [-11.45%, +10.03%],未检出差异 |
| 读取并校验 64 MiB | 120.47 | 116.78 | -3.06% [-3.89%, -0.96%] |
| 写入 256 文件 | 130.89 | 130.24 | -0.50% [-9.19%, +9.89%],未检出差异 |
| git status | 436.55 | 371.64 (25/30); 617.08 (5/30) | 分离分布,不作整体排名 |
| Ripgrep 搜索 | 417.92 | 424.90 | +1.67% [-1.01%, +5.40%],未检出差异 |
| 离线 Cargo 编译 | 523.22 | 506.79 | -3.14% [-4.46%, -0.53%] |
| 离线 npm 安装 | 926.99 | 923.10 | -0.42% [-1.88%, +0.63%],未检出差异 |
恢复程度必须使用同批回退对照,而非历史页面百分比:
| 指标 | 回退对照 ms | 修复 ms | 变化与 95% CI |
|---|---|---|---|
| 完整七项任务与退出 | 4553.30 | 4592.36 | +0.86% [-1.41%, +2.43%],未检出差异 |
| 遍历 2,048 文件 | 132.99 | 159.74 | +20.12% [+1.50%, +35.87%] |
| 读取并校验 64 MiB | 114.36 | 116.78 | +2.12% [+0.80%, +3.71%] |
| 离线 Cargo 编译 | 488.23 | 506.79 | +3.80% [+2.84%, +5.71%] |
相对仅撤销两项近期改动的回退对照,遍历 2,048 文件、读取并校验 64 MiB、离线 Cargo 编译仍有可检出的成本,不能宣称全部单请求成本恢复。三版本对照包含近期调度与 journal 语义变化,不能把每个剩余差距全归因于一次 worker 切换。呈分离簇的指标不提供单一整体排名。359 项 VM 测试、targeted Clippy、warnings-denied rustdoc 和实际 CLI/guest 执行通过;包括空闲请求复用 worker、长请求后的 metadata 接纳、乱序完成、RAM lease 保持、就绪完成不休眠和冻结排空。macOS 性能未验收。
VM 调度统计 CSV 与源码、制品和来源记录保存在本地批次或归档中。原始报告与各样本证据在 benchmark/.data/fr10vmfixf/,冻结源码、构建与发布校验在 benchmark/pvisor/.data/filesystem-regression-20261010/。这些绝对时间不与跨运行时用户页的配置拼接。
修复后的优化候选与诊断
下一步优先减少路径解析中的重复物理检查,其次评估不可变 rootfs 的缓存契约,再优化目录请求和完成通知。 三次插桩诊断支持这个调查顺序;尚未测得这些候选的加速比。
动机与实验设计
2026-10-11,按 B-FS-DIAG 使用上面的最终 candidate5 冻结 release 制品(SHA-256 a4cfdbc6e2657f9ff6a43a4c640cd472c1c94c965c9d388924e58727dc55556d),运行三次独立 VM 七工具任务。沿用相同输入、固件、私有 namespace/owned pivot_root、全父组 CPU 0,1 / 两核 quota / 16 GiB / swap 0 和工具缓存策略;打开 filesystem profile 与启动计时,stderr 写入普通文件。无预热,无版本对照,无外部构建/测试干扰监测;这些诊断不进入用户表,也不用于性能验收。
三次均通过工具输出、Run Bundle、宿主隔离和 256 个 upper 文件的完整字节检查,输入清单前后相同。每次有 13/13 个 final profile 实例,按 PID/component/instance 保留最后累计记录;同号 supervisor 与 VMM 实例分别处理。下表汇总两个有请求的 VM 实例,同一 label 的累计 span 可能跨 worker 重叠,不能推算任务耗时占比、预计加速或工具级归因。
请求成本与候选优先级
| 观察项 | 三次任务的范围 | 优化含义 |
|---|---|---|
Core 路径解析 resolve,累计 inclusive span |
368.6–378.8 ms | 优先调查重复路径验证 |
| Core 父目录物理 stat,计数 | 186,401–187,722 | 深路径每项重复检查仍多 |
| Core 父目录身份 statx,计数 | 109,564–110,238 | 身份验证必须保留,评估同请求内复用 |
| worker 排队与完成等待,两种累计 span 合计 | 84.0–93.5 ms | 调度仍有成本,需保持长 I/O 响应性 |
| 两个 VM 实例的 used interrupt,计数 | 37,572–37,660 | 检查批处理与通知机会 |
| 优先级 | 候选 | 需要验证的契约与实验 |
|---|---|---|
| 1 | Core 与 VM backing 之间复用已验证的父目录/leaf 信息 | Core 已解析 metadata,VM native lookup 仍执行 openat/statx。评估在同一请求内传递已验证身份与有所有权的 backing handle;保留宿主替换、mount identity、硬链接拒绝和错误后的引用释放。分别测深路径 metadata、READDIRPLUS 与 Cargo。 |
| 2 | 显式不可变 rootfs 的 metadata/data cache | 只读 guest 挂载仍可能被宿主修改,需要输入生命周期或失效机制证明不可变。先减少 Core 物理查询,再评估 guest 请求数;live workspace 保持外部修改可见。分别测首次访问、热缓存与 TTL 到期。 |
| 3 | 分离普通 READDIR 与 READDIRPLUS 的服务路径 | 普通 READDIR 通常消费 OPENDIR 的名称/类型快照,PLUS 则逐项解析新属性。评估有界快照处理与批量父目录复用;旧 handle fallback、锁等待、大目录、删除、权限和 cookie/恢复行为均需保持。不能直接将所有目录请求改为 inline。 |
| 4 | worker 分发与完成/中断批处理 | 保持共享负载均衡、长读 offload、owner 发布 virtqueue、RAM lease 与 freeze drain。逐 worker 队列候选此前三次计时尝试被外部构建/测试干扰拒绝,未合入;先补混合长短请求与队列饱和正确性,再运行独立 30 轮 A/B。 |
| 5 | 指纹与持久化的重复工作 | workspace 每次有 2,157 次 content fingerprint,累计 46.3–51.9 ms。调查重复观测/批处理,保留首次修改前 preimage、journal 顺序、durability 和恢复;不可将延后记录当作低成本替代。 |
该冻结制品的 Linux 本地读取通过 preadv 直接写入 guest descriptor buffer,诊断没有证明消除另一次中间拷贝能产生收益。DAX 和 writeback 现有独立开关结果分别见只读 share 对照和写合并对照;guest-local/block rootfs 尚无对应验收。这三次诊断没有按工具 checkpoint,不能由重叠 span 推断 metadata、read 或 Cargo 的耗时占比。
原始来源:benchmark/.data/fr11explore/report.json、冻结 runner.py/child.py/harness/、制品与源码回执、每任务 stderr/stdout、diagnostic-summary.json 与 counter-summary.csv。正式候选继续按 B-FS-ENG 的同源随机配对、3 warmups/30 轮、正确性与干扰门禁验收;通过后再考虑重测跨运行时用户矩阵。
宿主复制与指纹计算期间的并发访问
Apple M4 / APFS / macFUSE FSKit 的独立工程 A/B 表明:宿主调度与 journal 锁优化让其他文件的短请求与 1 GiB 复制或哈希重叠执行。 改善的是阻塞期间的响应性;完整七项工具、Linux FUSE、VM 和冷磁盘没有对应的新性能结论。以下三组独立批次属于 B-FS-ENG,不合并样本,也不折算跨运行时工具基线。
Motivation 与实验设计
大文件首次写入触发 copy-up,首次读取观察触发内容指纹计算。需要同时检查其他文件访问的等待、空闲请求成本和长操作完成时间,才能判断调度改动的收益与代价。
测于 2026-10-10,Apple M4、24 GiB RAM、Darwin 27.0.0 / arm64、APFS、macFUSE 5.4.0 / FSKit,Rust 1.98.0 release;不固定 CPU 亲和性或全机资源限额。各 A/B 使用同一冻结源码与依赖,仅恢复/保留该项改动;copy-up 调度对照的基线文件来自 392c9d99,读队列与 journal 锁对照来自 f109dd25,后者候选源码为 09bd1d59。其他改动在各自 A/B 中保持一致;两次对照的候选不可当作同一批制品。
每格 3 次预热、30 个正式配对轮次,seed 4207 随机排列条件与 A/B 顺序;使用热缓存的 1 GiB 非稀疏确定性文件、新 upper/work 和独立路径。复制实验调用真实宿主挂载;journal 实验使用一个共享原生 Core,不经过 FUSE。复制临时文件必须确实未完成,或实际首次内容读取已发生且哈希线程仍活跃,探测才有效;没有人工延迟。读实验同时释放 OPEN、READ 和目录枚举,各自检查开始时仍在复制,避免前一条阻塞把后续探测变为空闲测量。
计时外校验完整 lower/upper 字节、身份、硬链接、已打开描述符、rename、临时副本清理、日志指纹和正常卸载;原生 journal 每试次校验全部 129 条观察。试次前、中途每 250 ms 和结束后检查可见构建/测试干扰;错误、未命中窗口或检出干扰使整批失败。报告中正式失败和慢样本剔除均为 0;保留所有有效慢样本。可见进程采样无法排除短暂或不可见活动。
表格单位 ms,每个基线/候选单元 N=30,通常为 P50;分离分布列出各簇中位数与样本数,不给整组变化排名。95% CI 使用 5,000 次配对轮次 bootstrap;P95 仅作参考,不报告 P99。正式计时没有 profile 插桩。
Copy-up 调度:metadata 响应性
| 日志配置 | 指标 | 基线 ms | 候选 ms | 中位数变化与 95% CI |
|---|---|---|---|---|
| nojournal | 复制期间首次 stat | 802.858 | 0.681 | -99.915% [-99.919%, -99.911%] |
| nojournal | 复制期间 64 路径 stat | 836.938 | 20.999 | -97.491% [-97.545%, -97.422%] |
| nojournal | 1 GiB writable-open | 803.733 | 819.464 | +1.957% [-0.896%, +4.095%],未检出差异 |
| nojournal | 空闲 64 路径 stat | 34.558 | 34.596 | +0.108% [-8.278%, +7.639%],未检出差异 |
| compact | 复制期间首次 stat | 790.321 | 1.655 | -99.791% [-99.816%, -99.782%] |
| compact | 复制期间 64 路径 stat | 827.025 | 34.640 | -95.811% [-95.854%, -95.739%] |
| compact | 1 GiB writable-open | 1232.667 | 1231.293 | -0.111% [-1.280%, +1.470%],未检出差异 |
| compact | 空闲 64 路径 stat | 32.165 | 34.069 | +5.921% [+2.299%, +10.745%] |
候选的 64 路径 stat 在两种配置中均为 30/30 次先于复制结束,基线首次 stat 等待复制结束。触发点在字节复制开始之后,因此不衡量之前的基线指纹等待。writable-open 包含指纹、复制、发布和协议返回,两种配置均未检出中位数差异。compact 的空闲批次增加 1.90 ms,95% CI [+0.76, +3.36] ms,不能宣称日常 metadata 全面加速。
独立读队列与 journal 指纹锁
读挂载批次与上面的 metadata 批次独立。每种配置、每个候选读探测均为 30/30 次先于复制结束,基线为 0/30。
| 日志配置 | 指标 | 基线 ms | 候选 ms | 中位数变化与 95% CI |
|---|---|---|---|---|
| nojournal | 复制期间只读 OPEN | 784.602 | 1.577 | -99.799% [-99.817%, -99.782%] |
| nojournal | 复制期间 held-fd READ,64 KiB | 784.597 | 0.521 | -99.934% [-99.936%, -99.927%] |
| nojournal | 复制期间 OPENDIR 与 64 项枚举 | 791.558 | 6.919 | -99.126% [-99.190%, -99.074%] |
| legacy | 复制期间只读 OPEN | 797.214 | 3.172 | -99.602% [-99.612%, -99.579%] |
| legacy | 复制期间 held-fd READ,64 KiB | 797.424 | 0.960 | -99.880% [-99.909%, -99.860%] |
| legacy | 复制期间 OPENDIR 与 64 项枚举 | 804.033 | 10.292 | -98.720% [-98.758%, -98.695%] |
| compact | 复制期间只读 OPEN | 800.275 (25/30); 2340.599 (5/30) | 2.219 | 分离分布,不作单一排名 |
| compact | 复制期间 held-fd READ,64 KiB | 800.486 (25/30); 2340.717 (5/30) | 0.760 | 分离分布,不作单一排名 |
| compact | 复制期间 OPENDIR 与 64 项枚举 | 807.137 (25/30); 2347.782 (5/30) | 9.737 | 分离分布,不作单一排名 |
compact 基线读分布为 25/30 普通样本、5/30 慢样本,保留两个簇;不计算单一加速比例。这里的 OPEN 只计打开,完整 open/read/close 在本地 CSV 中单列,包含 FSKit 父目录 xattr 查询及只读 close 回调。
原生 journal 批次测 64 个其他路径的 observe_read,另记录哈希完成时间。读取观察保持非逐次持久化策略,最终 sync_preimages 在计时外执行。
| 日志配置 | 指标 | 基线 ms | 候选 ms | 中位数变化与 95% CI |
|---|---|---|---|---|
| legacy | 首次无关读取观察 | 462.276 | 0.184 | -99.960% [-99.964%, -99.956%] |
| legacy | 64 路径读取观察 | 473.262 | 12.011 | -97.462% [-97.521%, -97.384%] |
| legacy | 完整 1 GiB 指纹计算 | 462.230 | 469.558 | +1.585% [+0.621%, +1.964%] |
| compact | 首次无关读取观察 | 450.714 | 0.045 (25/30); 0.071 (5/30) | 分离分布,不作单一排名 |
| compact | 64 路径读取观察 | 453.158 | 2.385 | -99.474% [-99.477%, -99.464%] |
| compact | 完整 1 GiB 指纹计算 | 450.739 | 452.237 | +0.332% [-0.398%, +0.783%],未检出差异 |
legacy 的 64 路径观察等待显著减少,但完整哈希增加 7.329 ms,绝对 95% CI [+2.894, +9.066] ms;compact 哈希未检出差异。读批次的所有空闲探测与 journal 批次的空闲观察均未检出差异,不能据此证明开销相等。compact writable-open 的中位数降低 1.89%,95% CI [−3.13%, −0.45%];其余配置未检出差异。这是并发探测下的打开完成时间,不是独立存储带宽。
长操作尾部仍不确定:读批次无日志 writable-open 的参考 P95 从 952.6 ms 到 3166.9 ms,最大值从 1469.6 ms 到 4636.8 ms,慢样本全部保留。普通读写、目录快照与发布仍可能占用共享状态锁;独立队列不保证重叠读与修改的到达顺序,并发首次观察可能重复指纹工作。不能从短请求改善推导整个 Agent 任务或长操作均无回退。
Stage 并行同步的测量状态
PVISOR_STAGE_SYNC_WORKERS=2|4|8 显式开启 stage sealing 的有界普通文件同步池;未设置或 1 保持串行。journal 校验和持久化先完成,文件同步全部成功且 worker 全部结束后,才执行自底向上的目录同步、父目录持久化及原子 seal 发布;失败不发布新 seal。工作负载的显式 fsync 与 journal 同步不使用该池。
尚无独立串行/并行计时数据。 上面的 A/B 没有改变 worker 数,不能用来量化该选项的收益。性能评估需同一冻结二进制、新 stage、相同 worker 以外的配置,计时包含完整持久化边界并验证 lower 不变、upper 完整字节与完成标记;不从实现存在推导加速幅度。
加工数据、来源与复现
Copy-up、读队列和 journal 锁的统计 CSV 保存在对应的本地批次或归档中,直接复制已提交的加工结果,保留批次、样本数、分布、相对/绝对置信区间与原始报告摘要;制品摘要和源码收据见来源报告。完整空闲对照、参考尾部和极值保留在 CSV 中。
来源:copy-up 工程报告、读队列与 journal 锁工程报告。原始日志、源码和制品在测量工作区的 benchmark/pvisor/.data/host-copy-up-*、.data/read-*、.data/journal-*,不作为站点下载发布。复现命令见宿主 copy-up 手册与读队列及 journal 锁手册;需要 macOS/macFUSE,不能用 Linux 上的 harness 测试代替挂载测量。
当前 Linux HOST 内核缓存能力与证据
显式所有权契约下,Linux HOST API 支持可写 Metadata 和只读 MetadataAndData;当前源码的正确性测试与独立请求计数有效,正式性能验收仍受阻。 内核缓存与下方不可变 lower 的服务端物理元数据缓存是独立机制,均不自动改变产品执行器默认配置。
策略与准入契约
pvisor_overlayfs::api::OverlayMountConfig.kernel_cache 显式选择策略;默认行为保持不变,无环境变量自动开启扩展策略。
| 策略 | entry/attr TTL | negative TTL | 普通文件打开与范围 |
|---|---|---|---|
Disabled(默认) |
原有 1 秒 | 0 | 无 KEEP_CACHE;保留旧默认 |
Uncached |
0 | 0 | 无 KEEP_CACHE;显式 metadata-cache-off 对照 |
Metadata |
配置值,0 < TTL <= 60s |
同配置值 | 无 KEEP_CACHE;支持 Linux HOST 可写视图 |
MetadataAndData |
配置值,0 < TTL <= 60s |
同配置值 | 仅稳定只读普通文件设置 KEEP_CACHE;可写配置明确拒绝 |
配置 TTL 默认 60 秒,Disabled/Uncached 忽略该值。Uncached 不启用 DIRECT_IO,打开句柄内仍有普通内核页缓存;所有策略均不启用 writeback caching。
扩展策略要求所有物理 lower 按顺序显式声明 Immutable,OwnedViewContract 两项断言均为真,读取语义显式为 StableView,启用 default_permissions 且 FUSE 仅允许 owner 访问。内容、命名空间、权限、ownership、xattrs、hardlink 别名、物理祖先和挂载身份必须保持稳定;upper/work 仅允许此 adapter 修改,并独占至实际卸载。读取也不得改变 backing atime:merged mount 的 NoAtime 不能替代真实 backing 的 noatime 或等价保证。只读挂载、镜像摘要与 advisory lock 都不能证明这些条件。adapter 持有 canonical upper/work 目录对象的非阻塞独占 flock,仅协调合作的 opt-in 会话,不阻止宿主旁路写入。
准入在准备 I/O 前拒绝 journal/preimage、compact journal 初始化、read metrics sink、所有自定义 path policy(包括绑定上下文)及 exclusions,不降级或静默跳过观察。StableView 接受缓存命中不进入 callback,不提供逐 read 审计、首次内容观察日志、snapshot 或 review 兼容性。macOS 和 VM 不支持扩展策略;virtio-fs 尚无等价已验证通知输出通道,该 DTO 不传播到 runtime/VM 配置。
Mutation effects 与失败边界
mutation 前后均收集精确 effects,包括已部分 copy-up 或修改 upper 后失败的请求。effects 覆盖已知对象 inode、hardlink 别名、父目录/祖先属性和精确 namespace entry;rename/exchange/removal 包含已知子树、替换对象及旧/新 entry,不将父目录属性变化扩散为无关 sibling entry 淘汰。覆盖 create/mknod/mkdir/symlink、unlink/rmdir、rename/exchange、link、可写 open/copy-up/O_TRUNC、write、setattr、xattrs、fallocate 和 copy_file_range。
copy-up 与递归目录 materialization 将新物理对象绑定回已有 FUSE 身份。晚发现的 lower hardlink 别名通过 Core owner-session 的 copied_hard_link_metadata 映射取得当前 upper 身份与属性;映射在 adapter FORGET/reclaim 后仍有效,lookup/readdirplus 必要时 materialize upper 别名并记录 effects。该映射仅属当前 Core owner/session,不跨 rebuild、重新构造或新会话持久化;adapter inode 表或 canonical path 不能替代它。
mutation 开始前增加 pending,此后 metadata/entry 回复(包括 mutation 回复)暂用零 TTL。独立 reply worker 对受影响 inode 执行 metadata-only inval_inode(ino, -1, 0) 后发送回复;Linux 协作 mutation 路径处理直接 dentry/page-cache 更新。独立 entry worker 随后异步发送额外 inval_entry(parent, name) 并再次过期属性;全部批次完成后才恢复长 TTL。entry 通知不保证先于 syscall 返回,reply worker 不等待 entry worker,FUSE callback 不等待 worker、不发通知、不卸载。可写 inode 不做 blanket data invalidation,避免等待脏页/相关 write;Metadata 不使用 KEEP_CACHE。
WRITE 使用请求的当前 open flags,支持动态清除/恢复 O_APPEND。COPY_FILE_RANGE 在 positional copy 前清除 backing fd 的旧 O_APPEND,无需先发生 WRITE;部分复制后遇到错误返回已写字节数,使内核获知实际修改。
reply/entry 队列各限 256 批,stop 队列限 513 项,全局最多 512 个 mutation 批次;每 effects plan 最多 4096 个 inode/entry key 加一个 overflow sentinel。溢出、worker panic 或通知错误(无害 ENOENT 除外)停止会话,upper 已发生的修改不回滚。可写准入要求真实 fusectl abort endpoint,并在实际 mountpoint 用临时挂载验证 detach→abort;mount() 返回前不得启动用户。
失败 worker 先 detach 并核对 mountinfo,再写 connection abort;detach 失败不写 abort。helper、termination、worker join 和 shutdown 均有有界等待,shutdown 外层限 15 秒,致命终止失败会结束 server 进程。单次 notifier 调用没有独立 deadline;终止时限不保证每个 mutation syscall 都在该时限内结束。abort/server death 不能撤销其他进程的暖缓存,成功 detach 也不能撤销已持有 fd;EIO 不是通用卸载 fence。调用方必须监督并停止全部用户、释放 fd、保留 backing 供恢复,不允许导出 bind/namespace/FD 别名,并维持 namespace、凭据、helper 与卸载权限。实验失败路径已观察到 namespace kill 后 FUSE task 等待 request_wait_answer;简单进程终止探针不证明所有 FUSE 等待都可立即有界清理。
当前验证与测量范围
2026-10-07,定向验证记录:pvisor-overlayfs 58 passed / 9 skipped,pvisor-overlay-core 124 passed / 5 skipped;显式执行的真实 mount 测试 7 passed。回归覆盖 inode 回收后的 late-hardlink 身份、动态 APPEND 与 positional copy、部分复制失败。独立源码复核未在这两项身份和复制修复中发现新的阻断问题;验证范围不包含全面审计或性能验收。
B-FS-ENG 计划以同一新冻结 release 二进制比较 native、legacy-writable、Metadata-writable60s、Metadata-readonly60s 与 MetadataAndData-readonly60s,每格 3 warmups、30 samples,CPU 0,1、seed 4207,2048 个字节校验文件、32 个半深路径分支。可写对照保持视图语义相同,KEEP_CACHE 归因仅比较两个只读条件。hot/readsearch/TTL 操作前即时预热;TTL 窗口在计时外等待 1.1 秒,不测试 60 秒过期。
所有 native/lower/upper/work 均位于私有 user/mount/PID namespace 的真实 noatime,nosuid,nodev,mode=0700,size=512m tmpfs。live mountinfo/device 与物理 file/directory 的 past-atime 反复读取检查覆盖 upper/work 等 backing,证实 atime 不变;仅设置 merged NoAtime 或未来 atime 不算 physical proof。RAM backing 的证据不能推广到磁盘性能/持久化、VM、pvisor run 或 review。
| 证据 | 当前源码状态 |
|---|---|
| 五条件预检,n=1/cell | 通过 |
| 正式计时,3 warmups + 30 samples/cell | 三个整批均被并行 Cargo checks 污染并拒绝;accepted=0 |
| P50、耗时变化及 bootstrap 95% CI | 未验收;25 个计划 cell 的统计值均留空 |
| 独立 B-FS-DIAG profile,n=3/case | 有效,仅用于请求计数 |
独立 profile 保留 90 个新诊断 case、5 个持续正确性进程、95 个日志及 152 个唯一 final 实例;累计 checkpoint 由各实例最后记录替换,不相加。下表摘自派生 CSV,为每种条件三次诊断的请求中位数(范围均等于中位数);warm 增量减去同轮独立 fresh mount 的 prime-only,单位为 callback 次数,不包含时间。
| 操作 / 计数范围 | 条件 | LOOKUP | GETATTR | OPEN | READ |
|---|---|---|---|---|---|
| hot / warm 增量 | legacy-writable | 0 | 4096 | 4096 | 4096 |
| hot / warm 增量 | metadata-writable | 0 | 4096 | 4096 | 4096 |
| hot / warm 增量 | metadata-readonly | 0 | 0 | 4096 | 4096 |
| hot / warm 增量 | metadata-and-data-readonly | 0 | 0 | 4096 | 0 |
| TTL 窗口 / warm 增量 | legacy-writable | 2192 | 2049 | 4096 | 4096 |
| TTL 窗口 / warm 增量 | metadata-writable | 0 | 4096 | 4096 | 4096 |
| readsearch / warm 增量 | metadata-readonly | 0 | 0 | 2048 | 2048 |
| readsearch / warm 增量 | metadata-and-data-readonly | 0 | 0 | 2048 | 0 |
| hot / fresh mount 完整生命周期 | metadata-and-data-readonly | 2192 | 1 | 8192 | 2048 |
计数支持延长 TTL 避免此窗口的重复 LOOKUP,以及只读 KEEP_CACHE 消除暖操作 READ callback;可写 Metadata 的 GETATTR/OPEN/READ 并未消失。完整生命周期仍包含初次读取,零暖 READ 不表示无物理读取或零任务成本。诊断耗时不进入正式分布,失败批次不拼接,旧源码 noatime 性能不替代最新源码验收;下方独立 immutable-cache 的有效结果保留其原始测量范围。
正式验收状态与独立请求计数 CSV 保存在本地批次或归档中;见工程报告 · 复现与证据契约。两个 CSV 均为直接复制的派生数据,保留来源/二进制摘要与统计口径;原始样本、日志、冻结源码与回执留在 benchmark/pvisor/.data/,不发布到站点或改写历史结果。
不可变 lower 的物理元数据缓存
真实 Linux FUSE 的同制品 A/B 中,缓存使读密集操作的中位耗时下降约 24%–26%,新进程、挂载、工具执行到卸载的任务下降 19.6%。 这是 B-FS-ENG 工程实验,不是数量级提升,也不证明 OCI、VM、完整 Agent 任务或带审查日志的 staged 执行有同等收益。
契约与实验设计
每个 lower 用 LayerMutability::{Mutable,Immutable} 声明;默认可变。不变性由调用方保证整个服务生命周期内的内容、元数据、命名空间、父目录和挂载身份稳定,包括 hardlink 别名。缓存只保留成功的物理 lower 元数据,最多 4096 条;upper、更高优先级可变层、whiteout/opaque、访问策略和首次观察仍检查。内核的一秒 TTL、KEEP_CACHE 和读取观察语义未改动。
OCI 解包缓存的宿主目录仍可写,lazy 镜像的本地投影会按需变化,故当前没有自动升级这些来源;宿主 rootfs、任意目录和 frozen baseline 也不自动获得承诺。实验使用独占且实际保持稳定的 lower,不能以只读挂载替代所有权保证。
2026-10-07,Ryzen 7 9700X、Linux x86_64、Btrfs,driver 与工具固定 CPU 0,1。2048 个文件、32 个分支,半数路径深嵌套,总 payload 约 1.1 MB;宿主缓存热。四个条件为 native、mutable FUSE、immutable cache-off/on,使用同一冻结 release driver。每格三次预热、30 次正式采样,按固定种子随机交替,共 600 个正式样本,无正式失败。两组 immutable 声明相同,仅关闭/开启服务端缓存;不启用 preimage journal,排除 review/apply 成本。
数据与分析
单位 ms,P50;变化相对相同承诺的 cache-off,95% 区间来自按轮配对 bootstrap。
| 负载 | Native | Mutable FUSE | Cache-off | Cache-on | 耗时变化 | 95% 区间 |
|---|---|---|---|---|---|---|
| 热 metadata/open/read,两次遍历 | 9.34 | 140.01 | 140.86 | 103.96 | −26.20% | [−26.55%, −25.79%] |
| TTL 到期后的两次遍历 | 13.56 | 150.56 | 147.71 | 112.47 | −23.86% | [−25.44%, −22.44%] |
| 单次打开、读取与搜索校验 | 3.36 | 69.72 | 70.31 | 52.80 | −24.90% | [−25.48%, −24.22%] |
| 持续挂载的 Git status、rg 与内容校验 | 19.81 | 202.21 | 203.43 | 154.55 | −24.03% | [−24.69%, −22.98%] |
| 新进程、挂载、工具任务与卸载 | 22.66 | 210.76 | 210.49 | 169.28 | −19.58% | [−20.44%, −19.10%] |
热遍历有未计时预热;TTL 条件在预热后等待 1.1 秒,等待不计时,第二次遍历可以命中内核缓存,因此不是全冷读。写入只用于正确性探针,不提供写性能结论。全部读取验证完整字节;append copy-up、rename、unlink/recreate、whiteout、立即及 TTL 后可见性和 upper 精确清单通过,lower 的完整内容、命名空间和元数据清单前后相同。输入未触发容量淘汰;大仓库、并发、macOS 与 guest 路径未测。
独立 profile 有 24 个实例、全部 final 记录,计时结果不含插桩。持续挂载的 cache-on 相对 off,物理 parent stat 计数下降 49.2%,leaf stat 下降 84.3%;open/read 请求数相同。计数支持减少服务端重复解析,不是减少全部 FUSE 请求或物理磁盘读取的证明;inclusive spans 不相加。cache-on 仍明显慢于 native,长期内核缓存、upper 一致性和映射/缺页路径需分别验证。
正式统计与全部实例计数 CSV 保存在本地批次或归档中;见工程报告与复现命令。冻结源码、制品回执、输入清单、失败预检、正式样本和独立 profile 保存在 benchmark/.data/immutable-cache-*,不合并到用户性能分布。
冻结制品的独立计数器诊断
测于 2026-10-06,CPU 0,1,VM 2 vCPU/16 GiB,使用已核验的冻结 CLI、源码、工具输入和固件。七项文件工具和固定修复各测 staged/VM 三次,共十二个有效任务,失败 0;共享输入的完整字节清单在前后相同。保留执行器默认 TMPDIR,每任务使用新的私有空工具缓存;七项工具的 Cargo 临时文件和产物留在独立工作区。stderr 直接写入普通文件,避免非阻塞管道在大段 profile 输出时返回 EAGAIN。启用 profile 和启动计时,耗时不进入用户性能分布。
每次 staged 有 5/5 个 final 实例,VM 有 13/13 个 final 实例,共 108 个,覆盖 rootfs、工作区和 supervisor。以 PID、component、instance 区分记录,只保留每实例最后一份累计快照。源码中的 rootfs/workspace 创建顺序确定 scope;VMM 与 supervisor 的同号实例不能混合。Inclusive span 会嵌套、跨 worker 重叠,不能相加得到总耗时或瓶颈占比。
| Workload / mode | Filesystem | Metric | Median calls | Median inclusive ms |
|---|---|---|---|---|
| Seven tools / staged | workspace | OverlayCore resolve | 14,978 | 144.67 |
| Seven tools / staged | workspace | OverlayCore observe_read | 4,853 | 162.74 |
| Seven tools / staged | workspace | OverlayCore fingerprint_content | 2,157 | 43.26 |
| Seven tools / staged | workspace | journal sync | 5 | 3.07 |
| Seven tools / VM | workspace | OverlayCore resolve | 15,146 | 234.64 |
| Seven tools / VM | workspace | OverlayCore observe_read | 4,840 | 224.98 |
| Seven tools / VM | workspace | OverlayCore fingerprint_content | 2,157 | 64.13 |
| Seven tools / VM | workspace | journal sync | 5 | 2.12 |
| Seven tools / VM | rootfs | OverlayCore resolve | 6,790 | 184.66 |
| Seven tools / VM | rootfs | virtio-fs LOOKUP | 4,802 | 166.51 |
| Seven tools / VM | rootfs | virtio-fs READ | 6,132 | 643.31 |
| Repair / staged | workspace | OverlayCore resolve | 3,126 | 29.45 |
| Repair / VM | workspace | OverlayCore resolve | 2,858 | 39.80 |
| Repair / VM | rootfs | OverlayCore resolve | 6,672 | 180.76 |
七项工具的 VM dispatch/admission 在 rootfs 和工作区分别为 1,260.54 ms、898.64 ms;它围住整个 service_queues,包含 inline 执行,不能称为纯排队或传输。对应 pool_queue_wait 为 13.62 ms、4.09 ms,仍不能将不同 worker 的等待相加为任务耗时。
七项工具的 fingerprint_bytes 中位数为 69,375,893 B,固定修复为 11,286 B,staged/VM 相同。源码在 live lower 的首次内容观察中计算 SHA256;普通 stat/lookup 不触发普通文件内容哈希,frozen baseline 跳过读取日志。Checkpoint 策略将日志持久化移到完成边界;当前七项工具工作区 journal sync 为五次,表中同步 span 约 2–3 ms,计数不支持把逐文件 preimage fsync 当作当前最大的已证实原因。可变 fixture 没有验证 content receipt 复用,也未将读取指纹改成 metadata-only。
默认缓存路径下,六个 VM 诊断中 rootfs CREATE、RENAME、WRITE 均为零,完整 final 记录支持零请求计数。rootfs READ 仍约六千次;其 span 包括服务、锁和调度,不能直接解释为磁盘或传输等待。路径解析、读取观察、工具加载和缓存写入应分别调查。修复任务的读指纹数据量很小,但 rootfs 解析仍有成本;可执行映射探针仅说明短进程的映射路径差异。DAX、长期属性缓存及单一函数的因果收益尚未验证,需要保持访问与暂存语义的工程 A/B 和独立正式计时。
本地整理后的计数 CSV 保留每 filesystem scope 的三次统计、调用范围、完整覆盖和来源摘要;原始日志、冻结 harness、构建回执及整理脚本保存在本地 .data/。相同二进制此前使用管道捕获的诊断有五次 VM 因 stderr EAGAIN 打印 panic 中止;失败证据保留,不计入此表。普通文件捕获仅用于诊断,不能据两种捕获条件的差值推导性能收益。复现见计数器手册。
npm 编译缓存带来的 rootfs 请求
七项工具负载中的 537 次 rootfs 重命名来自 Node/npm 编译缓存。 Linux、CPU 0,1、guest 2 vCPU/16 GiB;相同冻结 CLI、工具输入和固件,以固定种子随机交替默认缓存与禁用缓存。npm --version 和完整七项工具分别使用六个独立新 VM,每个条件三次;共十二个成功 VM、156 个 final 文件系统实例。两组都有相同的 Node 状态探针和事后缓存清点,启用 profile 与 strace,不报告正式耗时或性能收益。
下表是每条件三个 VM 的中位计数;表中各项三次的最小值和最大值均与中位数相同。rootfs 与 workspace 分开,按 PID、组件和实例识别,不能把 supervisor 与 VMM 的同号实例混合。
| 负载 | Node 编译缓存 | 实际缓存文件 | rootfs CREATE | rootfs RENAME | rootfs WRITE |
|---|---|---|---|---|---|
| npm --version | 默认启用 | 70 | 70 | 70 | 70 |
| npm --version | 禁用 | 0 | 0 | 0 | 0 |
| 七项工具 | 默认启用 | 537 | 538 | 537 | 623 |
| 七项工具 | 禁用 | 0 | 1 | 0 | 86 |
Node API 确认默认组缓存目录为 /tmp/node-compile-cache,禁用组状态为 DISABLED。strace 中成功的缓存重命名路径位于 VM 的 root-upper/tmp/node-compile-cache,数量与 rootfs RENAME、copy-up 和实际缓存文件数一致。完整工具负载的输出、256 个写入文件全部字节、未修改的 lower 清单及运行记录均通过检查;共享输入在前后保持一致。关闭缓存只用于请求归因,不是产品优化或用户配置建议,也不能将 537 次请求换算为已验证的毫秒收益。
独立文件系统计数还应覆盖工具缓存,而不只是工作区写入。正式对照需要声明缓存是否跨任务复用、是否为空,以及所在存储;热页缓存与 Node 编译缓存是不同条件。任务内两次 npm 调用可以复用缓存,但不能让不同后端或不同任务意外共享。工作区内的私有空缓存是一个可控口径,不代表所有执行器默认临时目录的性能。
本地整理后的缓存请求 CSV 提供每条件样本数、计数范围、final 覆盖和二进制、源码、输入、tracer、原始报告摘要。原始系统调用、状态输出及审核脚本保存在本地 .data/,不与用户任务耗时合并。
保留 pVisor 默认临时目录的独立诊断同样使用六个新 VM、两个条件各三次,78 个文件系统实例都有 final 记录。guest 内 statfs 返回 0x01021994,确认是实际 tmpfs;默认启用组每次仍产生 537 个缓存文件,而 rootfs CREATE、RENAME、WRITE 都为零。禁用组三项也为零,缓存文件为零。完整工具输出和写入校验通过。这个结果证明缓存生成可以留在默认 tmpfs 中;旧 workload 的 tools_env() 把执行器提供的 TMPDIR 覆盖为 /tmp,将缓存写入转移到 rootfs overlay。诊断次数有限且有插桩,不能据此声称端到端加速;默认临时目录与工作区存储控制需要分别正式采样。
FUSE 请求与 stage 服务端成本
四个宿主条件使用同一份核验并冻结的 CLI 和七项工具输入:原生、host 直通、独立重建的 FUSE 直通驱动和 staged。四次预检及三轮随机交替任务全部通过,共十六次。每次逐字节核验 256 个写入文件;staged 的 lower 路径、模式和内容保持不变。直通执行只允许 fixture 中经过核验的工具链路径重写和 Git 索引 stat 信息刷新,索引的全部路径、模式和对象摘要保持一致。每任务空缓存保留执行器 TMPDIR。
驱动使用相同冻结 vendored fuser 字节、release 配置、同步请求循环和一秒 TTL,不启用 writeback 或 keep_cache。它跳过 OverlayCore、访问策略、copy-up 和 preimage 日志,因此是传输对照下限。下表为三个独立插桩任务的请求数中位数,不含预检:
| 工作区请求 | FUSE 直通 | staged host FUSE |
|---|---|---|
| lookup | 3,059 | 3,057 |
| getattr | 452 | 451 |
| read | 5,014 | 5,014 |
| write | 290 | 290 |
| readdir | 464 | 465 |
这五类已计数回调的数量相近。stage 额外执行内部服务工作:14,975 次 OverlayCore resolve 的 inclusive span 中位数为 143.52 ms,4,853 次读观察为 164.30 ms,2,157 次内容指纹为 45.15 ms。这些 span 嵌套、重叠,不能相加或换算为任务耗时占比。这支持把路径解析和读观察成本与内核请求流量分开测试;它不证明直通驱动提供等价语义,也不构成产品提速结论。
整理后的 FUSE 请求与服务计数保留计数范围、组件/实例作用域,以及 CLI、驱动、源码、输入和审计摘要。插桩和抽样资源观察的任务耗时不进入用户延迟表;未知的进程生命周期保留为未知。原始证据放在 .data/,复现方式见 benchmark README。
Stage 持久化计数
独立批次使用相同核验后的 CLI 和工具输入,对照 native、strict、checkpoint。三次预检和三轮随机交替任务通过,共十二次。所有 staged 任务都有要求的策略标记和完成 seal,lower 完整清单不变、写入字节完整,五个文件系统实例均有 final 记录。下表为三个独立插桩任务的单任务中位数,不与 FUSE 直通批次合并。
| 日志操作 | strict 次数 | checkpoint 次数 | strict inclusive ms | checkpoint inclusive ms |
|---|---|---|---|---|
| append | 2,703 | 2,703 | 8.78 | 5.97 |
| transaction | 8,686 | 8,686 | 329.44 | 18.53 |
| sync | 340 | 5 | 313.08 | 3.23 |
Linux 每个日志 sync span 都调用日志文件的 sync_all;目录及其他文件的同步不在此计数内。strict 每任务为 339–340 次,checkpoint 均为五次。transaction 包含同步,耗时不能与 sync 相加。这明确定位了 strict 模式下可观的持久化服务成本。checkpoint 仍记录相同的 2,703 次 append 并检查结束 seal;任务结束前允许日志未同步。这些检查不证明任意崩溃窗口的保证等价,插桩 span 也不证明未插桩任务延迟有同等幅度的下降。工程入口将计时批次独立留存,至少三十轮时输出分布分簇与配对区间。
整理后的持久化计数包含所有组件实例、计数范围及源码/输入/审计摘要。原始报告、stdout/stderr、输出清单和失败的发布审计尝试留在本地 .data/。
可执行文件映射的独立诊断
相同 rg --version 的 ELF、loader 和全部动态库,分别从 virtio-fs 文件与 executable memfd 执行。Linux、继承宿主 CPU 0,1 亲和性,guest 配置为 2 vCPU/1 GiB;每种条件三个独立新 VM,每个 VM 执行 50 次,顺序随机交错。十二个 VM、600 次调用全部输出校验通过,每个 VM 的 13 个文件系统实例都有 final 记录。完整预备输入在执行前后校验通过;保留的工作区路径、副本字节、命令、输出及 profile 通过独立审计。profile stderr 直接写入普通文件。构建、输入、固件和原始输出摘要保留在证据目录;这是启用 profile 的诊断,不进入用户任务性能表,也不证明全部后代进程完整生命周期的 CPU 放置。
| 准备来源 | 执行映射 | 首次启动中位数 ms | 重复启动中位数 ms | 重复启动 major faults |
|---|---|---|---|---|
| 原始文件 | virtio-fs | 6.48 | 5.10 | 37 |
| 原始文件 | memfd | 1.56 | 0.73 | 0 |
| 独立 inode 副本 | virtio-fs | 7.93 | 5.07 | 37 |
| 独立 inode 副本 | memfd | 1.27 | 0.73 | 0 |
首次启动统计三个 VM 的第一调用;重复启动先取每 VM 后续 49 次的中位数,再取三个 VM 的中位数,不能把调用数当作独立样本数。两组都先复制并哈希校验相同输入、继承相同 fd;guest /dev/shm 保持 noexec。原始文件准备会预热原 inode;副本准备从不同 inode 读取相同字节,但共同的 Python 准备仍预热解释器及部分库,不能称为完全冷启动。
重复启动的映射差距约 4.4 ms,同时 major faults 从 37 变为 0,支持优先调查可执行文件映射与缺页服务。major fault 计数不等于物理磁盘读取次数;这组替换同时改变了文件映射、路径访问及加载器的请求路径,不能把差距全部归因于 FUSE 传输或 DAX 缺失,也不能按完整 Agent 任务的进程数直接外推收益。生产实现需要保持访问策略、暂存观察与证据语义,再进行独立正式计时。
执行统计、来源与测量边界 CSV,以及原始报告、逐 VM 输出、审核和整理脚本保存在本地 benchmark/.data/。
合入计划与目标持久化
相同冻结父源码的 CLI-only release 构建,仅合入实现有被执行的源码差异;编译器、292 个依赖编译单元的 features、profile 和 rustflags 一致。CPU 0,1,宿主缓存热,每格三次预热、30 次正式测量,随机交替,每次独立 target/stage;准备排除在合入计时之外。下表来自不启用 profile 或 strace 的 240 个有效样本,改动在同一个目录内。
| 文件数 | 操作 | 基线 P50 ms | 目录索引 P50 ms | 差值的 95% 配对 bootstrap 区间 ms |
|---|---|---|---|---|
| 1,000 | 合入 | 962.12 | 944.09 | −51.16 至 −2.72 |
| 1,000 | 合入前冲突检查 | 46.07 | 21.98 | −24.75 至 −22.98 |
| 10,000 | 合入 | 13,130.25 | 11,031.86 | −2,461.98 至 −1,790.97 |
| 10,000 | 合入前冲突检查 | 2,651.01 | 189.78 | −2,474.89 至 −2,448.60 |
完整原始、暂存和最终内容由冻结 harness 在运行时检查,随后删除生成的 workspace/upper;独立事后审核覆盖保留的构建、命令、退出码、冲突输出和提交 ledger,不能称为再次独立校验了已删除的最终文件。合入前冲突不是合入途中外部写入的覆盖测试,也不是崩溃恢复测试。该工程 A/B 不构成 Git 或其他产品的性能对照。
另一个启用 profile 和 strace 的独立诊断,每格三次,共 24 个有效命令,保留完整退出记录并按 fd 路径分类。两版的同步调用完全相同:
| 合入文件数 | target 文件 fsync | target 目录 fsync | stage fsync | 其他 fsync | 合计 |
|---|---|---|---|---|---|
| 1,000 | 1,000 | 1,003 | 18 | 1 | 2,022 |
| 10,000 | 10,000 | 10,003 | 18 | 1 | 20,022 |
合入前冲突命令的这些调用均为零。目录索引改善了计划阶段,却没有减少目标持久化的调用数;10,000 文件合入仍约 11 秒。按唯一目录在事务边界批量同步值得另做实验,但必须先验证 Prepared、TargetApplied、Committed 的落盘顺序、崩溃恢复和途中外部编辑保护。请求计数证明调用规模,不能证明这些调用占全部剩余时间;strace 用时受插桩影响,不能与嵌套 profile span 相加或用于正式收益表。
保留的独立工程实验
新版默认 release 的本地 VM 整轮 P50 为 4.15 s(较已优化 v3 +3.3%),遍历 157.57 ms(-6.5%)。lazy 镜像热缓存的打开/读取下降 8.6%、64 MiB 读取下降 6.6%,但元数据遍历变慢、copy-up 约慢 2.5 倍。本轮没有显示普遍端到端加速;完整分布和冷/热条件见新版本评测。
Motivation
Agent 经常反复读目录、搜索和修改文件。应同时看到任务本身和启动、视图准备、记录所需的总时间,才能决定是否值得开启暂存或 VM。
实验设计
最新批次随机交替 native 与优化前/后的 staged、libkrun VM;历史矩阵另含 host、safe、Docker、rootless Podman/crun 与 pVisor OCI。每格通常 3 次预热、30 次测量,热宿主缓存;完整 Ubuntu 补测为 N=10,分别标注。准备镜像和复制输入不计时。worker 包含工具运行与输出校验;wall 包含启动到退出。metadata/git/rg 使用 2,048 文件、32 目录;read 校验 64 MiB SHA256;product-v1 和完整工具环境的 write 均写 256×64 KiB,共 16 MiB;各批次仍按配置分别统计。cargo 编译 64 个无外部依赖的小模块并验证结果 2016;npm 离线安装 32 个本地包,不访问 registry。
macOS
本轮只在 Linux 实测,平台覆盖边界与既有 macOS/HVF 数据的归属见端到端任务分析。
Linux:统一文件服务重构后的评测
本轮测试使用重构后的冻结源码,host 保留 FUSE,VM 的本地、staged 和 lazy 文件视图由 virtio-fs 接入共享服务;lazy 镜像不再建立中间宿主 FUSE 挂载。实现结构中的协议状态仍 分属两个入口,没有启用 DAX、writeback cache 或长期属性缓存。
对照与测量范围
基线是此前五项优化后的最终 v3 制品,已包含路径索引、目录延迟分配和 请求队列调整,并非 P0 前版本。新版从集成工作树冻结后构建;源码与制品 摘要分别记录。工作树还包含 cluster/service 等同期修改,因此本轮是版本 制品对照,不把全部差异归因于某一个函数或仅归因于移除 FUSE。
两边使用相同 firmware 和完整工具 fixture,2 vCPU/4 GiB,固定物理核 0,1;staged 都要求 rootless_process 及读写隔离。每格 1 次正确性预检、 3 次预热、30 次测量,预检和预热不入分布;每轮随机交替五格,七项工具 按固定顺序运行。普通负载使用本地 rootfs,本来就没有中间宿主 FUSE, 因此单独测 lazy 镜像才能判断该路径重构的效果。宿主缓存热、CPU 非独占, release 批次一分钟 load 为 1.37 → 2.27;未将不同批次样本合并。
默认 release:本地 rootfs 完整负载
下表为 P50,单位 ms,负值表示耗时下降;共 150 个任务、1,050 个工具 测量,原有工具结果、Run Bundle、lower 不被写入及 upper 的 256 文件 检查全部通过。默认 release 为 opt-level=z,两边编译配置相同。
| 操作 | 原生 | host staged 前→后 | VM 前→后 | VM 变化 |
|---|---|---|---|---|
| metadata | 4.58 | 76.14 → 76.29 | 168.53 → 157.57 | -6.5% |
| read | 32.21 | 65.65 → 66.18 | 116.12 → 116.91 | +0.7% |
| write | 3.60 | 200.70 → 200.46 | 245.18 → 243.09 | -0.9% |
| git | 13.79 | 165.87 → 165.75 | 359.63 → 439.83 | +22.3% |
| rg | 6.84 | 89.95 → 90.46 | 448.42 → 448.88 | +0.1% |
| cargo | 46.49 | 102.49 → 102.65 | 488.15 → 494.97 | +1.4% |
| npm | 163.74 | 250.12 → 250.71 | 1337.35 → 1334.66 | -0.2% |
| 启动到退出 | 426.43 | 1240.79 → 1242.06 | 4021.54 → 4152.52 | +3.3% |
新版 VM 遍历中位数下降 6.5%,整轮中位数反而增加 3.3%,Git 增加 22.3%;host staged 整轮仅 +0.1%。本批没有显示本地 rootfs 普遍加速。与同批原生相比,当前 VM 遍历约 34.4 倍、小文件写入 67.5 倍、64 MiB 读取 3.6 倍、npm 8.2 倍,小文件和元数据 仍是需要处理的成本。
| 操作 | VM 前→后 P95 | VM 前→后 P99 |
|---|---|---|
| metadata | 199.59 → 199.24 | 208.31 → 201.96 |
| read | 120.75 → 134.33 | 123.49 → 141.60 |
| write | 260.44 → 269.16 | 262.67 → 272.02 |
| git | 719.48 → 723.31 | 738.35 → 746.02 |
| 启动到退出 | 4384.50 → 4406.12 | 4550.35 → 4469.82 |
遍历尾部略降,但 read/write 尾部升高;整轮 P95 基本持平、P99 略降。
30 样本下 P99 受个别任务影响很大,不能据中位数或单个尾部值宣称稳定收益。
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-service-20261005/local-release.tsv
保留每个任务的七项时间及启动到退出时间。
Performance 制品:同编译配置的本地对照
另一完整批次同样包含 150 个任务、1,050 个工具测量,所有正确性与隔离 检查通过;基线和新版均为 opt-level=3。批次负载 0.93 → 3.87,CPU 非独占。下表单位 ms,均为 P50;不与 release 批次合并分布,也不使用 两批新版 4.15/3.81 s 的差值推算编译优化的因果收益。
| 操作 | 原生 | host staged 前→后 | VM 前→后 | VM 变化 |
|---|---|---|---|---|
| metadata | 4.59 | 67.30 → 67.91 | 146.11 → 148.54 | +1.7% |
| read | 32.12 | 65.60 → 65.41 | 116.28 → 115.21 | -0.9% |
| write | 3.68 | 196.60 → 195.74 | 233.49 → 231.45 | -0.9% |
| git | 14.12 | 156.56 → 155.28 | 345.22 → 331.88 | -3.9% |
| rg | 6.99 | 80.93 → 81.58 | 389.81 → 394.48 | +1.2% |
| cargo | 47.14 | 103.71 → 101.63 | 459.17 → 460.00 | +0.2% |
| npm | 166.44 | 254.44 → 252.32 | 1236.33 → 1237.97 | +0.1% |
| 启动到退出 | 430.56 | 1187.74 → 1186.28 | 3860.30 → 3809.40 | -1.3% |
新版 VM 整轮 -1.3%,Git -3.9%,metadata +1.7%,其余中位数 变化较小;host staged 整轮 -0.1%。release 整轮 +3.3% 与本批 -1.3% 不一致,不能将任一较快项写成普遍加速。当前 performance VM 遍历约为同批原生的 32.4 倍、小文件写入 62.8 倍、读取 3.6 倍、 npm 7.4 倍。新版 performance 二进制 19.38 MiB,release 14.99 MiB,尺寸约增加 29.3%。
| 操作 | VM 前→后 P95 | VM 前→后 P99 |
|---|---|---|
| metadata | 272.19 → 250.74 | 294.65 → 429.29 |
| read | 263.26 → 239.29 | 336.18 → 308.37 |
| write | 740.64 → 559.34 | 970.78 → 797.87 |
| git | 1096.91 → 1071.94 | 1158.24 → 1095.24 |
| 启动到退出 | 9616.95 → 7328.27 | 9971.15 → 10148.77 |
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-service-20261005/local-performance.tsv
保留逐样本值。以下图中的两个面板属于独立批次,均对比各自同编译配置的
旧版与新版;不是同批 release/performance A/B,也不是单机制收益。
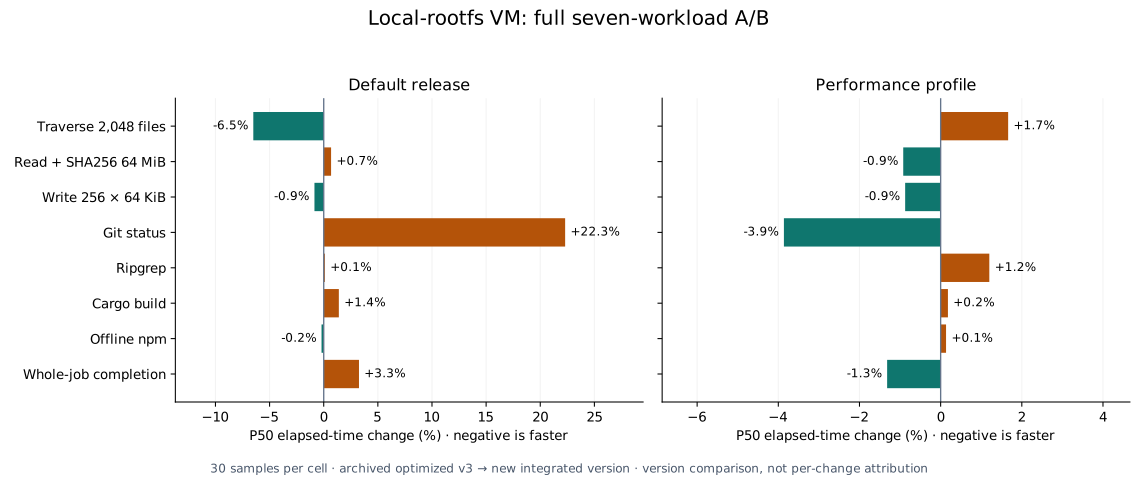
Lazy 镜像:移除中间宿主 FUSE 的冷/热对照
两边使用 performance(opt-level=3)制品,通过本地 Unix socket 的缓存 v1 协议 fixture 读取同一不可变 rootfs。缓存服务使用 Python,在独立物理核 2,3 上响应并校验内容摘要;VM 与 runner 固定在 0,1。没有注入网络延迟, 这不是公网、TCP/S3、registry 下载或生产 Rust 缓存服务的吞吐评测。 一分钟宿主 load 为 1.00 → 1.85。
每轮随机选择版本顺序,每个版本先冷、后热:冷运行使用全新的客户端内容/ 元数据缓存,热运行复用其磁盘缓存,但重新启动 guest、后端投影及 upper。 宿主页缓存不清空。脚本在工具启动后固定等待 1.2 s,之后依次测试首次遍历、 立即重复遍历、首次和立即重复打开/读取、64 MiB SHA256、32 个文件的 copy-up。 “立即重复”表示执行顺序,不保证全部内核缓存命中;默认 TTL 在长操作中 仍可能过期。1.2 s 等待不计入 worker,计入启动到退出,因此整轮百分比 被这一固定等待摊薄。
四格各 3 次预热、30 次测量,另有预检,共 120 个任务、720 个操作测量。 2,048 个小文件分在 32 个目录,每文件 1,023 字节;32 个 copy-up 文件写为 17 字节并读回。全部 guest 内容/属性、Run Bundle VM 隔离、workspace staged 写入和只读源完整性检查通过。宿主挂载监测在旧版全部 60 个测量任务 看到 FUSE,在新版全部 60 个任务未发现其镜像 store 中的 FUSE 挂载。
下表单位 ms,均为 P50;负值表示耗时下降。
| 操作 | 冷缓存前→后 | 变化 | 热磁盘缓存前→后 | 变化 |
|---|---|---|---|---|
| 首次遍历 2,048 文件 | 257.74 → 285.25 | +10.7% | 223.41 → 254.04 | +13.7% |
| 立即重复遍历 | 41.21 → 54.63 | +32.6% | 42.43 → 54.69 | +28.9% |
| 打开/读取/关闭 2,048 文件 | 823.29 → 795.42 | -3.4% | 637.58 → 582.75 | -8.6% |
| 立即重复打开/读取 | 671.61 → 686.14 | +2.2% | 740.57 → 695.84 | -6.0% |
| 64 MiB SHA256 读取 | 189.80 → 185.68 | -2.2% | 124.72 → 116.43 | -6.6% |
| 32 小文件 copy-up 并读回 | 28.30 → 73.41 | +159.4% | 28.83 → 72.56 | +151.7% |
| 启动到退出(含 1.2 s 等待) | 3596.20 → 3678.45 | +2.3% | 3314.47 → 3335.84 | +0.6% |
读路径有局部收益:热缓存 open/read/close -8.6%、64 MiB 读取 -6.6%。 但首次遍历冷/热分别 +10.7%/+13.7%,立即重复遍历 +32.6%/+28.9%, copy-up 耗时变为原来的 2.5–2.6 倍。整轮中位数冷 +2.3%、热 +0.6%, 没有整体加速。缩短调用链并不自动消除后端的元数据投影、内容实体化、 原像记录及同步成本;本批没有单独分解这些成本,不将某项回归归因于其中 某一个机制。
两边每次冷运行的测试数据均为 2,112 次内容读取、69,203,968 字节, 含 2,048 个小文件和 64 个大文件块;加上解释器等 rootfs 内容,共 2,164 次读取、86,924,150 字节。热运行两边都为 0 次内容下载,也 不再查询远端 stat/list。差异不来自新版预先多下载或省略数据校验。
| 操作 | 热缓存前→后 P95 | 热缓存前→后 P99 |
|---|---|---|
| 首次遍历 2,048 文件 | 230.50 → 262.88 | 233.89 → 264.27 |
| 打开/读取/关闭 2,048 文件 | 643.50 → 599.41 | 644.50 → 633.51 |
| 64 MiB SHA256 读取 | 126.19 → 119.56 | 126.61 → 119.89 |
| 32 小文件 copy-up 并读回 | 29.02 → 79.89 | 29.43 → 81.43 |
| 启动到退出(含 1.2 s 等待) | 3335.95 → 3377.97 | 3350.71 → 3438.46 |
热缓存读取尾部有所改善,metadata/copy-up 和整轮尾部则增加。冷缓存旧版
open/read 的 P99 1,628.39 ms、整轮 4,406.78 ms 受到单个慢任务影响;
新版分别 804.34/3,736.05 ms,不能只选择这组尾部写成稳定收益。
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-service-20261005/lazy-performance.tsv
保留全部样本。首次预检因脚本误写 fixture 字节数而失败,修正后的预检和
正式批次分开保存;首次失败没有计入时间分布。
Linux:此前五项优化的完整结果(保留)
下面是本次基线制品的来源,属于此前的独立批次,不能将百分比与本轮 相加,也不能将历史 16 GiB VM 的 5.27 s 到本轮 4.15 s 全部算作重构收益。 最终 v3 将路径索引、目录延迟分配和队列调整等组合起来评测,2 vCPU/ 4 GiB,每格 3 次预热、30 次测量;不单独归因于各项机制。可变 fixture 没有量化不可变镜像 receipt 的复用收益。
| 对照 | VM P50 前→后 | 变化 |
|---|---|---|
| 组合代码优化,release:整轮 | 4,416.25 → 4,236.61 ms | -4.1% |
| 同批:metadata | 194.21 → 169.20 ms | -12.9% |
| 同批:npm | 1,504.83 → 1,395.37 ms | -7.3% |
| 同源 release → performance:整轮,另一批 | 4,233.32 → 3,839.44 ms | -9.3% |
组合 release 的整轮 P95 +2.4%、Git P99 +25.5%;另一批 performance
整轮 P95/P99 分别 -7.9%/-6.9%。结果存在取舍,不能合并成一条速度曲线。
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-optimizations-20261005/code-v3-4g.tsv、
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-optimizations-20261005/profile-v3-4g.tsv
和本地原始记录 docs/src/assets/benchmarks/.data/filesystem-optimizations-20261005/manifest.tsv
保留完整来源;下列内核机制评测和 P0 数据也作为历史批次保留。
Linux:内核机制与并发优化完整评测
本轮先筛选,再沿用文档中的七项完整负载评测;以下不是适配层时间或三次 快实验的外推。实际保留的是父目录 statx 查询合并、只读 OPEN 共享锁,以及 关闭时不读时钟的锁等待/请求池诊断。READDIRPLUS_AUTO 和原有元数据 inline 分派仍保留,没有启用 DAX、writeback 或长期缓存。
已完成的实验
| 实验 | 样本与测量边界 | 结果入口 |
|---|---|---|
| 真实 KVM / 宿主 FUSE 筛选 | 5 轮候选比较,每轮五格,每格预热 1 次、测量 3 次;包含实现修正后的复测 | 筛选与选择、本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/process.tsv |
| release 适配层微基准 | 4 种 lookup/getattr/open/目录 PLUS 负载,每例每制品预热 2 次、测量 8 次;不启动 VM、不挂 FUSE、不记 preimage | 本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/micro-final.tsv |
| 缓存、并发和 guest tmpfs 对照 | 遍历、单/四线程 stat 各测 3 次;64 文件部分写入加读回各测 1 次 | 对照结果、本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/kernel-probe.tsv |
| 同源完整七项 A/B | 五格,每格预热 3 次、测量 30 次;150 个任务、1,050 个工具测量 | 完整分布与结论 |
| 已发布 P0 与最终候选的同批完整对照 | 另五格,每格预热 3 次、测量 30 次;150 个任务、1,050 个工具测量;源码和 staged 隔离类型不同 | 历史制品重测 |
| 独立 profile 与 OPEN 并发回归 | profile 每格 1 次,不计入验收时间;回归验证旧实现阻塞、新只读锁并行、可写锁仍互斥 | 队列与锁诊断、实现与回归 |
五格为 native、基线/候选宿主 FUSE staged、基线/候选 KVM VM。 此前 P0 修改的 N=30 A/B 单独保留,不计入最新两轮的 300 个任务。DAX、writeback cache、FUSE passthrough、FUSE-over-io_uring、 长期 TTL 和替换为 virtiofsd 仅研究了可行性,尚未实施性能 A/B。
快实验与实现选择
所有真实筛选均有五格,每格 1 次预热、3 次测量,使用相同固定源码归档、 firmware 与 fixture,先通过预检。组合实验明确标注,不把不同批次当作 单变量 A/B。筛选结果只能用于选择下一步,不能证明 P95/P99 或整体收益。
| 候选 | VM 遍历 P50 变化 | VM 整轮 P50 变化 | 决定 |
|---|---|---|---|
| 初版合并 statx | +4.8% | +5.9% | 缺失 upper 还重复回退查询;修正后再测 |
| statx 基础上的 OPEN 共享锁 + 元数据线程池组合 | +1.4% | +8.2% | 不升级该组合;npm 本批 +21.8% |
| 强制 READDIRPLUS,关闭 AUTO | -30.6% | +4.5% | Git +93.6%,不全局启用 |
| 修正命名空间错误回退前的 statx + OPEN 共享锁 | -17.7% | +4.2% | 中间版本,保留记录,修正后再测 |
| 修正 statx + OPEN 共享锁 | +5.0% | +1.0% | 正确性通过;交给完整 N=30 判定 |
初版对正常 ENOENT/ENOTDIR 也先 statx 再 metadata,使 absent upper 的额外 查询抵消部分 lower 查询节省。最终版直接返回这两个命名空间结果;不支持 statx、受限查询或缺字段才安全回退,回退不猜测 mount ID、不复用原生父目录。 物理祖先与叶子的检查仍保留,没有引入跨请求属性/权限缓存。
独立 release 适配层微基准每例 2 次预热、8 次测量,再另测一次 profile; 不启动 VM、不挂 FUSE、不记 preimage。深目录 P50 97.52 → 88.16 ms (-9.6%),浅目录 lookup/open/getattr 28.39 → 27.61 ms(-2.8%)。 最终诊断中正常 fixture 没有 statx metadata fallback;深目录省去 33,664 次 独立 mount identity 查询。它证明机制减少重复工作,不能推算 VM 任务收益。
回归测试复现了只读 OPEN 等待独立 backing READ 的旧行为,旧实现失败, 新共享锁实现通过;可写 OPEN 仍等待,lower 内容不变。带 APPEND/TRUNC、 非只读或 kill_priv 的 OPEN,修改、release 和快照仍独占。只读首次观察 继续由逐路径 journal 同步,句柄、descriptor RAM lease、used ring 发布与 冻结排空的契约保持。候选源码与实际工作树五个实现文件摘要一致。
同源完整七项 A/B
两份 release 制品来自固定 bc08f457 归档,差异为上面的实现补丁。
每格 3 次预热、30 次测量,共 150 个任务、1,050 个工具测量,全部
通过原有输出、Run Bundle、隔离类型、lower 无写入和 upper 256 文件检查。
每任务新的 workspace/upper,七项按原顺序执行,五格按固定种子随机交替;
仍为 256×64 KiB 写入、64 MiB 校验、2,048 文件和原 cargo/npm fixture。
热宿主缓存、两个物理核 0,1、VM 2 vCPU/16 GiB,firmware 摘要与 P0 一致。
同源两边 staged 都是 rootless_process,同时验证读/写/non-bypassable
边界;P0 文档的 staged 为 host_process,历史对照另列。亲和性不是独占;
宿主 1 分钟 load 2.02 → 2.70。以下单位为 ms,负值表示耗时下降。
| 负载 | 原生 | staged 前→后 | 变化 | VM 前→后 | 变化 |
|---|---|---|---|---|---|
| metadata | 4.88 | 77.96 → 78.14 | +0.2% | 188.38 → 194.35 | +3.2% |
| read | 32.62 | 69.39 → 68.94 | -0.7% | 154.14 → 156.15 | +1.3% |
| write | 3.89 | 202.64 → 202.92 | +0.1% | 252.50 → 254.62 | +0.8% |
| git | 15.13 | 172.44 → 173.35 | +0.5% | 493.02 → 433.31 | -12.1% |
| rg | 7.76 | 90.78 → 91.63 | +0.9% | 457.09 → 452.03 | -1.1% |
| cargo | 55.25 | 116.54 → 114.56 | -1.7% | 734.07 → 719.18 | -2.0% |
| npm | 175.58 | 267.20 → 263.22 | -1.5% | 1631.39 → 1625.45 | -0.4% |
| 启动到退出 | 468.52 | 1345.29 → 1310.05 | -2.6% | 5298.80 → 5273.93 | -0.5% |
完整结果没有证明普遍加速。staged 整轮 -2.6%,VM 整轮 -0.5%; VM Git 本批 -12.1%,metadata 反而 +3.2%。不能把微基准的 -9.6% 写成 VM 遍历收益,也不能用 Git 一项代表 npm、写入或整个任务。
| 负载 | staged 前→后 P95 | VM 前→后 P95 | staged 候选 P99 | VM 候选 P99 |
|---|---|---|---|---|
| metadata | 84.63 → 88.98 | 254.15 → 270.13 | 97.68 | 296.52 |
| read | 85.22 → 85.02 | 197.53 → 201.65 | 86.04 | 214.19 |
| write | 222.86 → 222.09 | 330.15 → 295.80 | 228.31 | 335.81 |
| git | 206.08 → 197.27 | 814.82 → 776.87 | 226.71 | 796.34 |
| rg | 96.04 → 98.05 | 478.63 → 531.83 | 101.09 | 660.30 |
| cargo | 147.37 → 144.05 | 812.44 → 831.76 | 150.25 | 846.64 |
| npm | 297.90 → 294.31 | 1909.17 → 1947.07 | 306.96 | 2093.77 |
| 启动到退出 | 5633.02 → 3808.26 | 5812.36 → 5766.30 | 5321.95 | 6031.76 |
P95/P99 没有同步改善:候选 VM rg P99 从 526 → 660 ms,npm 从 2001 → 2094 ms,整轮 5917 → 6032 ms;write 的尾部则下降。 staged 完成尾部包含少数较慢任务,且不等于七项 worker 时间之和。 原始分布全部保留,这仍是非独占宿主上的一次完整批次。
与同批 native 比,候选 VM 遍历约 39.8 倍、256 文件写入 65.4 倍、 64 MiB 读取 4.8 倍、npm 9.3 倍。当前主要成本仍是反复目录/属性 操作、小文件写入和 VM 内工具执行,而不是已经被本轮消除。
已发布 P0 制品在同批重测
再将文档发布的固定 P0 候选(a1020d4b + 相同 stdio readiness 修复)与
最终 P1 候选对比:仍是每格 3 次预热、30 次测量,额外 150 个任务、
1,050 个工具测量,全部通过相同检查。沿用原 fixture、firmware 和两核
预算,负载 0.45 → 3.44。单位 ms;这是同批制品对照,两个源码基线
不同,不能把所有差异归因于 statx 或 OPEN。本轮 P0 staged 实际为
host_process,P1 为 rootless_process,两种边界各自严格验证。
| 负载 | P0 → P1 staged P50 | 变化 | P0 → P1 VM P50 | 变化 |
|---|---|---|---|---|
| metadata | 76.26 → 77.26 | +1.3% | 225.02 → 228.47 | +1.5% |
| read | 68.11 → 68.69 | +0.9% | 121.06 → 120.93 | -0.1% |
| write | 198.12 → 200.20 | +1.0% | 240.25 → 253.10 | +5.3% |
| git | 167.50 → 170.04 | +1.5% | 449.65 → 430.24 | -4.3% |
| rg | 89.01 → 89.85 | +0.9% | 465.98 → 460.27 | -1.2% |
| cargo | 111.08 → 111.62 | +0.5% | 654.27 → 625.52 | -4.4% |
| npm | 215.91 → 261.39 | +21.1% | 1662.16 → 1666.95 | +0.3% |
| 启动到退出 | 1224.50 → 1290.69 | +5.4% | 5164.78 → 5187.46 | +0.4% |
第二批 VM 整轮 +0.4%,也未复现整体加速;Git 本批 -4.3%、写入 +5.3%。staged npm +21.1%,在同源 rootless 两边的上一批仅 -1.5%; 这里包含执行边界和其他源码变化,不作本轮文件系统补丁的因果结论。 同一 P1 制品在两批 VM 遍历为 194 / 228 ms、读取 156 / 121 ms, 展示了批次条件对分布的影响,不能择取较快一批或合并百分位数。
文档原 P0 批次的 VM 遍历 195.24 ms 继续保留;本批同一个 P0 制品为 225.02 ms。因此历史发布数到本轮数的差异,也不能直接当作代码收益。 两轮完整评测合计 300 个任务、2,100 个工具测量。当前证据支持减少 重复父目录查询、修复只读 OPEN 的串行约束,尚不支持普遍端到端加速。
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/full-historical.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/historical-summary.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/samples.csv
缓存、并发和 guest-local 对照
独立诊断使用相同 2,048 文件 fixture 重跑遍历,所有“过期后”样本在初始
rglob 之后也等待 1.2 秒。候选 VM 结果如下,单位 ms;tmpfs 已核实为
同一 guest 的 /dev/shm,准备文件不计时。
| 对照 | 每组测量次数 | P50 |
|---|---|---|
| 缓存过期后遍历 → 立即重复遍历 | 3 | 233.11 → 105.11 |
| 单线程 → 四线程分片 stat | 3 | 164.17 → 91.86 |
| 同一 guest tmpfs 上遍历 | 3 | 3.28 |
| 64 文件各八次 1 KiB 写入加读回校验:共享视图 → guest tmpfs | 1 | 69.64 → 2.78 |
立即重复遍历显示缓存有帮助,但仍有明显累计成本;并发提交降低等待, 不能证明 Core 并行执行。部分写入对照只有一次,不作验收收益。Tmpfs 同时排除 virtio-fs、Core、journal 和存储延迟,不能将差额全归因于传输。
另开 profile 批次,不计入验收时间。候选 VM 两个设备的最后检查点为 21,340 / 24,743 inline、357 / 65 pool;pool 排队累计 12.80 / 1.67 ms,完成后等待 used-ring 发布 5.16 / 1.22 ms。 读锁加写锁的获取等待分别累计约 1.09 / 2.55 ms,最大单次小于 0.38 ms。这次诊断没有显示长锁等待,但不测 guest 发出请求到宿主接收 之前的等待,也不能排除 inline 串行服务限制。两个 Core 检查点仍有 121,768 / 169,649 次父目录观察,合并 statx 63,375 / 65,488 次, 没有 fallback 记录。staged 完整 profile 的 341 次 journal fsync 约 119 ms。VM 检查点非 final、不同实例未必同一截止时刻;inclusive span 不相加,这些计数不是完整 syscall census。
初次诊断因只在 runs 下找 Run Bundle 而停止,实际 bundle 在 stage;修正 位置后保留失败批次另开新目录。中间批次的初次遍历尚未等待缓存过期,也 单独保存,最终诊断不混入这批时间。正常写入都在 upper、lower 未写。
后续内核路径优先级
- 目录/属性/负查找缓存与失效通知。 重复遍历仍贵,先为不可变依赖或 单方拥有的树建立缓存契约,再验证 TTL 与 FOPEN_CACHE_DIR。live lower 允许宿主外部修改,现有通道没有主动失效通知,不全局延长缓存。
- 按负载选择 READDIRPLUS 和宿主并发。 AUTO 已存在;强制 PLUS 有取舍。 宿主 fuser 的单个请求循环同步执行回调;VM 只有一个普通队列和一个 hiprio 队列,短 metadata inline,线程池满时暂停普通队列接收。 更换线程池或增加 worker 不自动带来收益,需要测队列和锁等待。 ASYNC_READ/PARALLEL_DIROPS 已由协议层默认协商。
- writeback cache。 可能合并小写入,但必须保证首次修改前 preimage 持久化、终结/导出/快照前排空脏页,以及 partial write、append/truncate 的正确性。内核 I/O 说明
- 数据面与本地文件系统。 DAX 主要减少内容拷贝;本轮没有启用或取得
DAX A/B。FUSE-over-io-uring 适用宿主
/dev/fuse,不是直接替换 VM virtqueue;FUSE passthrough 需要同一内核的 backing FD,也不能直接把 宿主 FD 交给 guest。guest-local tmpfs、只读块镜像/内核文件系统可作为 下一阶段独立方案,但需要保留 staging/记录/恢复契约。 DAX · io-uring · passthrough
验证:Core 97 项(5 跳过)、overlayfs 12 项、VM 294 项(2 跳过)、 基准 25 项通过;三个相关包的 all-targets Clippy 和基准 Ruff 通过。 没有修改或批准 semspec ledger/snapshot。完整样本和失败,不只成功摘要, 保存在下列证据中;macOS、启动、网络和完整 Agent 闭环不由这些数字推算。
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/full-same-source.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/summary.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/process.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/micro-final.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/kernel-probe.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/profiles.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/implementation.patch ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/evidence.tar.gz ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/manifest.tsv
Linux:2026-10-05,P0 真实 VM/FUSE A/B 基线
这次启动真实 KVM VM,并挂载真实宿主 FUSE,补齐上轮适配层微基准的
端到端验证。宿主设备可用,最初沙箱没有暴露 /dev/kvm 和 /dev/fuse。
两份 GNU/Linux release 制品来自同一份 a1020d4b 源码归档,只有
OverlayCore 的 core.rs 不同;二者都加入相同的 guest stdio 端口就绪修复。
可执行文件、firmware、源码补丁和当轮脚本均保存摘要。
“优化后”指该固定候选制品,衡量最近一次跳过不可用 upper 标记探测的 增量收益。归档中已有的其他优化同时存在于两份制品,不属于这次 A/B 的 差异;后续提交也没有自动进入这些测量。
每轮随机交替 native、优化前/后的 FUSE staged 与优化前/后的 VM,共五格;
每格 3 次预热、30 次测量。共 150 个测量任务、1,050 个工具测量,所有
正确性检查通过。每个任务使用新的 workspace/upper,在同一个环境中按顺序
执行七种负载;输入复制不计时。宿主缓存为热缓存,CPU 亲和性固定在两个
物理核 0,1,VM 为 2 vCPU、16 GiB。保留的历史工具环境 fixture 写入
256×64 KiB,共 16 MiB,与 product-v1 写入字节数相同;不同配置不合并
历史百分位数。宿主有并行任务,1 分钟 load average 从 10.38 降至 3.06;
固定亲和性是共同预算,不是独占 CPU。以下是单批筛查数据。
下表是工具内部操作与校验的 P50,单位 ms;负百分比表示耗时下降。
| 负载 | Native | FUSE 前→后 | 变化 | VM 前→后 | 变化 |
|---|---|---|---|---|---|
| metadata | 4.93 | 92.38 → 78.25 | -15.3% | 224.36 → 195.24 | -13.0% |
| read | 32.56 | 68.30 → 67.82 | -0.7% | 116.98 → 117.90 | +0.8% |
| write | 3.90 | 201.36 → 198.92 | -1.2% | 243.10 → 257.16 | +5.8% |
| git | 15.11 | 190.36 → 170.46 | -10.5% | 484.14 → 494.86 | +2.2% |
| rg | 7.66 | 100.80 → 90.58 | -10.1% | 476.92 → 464.97 | -2.5% |
| cargo | 52.92 | 112.30 → 110.11 | -1.9% | 513.46 → 512.74 | -0.1% |
| npm | 173.19 | 221.67 → 217.47 | -1.9% | 1570.05 → 1503.67 | -4.2% |
七项负载合计的启动到退出 P50:native 454.50 ms,FUSE staged 1288.69 → 1230.93 ms(-4.5%),VM 4829.04 → 4777.55 ms(-1.1%)。 元数据收益已在真实路径复现,但不能宣称 VM 的 git、写入或整体任务都有 改善;VM write 和 git 本批反而变慢。小幅变化与写入变化需要在较空闲宿主 上复测,不能仅由一个 P50 判定收益或回归原因。
P95 与剩余成本
同一批样本的 P95,单位 ms。较低中位数没有普遍转化成较低尾延迟:
| 负载 | FUSE 前→后 P95 | 变化 | VM 前→后 P95 | 变化 |
|---|---|---|---|---|
| metadata | 112.02 → 107.34 | -4.2% | 344.81 → 322.87 | -6.4% |
| write | 312.85 → 300.82 | -3.8% | 349.50 → 780.11 | +123.2% |
| git | 294.83 → 378.19 | +28.3% | 892.72 → 1181.58 | +32.4% |
| rg | 153.51 → 172.53 | +12.4% | 604.35 → 850.17 | +40.7% |
| 整轮启动到退出 | 2078.80 → 2152.45 | +3.5% | 6796.10 → 8565.53 | +26.0% |
候选 staged / VM 的整轮 P99 为 13.36 s / 10.46 s,也保留在原始汇总中。 N=30 的尾部受少量慢样本影响,宿主并行负载也未排除;这些是需要复测的 现象,尚不能归因于某项实现修改。当前证据支持元数据路径改善,整体性能 验收仍需较空闲宿主上的重复批次。
与同批 native 比,候选 staged / VM 的 metadata 仍为 15.9 / 39.6 倍; 遍历一次分别多 73 / 190 ms。写入 256 个文件仍需 199 / 257 ms, native 为 3.90 ms;VM 离线 npm 为 1.50 s,native 为 0.17 s。 后续优化应继续针对反复遍历、小文件写入和 VM 工具执行成本。
一次先行预热曾出现 VM 退出码为 0、任务写入完成,但 stdout 没有任何 工作负载标记。基准立即停止,失败报告保留。普通 VM runner 现在声明实际 非终端 stdio 所需的 named ports;guest 在启动工具前等待名称就绪,最多 5 秒,缺失则失败。新增测试覆盖迟到的端口名、稍后新增的端口和缺失端口, 不加入固定启动等待。正式批次的 68 个 VM 运行(含预检与预热)都通过输出 检查。基准还验证实际隔离类型、lower 没有写入、upper 含完整 256 个文件; 制品摘要相同、清单不符、缺样本或中断都不能成为成功的 A/B 汇总。
另开的一次 profiling 不计入上表。候选 VM 两个非空 Core 实例的最后累计 检查点仍分别有 126,034 / 168,027 次物理父目录 metadata 调用、 57,547 / 53,161 次 mount identity 查询尝试。两个 dispatch 检查点为 20,545 inline / 424 pool 和 24,398 inline / 100 pool,各有 2 个 worker。宿主候选的完整 Core profile 有 341 次 journal fsync,累计约 110 ms。Core 的重复物理路径检查、首次观察/写入的 journal 成本,以及 小请求仍走 inline 的调度路径应优先分别验证;单纯增加 worker 或更换 virtiofsd 不能据此认定会消除这些开销。VM profile 缺少 final record,计数 只覆盖检查点之前的工作;嵌套 inclusive span 不相加,admission 不等于排队 等待时间。
验证:guest 5 项、VM 全包 292 项(2 项跳过)、不含 control 的 executor 24 项和基准 24 项测试通过,guest Clippy 与基准 Ruff 通过。当时工作区 较宽 executor 子集另有 9 项 VM control 测试失败,保留在验证归档中,本次 没有修改 control 实现,也不将这些检查算作通过。
从同一源码构建两份 GNU/Linux 制品,仅在两次构建之间应用待测修改;
输出目录必须是新目录。先以 --samples 1 --warmups 0 预检。
python3 benchmark/pvisor/filesystem_ab.py \
  --assets target/reference-env-final-20261004 \
  --baseline /absolute/path/to/pvisor-before \
  --candidate /absolute/path/to/pvisor-after \
  --firmware /absolute/path/to/libkrunfw-directory \
  --output target/filesystem-ab-new \
  --cpu-affinity 0,1 --samples 30 --warmups 3
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-ab-20261005/samples.csv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-ab-20261005/summary.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-ab-20261005/profiles.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-ab-20261005/evidence.tar.gz
历史到 P0 的实测变化(保留)
以下比较 2026-10-04 完整工具环境 N=30 批次与最新候选 N=30 批次,工具 内部 P50,单位 ms。二者沿用保留的工具 fixture,但制品、宿主负载和运行 协议有变化;百分比是跨批次观测差异,不能当作全部优化的受控因果收益。 最近一次修改的增量收益以同批 A/B为准。
| 负载 | 历史→最新 staged | 跨批次差异 | 历史→最新 VM | 跨批次差异 |
|---|---|---|---|---|
| metadata | 180.13 → 78.25 | -56.6% | 310.54 → 195.24 | -37.1% |
| read | 48.77 → 67.82 | +39.1% | 89.27 → 117.90 | +32.1% |
| write | 189.28 → 198.92 | +5.1% | 144.66 → 257.16 | +77.8% |
| git | 177.81 → 170.46 | -4.1% | 456.21 → 494.86 | +8.5% |
| rg | 144.61 → 90.58 | -37.4% | 545.82 → 464.97 | -14.8% |
| cargo | 112.80 → 110.11 | -2.4% | 549.57 → 512.74 | -6.7% |
| npm | 222.97 → 217.47 | -2.5% | 1727.04 → 1503.67 | -12.9% |
从已有实测看,遍历与搜索耗时下降,读取与写入没有同步改善。此次没有 重新测量 Docker、完整修复任务或真实 Agent CLI 闭环;下面的历史数据保持 原日期与制品,不能用这组文件系统百分比推算它们的最新性能。
本地原始记录 docs/src/assets/benchmarks/.data/reference-env-20261004/summary.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-ab-20261005/summary.tsv
Linux:2026-10-05,OverlayCore 路径解析优化
本次只测 release 模式的 virtio-fs OverlayFs 适配层,不启动 VM、不挂载
宿主 FUSE,也不记录 preimage journal。输入位于 /tmp tmpfs:32 个目录、
每目录 64 个 18 B 文件;深目录案例的父目录深度为 8。每轮使用新的 inode
表,宿主缓存为热缓存,创建输入和适配器不计时。
保存优化前后的测试可执行制品,用 nextest 的 binaries metadata 交替运行 三个批次,顺序为旧→新、新→旧、旧→新。每格每批次 2 次预热、8 次无 profiling 测量,另有 1 次诊断;表中 P50 只来自每版本的 24 次无 profiling 样本。CPU 未固定亲和性,二进制摘要和各批次中位数保存在原始汇总中。
| 适配层操作,2,048 文件 | 优化前 P50 ms | 优化后 P50 ms | 耗时下降 |
|---|---|---|---|
| lookup + getattr | 35.15 | 26.35 | 25.0% |
| lookup + open + getattr + release | 37.61 | 28.07 | 25.4% |
| 深目录 lookup + open + getattr + release | 170.51 | 96.85 | 43.2% |
| opendir + readdirplus + releasedir | 29.00 | 20.24 | 30.2% |
修改位于共享 OverlayCore:候选 upper 的物理父目录刚被检查为不存在或 非目录时,直接跳过该候选的 whiteout/opaque 标记探测。没有跨请求缓存 属性或不存在结果,后续路径组件和最终物理祖先仍重新检查。深目录诊断中, whiteout 与 opaque 探测各从 38,016 次降至 4,352 次。标记不会通过 upper 祖先符号链接影响 lower 可见性;新增测试还验证同一遍历中新出现的 upper 目录与 whiteout,以及请求之间的 upper 内容变化。
Core/host 适配层 106 项测试和 virtio-fs/descriptor/文件系统快照 57 项
测试通过,三个相关包的 Clippy 全 targets 检查通过。最初沙箱未暴露 /dev/kvm
和 /dev/fuse,当时 VM 全包测试在 KVM 初始化处失败;该微基准没有测
真实 VM/FUSE、journal/文件内容读写和 macOS。后续宿主设备验证与端到端
复测见本页 P0 基线。两个制品之间
工作区另有 VM 重构,适配层案例不执行 UART/VMM/CPU 初始化;制品摘要
是本次测量身份依据。以上降幅不能替代下方历史工具工作负载的重新测量。
复现单版本适配层测量:
cargo nextest run --locked --release -p pvisor-vm \
  --run-ignored only --no-capture -E 'test(small_file_adapter_benchmark)'
本地原始记录 docs/src/assets/benchmarks/.data/overlay-resolution-20261005/samples.tsv · 本地原始记录 docs/src/assets/benchmarks/.data/overlay-resolution-20261005/summary.tsv
Linux:2026-10-04
完整 Ubuntu 的工具内部对照
下表排除新环境开机,只计操作与结果校验。新批次每格 N=10、3 次预热;相同 fixture、两核预算、VM 16 GiB。pVisor 使用宿主目录和 staged virtio-fs,Ubuntu 使用官方 generic 内核、发行版工具和私有 ext4。旧 Docker N=30 矩阵继续保留,不合并百分位数。
| Workload | Native P50/P95 ms | pVisor staged P50/P95 ms | pVisor VM P50/P95 ms | Ubuntu P50/P95 ms |
|---|---|---|---|---|
| metadata | 4.85 / 5.11 | 177.80 / 195.52 | 291.82 / 359.75 | 18.64 / 19.90 |
| read | 33.29 / 48.97 | 48.12 / 61.21 | 88.83 / 127.21 | 115.51 / 117.69 |
| write | 3.75 / 4.43 | 186.95 / 208.86 | 134.37 / 154.03 | 36.07 / 36.35 |
| git | 14.66 / 17.07 | 172.18 / 194.52 | 613.69 / 807.73 | 136.50 / 140.81 |
| rg | 7.58 / 10.90 | 140.52 / 145.52 | 521.65 / 554.49 | 20.40 / 22.89 |
| cargo | 52.79 / 57.17 | 104.21 / 131.18 | 563.24 / 658.37 | 969.09 / 977.41 |
| npm | 218.82 / 245.85 | 256.29 / 292.67 | 2260.17 / 2408.63 | 1079.89 / 1110.93 |
可以据此定位遍历、搜索、编译和安装的实际等待;不能由某一个读取数字得出 block device 总是比 FUSE 快。数据同时改变了内核、工具版本、文件系统和暂存语义。长任务选型更应结合 worker 与完整闭环,而不是只比较开机时间。
本地原始记录 docs/src/assets/benchmarks/.data/full-ubuntu-20261004/samples.csv · 本地原始记录 docs/src/assets/benchmarks/.data/full-ubuntu-20261004/summary.tsv · 方法与复现
完整工具环境的 Docker 基线
新增同机 Docker Engine 实测,不再借用 Podman 数字。相同两核预算与输入、每格 30 次、3 次预热;fixture 与首版相同,七种操作在一个新环境中依次执行。表中只计操作和校验,不含环境启动;整体修复任务另见完整环境。两个批次分别保留,不合并百分位数。
| Workload | Native P50/P95 ms | Docker P50/P95 ms | pVisor staged P50/P95 ms | pVisor VM P50/P95 ms |
|---|---|---|---|---|
| metadata | 5.04 / 6.78 | 5.06 / 7.50 | 180.13 / 202.88 | 310.54 / 351.59 |
| read | 33.07 / 41.44 | 33.24 / 45.06 | 48.77 / 61.60 | 89.27 / 99.34 |
| write | 3.96 / 5.09 | 3.95 / 5.65 | 189.28 / 204.67 | 144.66 / 164.67 |
| git | 15.75 / 20.50 | 16.07 / 20.07 | 177.81 / 195.97 | 456.21 / 786.35 |
| rg | 7.98 / 11.81 | 8.03 / 9.63 | 144.61 / 159.00 | 545.82 / 673.25 |
| cargo | 58.71 / 70.16 | 56.40 / 73.75 | 112.80 / 140.81 | 549.57 / 659.23 |
| npm | 183.46 / 197.57 | 231.45 / 288.60 | 222.97 / 256.33 | 1727.04 / 1978.79 |
这些数字给出具体位置:Docker 的 metadata/read/write 接近原生;staged 遍历小文件比 Docker 多约 175 ms,64 MiB 读取多约 16 ms。读取一次只多十几毫秒,反复遍历小文件会累积明显成本。VM 的离线 npm 安装约 1.73 秒,Docker 约 0.23 秒,这条路径仍有明显差距。不能用约 86 ms 的 VM 启动时间替代这个工具预算。
任务核对文件数量/大小、SHA256、Git clean、搜索命中、编译结果与安装包数量。Docker 是 writable bind mount,pVisor 使用 staged 视图;Firecracker/QEMU 在私有 ext4 内执行。文件路径不同是实际部署成本的一部分;这不是相同文件系统只替换 VMM 的因果实验。其他运行时的各操作分布也在本轮汇总中。
配置与复现 · 本地原始记录 docs/src/assets/benchmarks/.data/reference-env-20261004/samples.csv · 本地原始记录 docs/src/assets/benchmarks/.data/reference-env-20261004/summary.tsv · 本地原始记录 docs/src/assets/benchmarks/.data/reference-env-20261004/evidence.tar.gz · 本地原始记录 docs/src/assets/benchmarks/.data/reference-env-20261004/compatibility.tsv
首版 Linux 矩阵:独立批次
| Workload | Backend | N | Worker P50 ms | vs native | Wall P50 / P95 / P99 ms |
|---|---|---|---|---|---|
| metadata | native | 30 | 4.84 | +0.0% | 23.44 / 29.17 / 30.71 |
| metadata | host | 30 | 4.94 | +2.0% | 34.02 / 44.90 / 58.18 |
| metadata | staged | 30 | 149.60 | +2988.5% | 225.03 / 295.08 / 314.55 |
| metadata | safe | 30 | 171.26 | +3435.6% | 288.73 / 346.47 / 363.59 |
| metadata | vm | 30 | 263.08 | +5331.3% | 636.44 / 828.38 / 892.94 |
| metadata | podman | 30 | 4.95 | +2.1% | 138.99 / 158.58 / 159.34 |
| metadata | container | 30 | 4.83 | -0.3% | 320.21 / 419.26 / 479.51 |
| read | native | 30 | 32.66 | +0.0% | 52.81 / 125.98 / 143.36 |
| read | host | 30 | 31.80 | -2.6% | 64.65 / 213.37 / 232.88 |
| read | staged | 30 | 40.76 | +24.8% | 95.24 / 338.92 / 378.04 |
| read | safe | 30 | 41.38 | +26.7% | 153.98 / 386.69 / 390.96 |
| read | vm | 30 | 100.58 | +208.0% | 476.56 / 1379.77 / 1436.40 |
| read | podman | 30 | 32.68 | +0.1% | 170.64 / 408.95 / 452.05 |
| read | container | 30 | 33.57 | +2.8% | 405.55 / 945.63 / 1092.93 |
| write | native | 30 | 3.81 | +0.0% | 22.95 / 26.54 / 55.29 |
| write | host | 30 | 3.81 | -0.1% | 34.16 / 46.23 / 93.69 |
| write | staged | 30 | 192.46 | +4945.6% | 252.61 / 444.20 / 812.30 |
| write | safe | 30 | 199.56 | +5131.6% | 312.83 / 549.31 / 762.48 |
| write | vm | 30 | 114.68 | +2906.4% | 476.94 / 694.88 / 1003.73 |
| write | podman | 30 | 3.76 | -1.4% | 139.68 / 151.53 / 340.87 |
| write | container | 30 | 3.82 | +0.1% | 356.89 / 406.97 / 627.19 |
| git | native | 30 | 14.72 | +0.0% | 36.14 / 79.21 / 165.50 |
| git | host | 30 | 14.51 | -1.4% | 54.34 / 65.11 / 92.63 |
| git | staged | 30 | 203.33 | +1281.7% | 333.16 / 458.84 / 1316.66 |
| git | safe | 30 | 225.99 | +1435.7% | 394.38 / 491.36 / 960.78 |
| git | vm | 30 | 535.06 | +3536.0% | 929.22 / 1558.97 / 2447.31 |
| git | podman | 30 | 15.55 | +5.7% | 158.87 / 209.35 / 215.16 |
| git | container | 30 | 15.78 | +7.2% | 375.18 / 434.76 / 490.77 |
| rg | native | 30 | 6.72 | +0.0% | 26.54 / 28.70 / 29.90 |
| rg | host | 30 | 6.64 | -1.2% | 44.01 / 44.79 / 45.02 |
| rg | staged | 30 | 167.90 | +2399.9% | 288.07 / 312.76 / 320.23 |
| rg | safe | 30 | 190.82 | +2741.2% | 349.80 / 380.69 / 389.61 |
| rg | vm | 30 | 340.98 | +4976.9% | 717.00 / 769.33 / 780.18 |
| rg | podman | 30 | 5.90 | -12.2% | 141.36 / 154.73 / 160.82 |
| rg | container | 30 | 6.39 | -4.8% | 355.33 / 390.96 / 395.69 |
| cargo | native | 30 | 49.09 | +0.0% | 67.21 / 84.93 / 86.36 |
| cargo | host | 30 | 47.07 | -4.1% | 83.86 / 94.88 / 95.49 |
| cargo | staged | 30 | 90.31 | +84.0% | 146.28 / 167.31 / 168.42 |
| cargo | safe | 30 | 96.00 | +95.6% | 188.83 / 209.83 / 224.90 |
| cargo | vm | 30 | 541.56 | +1003.1% | 897.61 / 959.14 / 959.43 |
| npm | native | 30 | 157.56 | +0.0% | 175.60 / 205.84 / 434.16 |
| npm | host | 30 | 156.38 | -0.7% | 184.73 / 204.95 / 552.20 |
| npm | staged | 30 | 187.87 | +19.2% | 235.76 / 256.13 / 608.48 |
| npm | safe | 30 | 232.30 | +47.4% | 318.58 / 432.25 / 708.12 |
| npm | podman | 30 | 208.41 | +32.3% | 339.64 / 474.65 / 857.37 |
| npm | container | 30 | 195.29 | +23.9% | 515.88 / 552.03 / 891.62 |
分析
暂存视图的连续读取约 +25%,离线 npm 约 +19%;元数据约 31 倍、写小文件约 50 倍。倍率很大,也要同时看原生只有几毫秒和增加约 150–190 ms 的绝对值。host 几乎没有 worker 开销,总时长仍增加 CLI 与记录成本。safe 再增加命名空间、限制和代理准备;VM 多数整项任务在约 0.5–1 秒量级。
该历史批次的 OCI 对照使用 Podman,当时 Docker daemon 不可访问;后续已补充 rootless Docker Engine 的 bind-mount 数据,见上方完整环境对照。Docker overlay2 和 Docker Desktop 仍未测量。pVisor OCI 每个 Job 准备私有 rootfs,wall 反映这个成本;worker 单独显示工具执行成本。
工具兼容性补测
主批次容器 cargo 缺少链接启动文件,是镜像准备错误;补齐 glibc/GCC 文件后发现 Fedora 链接脚本还要求 /lib64/libmvec.so.1;最终补全该路径的 cargo-ready 批次全部通过,单独呈现,前两次镜像错误保留在报告。VM 的 1 GiB 配置会使 Node V8 地址空间预留失败;补测使用 16 GiB 地址空间配置,与 1 GiB 主批次分别列出。
| Workload | Backend | N | Worker P50 / P95 / P99 ms | Wall P50 / P95 / P99 ms |
|---|---|---|---|---|
| cargo | native | 30 | 52.90 / 65.79 / 76.17 | 71.96 / 89.41 / 103.04 |
| cargo | host | 30 | 52.60 / 70.49 / 75.30 | 84.38 / 111.79 / 124.56 |
| cargo | staged | 30 | 116.07 / 139.93 / 233.90 | 166.65 / 210.57 / 397.55 |
| cargo | safe | 30 | 119.77 / 138.77 / 228.23 | 209.92 / 242.16 / 342.22 |
| cargo | vm | 30 | 567.42 / 1365.43 / 2047.17 | 1271.15 / 2683.43 / 3889.27 |
| npm | native | 30 | 162.86 / 433.44 / 488.04 | 181.47 / 472.60 / 531.93 |
| npm | host | 30 | 163.56 / 430.53 / 475.14 | 205.34 / 522.04 / 595.23 |
| npm | staged | 30 | 213.17 / 437.03 / 612.15 | 266.48 / 544.87 / 780.57 |
| npm | safe | 30 | 256.70 / 717.56 / 777.67 | 339.63 / 983.34 / 1085.49 |
| npm | vm | 30 | 985.29 / 3238.12 / 4617.06 | 1661.91 / 5172.18 / 5755.11 |
| npm | podman | 30 | 217.06 / 547.44 / 833.45 | 365.17 / 883.42 / 1239.59 |
| npm | container | 30 | 202.48 / 587.65 / 601.74 | 550.89 / 1368.06 / 1469.75 |
| Cargo corrected /lib64 image | N | Worker P50/P95/P99 ms | Wall P50/P95/P99 ms |
|---|---|---|---|
| native | 30 | 51.52 / 59.70 / 62.44 | 70.85 / 80.25 / 82.02 |
| podman | 30 | 49.29 / 54.35 / 55.75 | 181.18 / 187.71 / 189.70 |
| container | 30 | 51.99 / 57.94 / 59.96 | 405.08 / 425.10 / 425.46 |
边界与下一轮
VM 主批次使用 host rootfs / 和 2 vCPU/1 GiB,并提供宿主只读视图;这是工具兼容性配置,不能据此宣称宿主敏感文件不可读。隔离配置另见隔离验证。这些小型、热缓存、离线任务不是完整大仓库构建,也不是冷磁盘吞吐。Linux FUSE 已测,macFUSE/FSKit、真实 registry 安装与 Docker/overlay2 留给后续同协议测量。
来源与复现
批次归档约定见实验记录索引。
python3 benchmark/pvisor/product_v1.py \
  --binary /absolute/path/to/gnu-linux/pvisor \
  --firmware /absolute/path/to/libkrunfw-directory \
  --replay-binary /absolute/path/to/pvisor-replay \
  --output target/product-benchmark-new \
  --suites filesystem --samples 30 --warmups 3
harness 环境、预检与失败分类约定同端到端任务分析的复现节;本地原始记录批次同为 product-v1-20261004,当轮制品 SHA256 是身份依据。