文件系统性能:技术分析与实验记录
当前 Linux HOST 内核缓存能力与证据
显式所有权契约下,Linux HOST API 支持可写 Metadata 和只读 MetadataAndData;当前源码的正确性测试与独立请求计数有效,正式性能验收仍受阻。 内核缓存与下方不可变 lower 的服务端物理元数据缓存是独立机制,均不自动改变产品执行器默认配置。
策略与准入契约
pvisor_overlayfs::api::OverlayMountConfig.kernel_cache 显式选择策略;默认行为保持不变,无环境变量自动开启扩展策略。
| 策略 | entry/attr TTL | negative TTL | 普通文件打开与范围 |
|---|---|---|---|
Disabled(默认) |
原有 1 秒 | 0 | 无 KEEP_CACHE;保留旧默认 |
Uncached |
0 | 0 | 无 KEEP_CACHE;显式 metadata-cache-off 对照 |
Metadata |
配置值,0 < TTL <= 60s |
同配置值 | 无 KEEP_CACHE;支持 Linux HOST 可写视图 |
MetadataAndData |
配置值,0 < TTL <= 60s |
同配置值 | 仅稳定只读普通文件设置 KEEP_CACHE;可写配置明确拒绝 |
配置 TTL 默认 60 秒,Disabled/Uncached 忽略该值。Uncached 不启用 DIRECT_IO,打开句柄内仍有普通内核页缓存;所有策略均不启用 writeback caching。
扩展策略要求所有物理 lower 按顺序显式声明 Immutable,OwnedViewContract 两项断言均为真,读取语义显式为 StableView,启用 default_permissions 且 FUSE 仅允许 owner 访问。内容、命名空间、权限、ownership、xattrs、hardlink 别名、物理祖先和挂载身份必须保持稳定;upper/work 仅允许此 adapter 修改,并独占至实际卸载。读取也不得改变 backing atime:merged mount 的 NoAtime 不能替代真实 backing 的 noatime 或等价保证。只读挂载、镜像摘要与 advisory lock 都不能证明这些条件。adapter 持有 canonical upper/work 目录对象的非阻塞独占 flock,仅协调合作的 opt-in 会话,不阻止宿主旁路写入。
准入在准备 I/O 前拒绝 journal/preimage、compact journal 初始化、read metrics sink、所有自定义 path policy(包括绑定上下文)及 exclusions,不降级或静默跳过观察。StableView 接受缓存命中不进入 callback,不提供逐 read 审计、首次内容观察日志、snapshot 或 review 兼容性。macOS 和 VM 不支持扩展策略;virtio-fs 尚无等价已验证通知输出通道,该 DTO 不传播到 runtime/VM 配置。
Mutation effects 与失败边界
mutation 前后均收集精确 effects,包括已部分 copy-up 或修改 upper 后失败的请求。effects 覆盖已知对象 inode、hardlink 别名、父目录/祖先属性和精确 namespace entry;rename/exchange/removal 包含已知子树、替换对象及旧/新 entry,不将父目录属性变化扩散为无关 sibling entry 淘汰。覆盖 create/mknod/mkdir/symlink、unlink/rmdir、rename/exchange、link、可写 open/copy-up/O_TRUNC、write、setattr、xattrs、fallocate 和 copy_file_range。
copy-up 与递归目录 materialization 将新物理对象绑定回已有 FUSE 身份。晚发现的 lower hardlink 别名通过 Core owner-session 的 copied_hard_link_metadata 映射取得当前 upper 身份与属性;映射在 adapter FORGET/reclaim 后仍有效,lookup/readdirplus 必要时 materialize upper 别名并记录 effects。该映射仅属当前 Core owner/session,不跨 rebuild、重新构造或新会话持久化;adapter inode 表或 canonical path 不能替代它。
mutation 开始前增加 pending,此后 metadata/entry 回复(包括 mutation 回复)暂用零 TTL。独立 reply worker 对受影响 inode 执行 metadata-only inval_inode(ino, -1, 0) 后发送回复;Linux 协作 mutation 路径处理直接 dentry/page-cache 更新。独立 entry worker 随后异步发送额外 inval_entry(parent, name) 并再次过期属性;全部批次完成后才恢复长 TTL。entry 通知不保证先于 syscall 返回,reply worker 不等待 entry worker,FUSE callback 不等待 worker、不发通知、不卸载。可写 inode 不做 blanket data invalidation,避免等待脏页/相关 write;Metadata 不使用 KEEP_CACHE。
WRITE 使用请求的当前 open flags,支持动态清除/恢复 O_APPEND。COPY_FILE_RANGE 在 positional copy 前清除 backing fd 的旧 O_APPEND,无需先发生 WRITE;部分复制后遇到错误返回已写字节数,使内核获知实际修改。
reply/entry 队列各限 256 批,stop 队列限 513 项,全局最多 512 个 mutation 批次;每 effects plan 最多 4096 个 inode/entry key 加一个 overflow sentinel。溢出、worker panic 或通知错误(无害 ENOENT 除外)停止会话,upper 已发生的修改不回滚。可写准入要求真实 fusectl abort endpoint,并在实际 mountpoint 用临时挂载验证 detach→abort;mount() 返回前不得启动用户。
失败 worker 先 detach 并核对 mountinfo,再写 connection abort;detach 失败不写 abort。helper、termination、worker join 和 shutdown 均有有界等待,shutdown 外层限 15 秒,致命终止失败会结束 server 进程。单次 notifier 调用没有独立 deadline;终止时限不保证每个 mutation syscall 都在该时限内结束。abort/server death 不能撤销其他进程的暖缓存,成功 detach 也不能撤销已持有 fd;EIO 不是通用卸载 fence。调用方必须监督并停止全部用户、释放 fd、保留 backing 供恢复,不允许导出 bind/namespace/FD 别名,并维持 namespace、凭据、helper 与卸载权限。实验失败路径已观察到 namespace kill 后 FUSE task 等待 request_wait_answer;简单进程终止探针不证明所有 FUSE 等待都可立即有界清理。
当前验证与测量范围
2026-10-07,定向验证记录:pvisor-overlayfs 58 passed / 9 skipped,pvisor-overlay-core 124 passed / 5 skipped;显式执行的真实 mount 测试 7 passed。回归覆盖 inode 回收后的 late-hardlink 身份、动态 APPEND 与 positional copy、部分复制失败。独立源码复核未在这两项身份和复制修复中发现新的阻断问题;验证范围不包含全面审计或性能验收。
B-FS-ENG 计划以同一新冻结 release 二进制比较 native、legacy-writable、Metadata-writable60s、Metadata-readonly60s 与 MetadataAndData-readonly60s,每格 3 warmups、30 samples,CPU 0,1、seed 4207,2048 个字节校验文件、32 个半深路径分支。可写对照保持视图语义相同,KEEP_CACHE 归因仅比较两个只读条件。hot/readsearch/TTL 操作前即时预热;TTL 窗口在计时外等待 1.1 秒,不测试 60 秒过期。
所有 native/lower/upper/work 均位于私有 user/mount/PID namespace 的真实 noatime,nosuid,nodev,mode=0700,size=512m tmpfs。live mountinfo/device 与物理 file/directory 的 past-atime 反复读取检查覆盖 upper/work 等 backing,证实 atime 不变;仅设置 merged NoAtime 或未来 atime 不算 physical proof。RAM backing 的证据不能推广到磁盘性能/持久化、VM、pvisor run 或 review。
| 证据 | 当前源码状态 |
|---|---|
| 五条件预检,n=1/cell | 通过 |
| 正式计时,3 warmups + 30 samples/cell | 三个整批均被并行 Cargo checks 污染并拒绝;accepted=0 |
| P50、耗时变化及 bootstrap 95% CI | 未验收;25 个计划 cell 的统计值均留空 |
| 独立 B-FS-DIAG profile,n=3/case | 有效,仅用于请求计数 |
独立 profile 保留 90 个新诊断 case、5 个持续正确性进程、95 个日志及 152 个唯一 final 实例;累计 checkpoint 由各实例最后记录替换,不相加。下表摘自派生 CSV,为每种条件三次诊断的请求中位数(范围均等于中位数);warm 增量减去同轮独立 fresh mount 的 prime-only,单位为 callback 次数,不包含时间。
| 操作 / 计数范围 | 条件 | LOOKUP | GETATTR | OPEN | READ |
|---|---|---|---|---|---|
| hot / warm 增量 | legacy-writable | 0 | 4096 | 4096 | 4096 |
| hot / warm 增量 | metadata-writable | 0 | 4096 | 4096 | 4096 |
| hot / warm 增量 | metadata-readonly | 0 | 0 | 4096 | 4096 |
| hot / warm 增量 | metadata-and-data-readonly | 0 | 0 | 4096 | 0 |
| TTL 窗口 / warm 增量 | legacy-writable | 2192 | 2049 | 4096 | 4096 |
| TTL 窗口 / warm 增量 | metadata-writable | 0 | 4096 | 4096 | 4096 |
| readsearch / warm 增量 | metadata-readonly | 0 | 0 | 2048 | 2048 |
| readsearch / warm 增量 | metadata-and-data-readonly | 0 | 0 | 2048 | 0 |
| hot / fresh mount 完整生命周期 | metadata-and-data-readonly | 2192 | 1 | 8192 | 2048 |
计数支持延长 TTL 避免此窗口的重复 LOOKUP,以及只读 KEEP_CACHE 消除暖操作 READ callback;可写 Metadata 的 GETATTR/OPEN/READ 并未消失。完整生命周期仍包含初次读取,零暖 READ 不表示无物理读取或零任务成本。诊断耗时不进入正式分布,失败批次不拼接,旧源码 noatime 性能不替代最新源码验收;下方独立 immutable-cache 的有效结果保留其原始测量范围。
正式验收状态 CSV · 独立请求计数 CSV · 工程报告 · 复现与证据契约。两个 CSV 均为直接复制的派生数据,保留来源/二进制摘要与统计口径;原始样本、日志、冻结源码与回执留在 benchmark/pvisor/.data/,不发布到站点或改写历史结果。
不可变 lower 的物理元数据缓存
真实 Linux FUSE 的同制品 A/B 中,缓存使读密集操作的中位耗时下降约 24%–26%,新进程、挂载、工具执行到卸载的任务下降 19.6%。 这是 B-FS-ENG 工程实验,不是数量级提升,也不证明 OCI、VM、完整 Agent 任务或带审查日志的 staged 执行有同等收益。
契约与实验设计
每个 lower 用 LayerMutability::{Mutable,Immutable} 声明;默认可变。不变性由调用方保证整个服务生命周期内的内容、元数据、命名空间、父目录和挂载身份稳定,包括 hardlink 别名。缓存只保留成功的物理 lower 元数据,最多 4096 条;upper、更高优先级可变层、whiteout/opaque、访问策略和首次观察仍检查。内核的一秒 TTL、KEEP_CACHE 和读取观察语义未改动。
OCI 解包缓存的宿主目录仍可写,lazy 镜像的本地投影会按需变化,故当前没有自动升级这些来源;宿主 rootfs、任意目录和 frozen baseline 也不自动获得承诺。实验使用独占且实际保持稳定的 lower,不能以只读挂载替代所有权保证。
2026-10-07,Ryzen 7 9700X、Linux x86_64、Btrfs,driver 与工具固定 CPU 0,1。2048 个文件、32 个分支,半数路径深嵌套,总 payload 约 1.1 MB;宿主缓存热。四个条件为 native、mutable FUSE、immutable cache-off/on,使用同一冻结 release driver。每格三次预热、30 次正式采样,按固定种子随机交替,共 600 个正式样本,无正式失败。两组 immutable 声明相同,仅关闭/开启服务端缓存;不启用 preimage journal,排除 review/apply 成本。
数据与分析
单位 ms,P50;变化相对相同承诺的 cache-off,95% 区间来自按轮配对 bootstrap。
| 负载 | Native | Mutable FUSE | Cache-off | Cache-on | 耗时变化 | 95% 区间 |
|---|---|---|---|---|---|---|
| 热 metadata/open/read,两次遍历 | 9.34 | 140.01 | 140.86 | 103.96 | −26.20% | [−26.55%, −25.79%] |
| TTL 到期后的两次遍历 | 13.56 | 150.56 | 147.71 | 112.47 | −23.86% | [−25.44%, −22.44%] |
| 单次打开、读取与搜索校验 | 3.36 | 69.72 | 70.31 | 52.80 | −24.90% | [−25.48%, −24.22%] |
| 持续挂载的 Git status、rg 与内容校验 | 19.81 | 202.21 | 203.43 | 154.55 | −24.03% | [−24.69%, −22.98%] |
| 新进程、挂载、工具任务与卸载 | 22.66 | 210.76 | 210.49 | 169.28 | −19.58% | [−20.44%, −19.10%] |
热遍历有未计时预热;TTL 条件在预热后等待 1.1 秒,等待不计时,第二次遍历可以命中内核缓存,因此不是全冷读。写入只用于正确性探针,不提供写性能结论。全部读取验证完整字节;append copy-up、rename、unlink/recreate、whiteout、立即及 TTL 后可见性和 upper 精确清单通过,lower 的完整内容、命名空间和元数据清单前后相同。输入未触发容量淘汰;大仓库、并发、macOS 与 guest 路径未测。
独立 profile 有 24 个实例、全部 final 记录,计时结果不含插桩。持续挂载的 cache-on 相对 off,物理 parent stat 计数下降 49.2%,leaf stat 下降 84.3%;open/read 请求数相同。计数支持减少服务端重复解析,不是减少全部 FUSE 请求或物理磁盘读取的证明;inclusive spans 不相加。cache-on 仍明显慢于 native,长期内核缓存、upper 一致性和映射/缺页路径需分别验证。
正式统计 CSV · 全部实例计数 CSV · 工程报告与复现命令。冻结源码、制品回执、输入清单、失败预检、正式样本和独立 profile 保存在 benchmark/.data/immutable-cache-*,不合并到用户性能分布。
冻结制品的独立计数器诊断
测于 2026-10-06,CPU 0,1,VM 2 vCPU/16 GiB,使用已核验的冻结 CLI、源码、工具输入和固件。七项文件工具和固定修复各测 staged/VM 三次,共十二个有效任务,失败 0;共享输入的完整字节清单在前后相同。保留执行器默认 TMPDIR,每任务使用新的私有空工具缓存;七项工具的 Cargo 临时文件和产物留在独立工作区。stderr 直接写入普通文件,避免非阻塞管道在大段 profile 输出时返回 EAGAIN。启用 profile 和启动计时,耗时不进入用户性能分布。
每次 staged 有 5/5 个 final 实例,VM 有 13/13 个 final 实例,共 108 个,覆盖 rootfs、工作区和 supervisor。以 PID、component、instance 区分记录,只保留每实例最后一份累计快照。源码中的 rootfs/workspace 创建顺序确定 scope;VMM 与 supervisor 的同号实例不能混合。Inclusive span 会嵌套、跨 worker 重叠,不能相加得到总耗时或瓶颈占比。
| Workload / mode | Filesystem | Metric | Median calls | Median inclusive ms |
|---|---|---|---|---|
| Seven tools / staged | workspace | OverlayCore resolve | 14,978 | 144.67 |
| Seven tools / staged | workspace | OverlayCore observe_read | 4,853 | 162.74 |
| Seven tools / staged | workspace | OverlayCore fingerprint_content | 2,157 | 43.26 |
| Seven tools / staged | workspace | journal sync | 5 | 3.07 |
| Seven tools / VM | workspace | OverlayCore resolve | 15,146 | 234.64 |
| Seven tools / VM | workspace | OverlayCore observe_read | 4,840 | 224.98 |
| Seven tools / VM | workspace | OverlayCore fingerprint_content | 2,157 | 64.13 |
| Seven tools / VM | workspace | journal sync | 5 | 2.12 |
| Seven tools / VM | rootfs | OverlayCore resolve | 6,790 | 184.66 |
| Seven tools / VM | rootfs | virtio-fs LOOKUP | 4,802 | 166.51 |
| Seven tools / VM | rootfs | virtio-fs READ | 6,132 | 643.31 |
| Repair / staged | workspace | OverlayCore resolve | 3,126 | 29.45 |
| Repair / VM | workspace | OverlayCore resolve | 2,858 | 39.80 |
| Repair / VM | rootfs | OverlayCore resolve | 6,672 | 180.76 |
七项工具的 VM dispatch/admission 在 rootfs 和工作区分别为 1,260.54 ms、898.64 ms;它围住整个 service_queues,包含 inline 执行,不能称为纯排队或传输。对应 pool_queue_wait 为 13.62 ms、4.09 ms,仍不能将不同 worker 的等待相加为任务耗时。
七项工具的 fingerprint_bytes 中位数为 69,375,893 B,固定修复为 11,286 B,staged/VM 相同。源码在 live lower 的首次内容观察中计算 SHA256;普通 stat/lookup 不触发普通文件内容哈希,frozen baseline 跳过读取日志。Checkpoint 策略将日志持久化移到完成边界;当前七项工具工作区 journal sync 为五次,表中同步 span 约 2–3 ms,计数不支持把逐文件 preimage fsync 当作当前最大的已证实原因。可变 fixture 没有验证 content receipt 复用,也未将读取指纹改成 metadata-only。
默认缓存路径下,六个 VM 诊断中 rootfs CREATE、RENAME、WRITE 均为零,完整 final 记录支持零请求计数。rootfs READ 仍约六千次;其 span 包括服务、锁和调度,不能直接解释为磁盘或传输等待。路径解析、读取观察、工具加载和缓存写入应分别调查。修复任务的读指纹数据量很小,但 rootfs 解析仍有成本;可执行映射探针仅说明短进程的映射路径差异。DAX、长期属性缓存及单一函数的因果收益尚未验证,需要保持访问与暂存语义的工程 A/B 和独立正式计时。
整理后的计数 CSV保留每 filesystem scope 的三次统计、调用范围、完整覆盖和来源摘要;原始日志、冻结 harness、构建回执及整理脚本保存在本地 .data/。相同二进制此前使用管道捕获的诊断有五次 VM 因 stderr EAGAIN 打印 panic 中止;失败证据保留,不计入此表。普通文件捕获仅用于诊断,不能据两种捕获条件的差值推导性能收益。复现见计数器手册。
npm 编译缓存带来的 rootfs 请求
七项工具负载中的 537 次 rootfs 重命名来自 Node/npm 编译缓存。 Linux、CPU 0,1、guest 2 vCPU/16 GiB;相同冻结 CLI、工具输入和固件,以固定种子随机交替默认缓存与禁用缓存。npm --version 和完整七项工具分别使用六个独立新 VM,每个条件三次;共十二个成功 VM、156 个 final 文件系统实例。两组都有相同的 Node 状态探针和事后缓存清点,启用 profile 与 strace,不报告正式耗时或性能收益。
下表是每条件三个 VM 的中位计数;表中各项三次的最小值和最大值均与中位数相同。rootfs 与 workspace 分开,按 PID、组件和实例识别,不能把 supervisor 与 VMM 的同号实例混合。
| 负载 | Node 编译缓存 | 实际缓存文件 | rootfs CREATE | rootfs RENAME | rootfs WRITE |
|---|---|---|---|---|---|
| npm --version | 默认启用 | 70 | 70 | 70 | 70 |
| npm --version | 禁用 | 0 | 0 | 0 | 0 |
| 七项工具 | 默认启用 | 537 | 538 | 537 | 623 |
| 七项工具 | 禁用 | 0 | 1 | 0 | 86 |
Node API 确认默认组缓存目录为 /tmp/node-compile-cache,禁用组状态为 DISABLED。strace 中成功的缓存重命名路径位于 VM 的 root-upper/tmp/node-compile-cache,数量与 rootfs RENAME、copy-up 和实际缓存文件数一致。完整工具负载的输出、256 个写入文件全部字节、未修改的 lower 清单及运行记录均通过检查;共享输入在前后保持一致。关闭缓存只用于请求归因,不是产品优化或用户配置建议,也不能将 537 次请求换算为已验证的毫秒收益。
独立文件系统计数还应覆盖工具缓存,而不只是工作区写入。正式对照需要声明缓存是否跨任务复用、是否为空,以及所在存储;热页缓存与 Node 编译缓存是不同条件。任务内两次 npm 调用可以复用缓存,但不能让不同后端或不同任务意外共享。工作区内的私有空缓存是一个可控口径,不代表所有执行器默认临时目录的性能。
整理后的缓存请求 CSV提供每条件样本数、计数范围、final 覆盖和二进制、源码、输入、tracer、原始报告摘要。原始系统调用、状态输出及审核脚本保存在本地 .data/,不与用户任务耗时合并。
保留 pVisor 默认临时目录的独立诊断同样使用六个新 VM、两个条件各三次,78 个文件系统实例都有 final 记录。guest 内 statfs 返回 0x01021994,确认是实际 tmpfs;默认启用组每次仍产生 537 个缓存文件,而 rootfs CREATE、RENAME、WRITE 都为零。禁用组三项也为零,缓存文件为零。完整工具输出和写入校验通过。这个结果证明缓存生成可以留在默认 tmpfs 中;旧 workload 的 tools_env() 把执行器提供的 TMPDIR 覆盖为 /tmp,将缓存写入转移到 rootfs overlay。诊断次数有限且有插桩,不能据此声称端到端加速;默认临时目录与工作区存储控制需要分别正式采样。
默认临时目录请求 CSV保留独立样本与来源关联,不与 /tmp 诊断合并统计。
FUSE 请求与 stage 服务端成本
四个宿主条件使用同一份核验并冻结的 CLI 和七项工具输入:原生、host 直通、独立重建的 FUSE 直通驱动和 staged。四次预检及三轮随机交替任务全部通过,共十六次。每次逐字节核验 256 个写入文件;staged 的 lower 路径、模式和内容保持不变。直通执行只允许 fixture 中经过核验的工具链路径重写和 Git 索引 stat 信息刷新,索引的全部路径、模式和对象摘要保持一致。每任务空缓存保留执行器 TMPDIR。
驱动使用相同冻结 vendored fuser 字节、release 配置、同步请求循环和一秒 TTL,不启用 writeback 或 keep_cache。它跳过 OverlayCore、访问策略、copy-up 和 preimage 日志,因此是传输对照下限。下表为三个独立插桩任务的请求数中位数,不含预检:
| 工作区请求 | FUSE 直通 | staged host FUSE |
|---|---|---|
| lookup | 3,059 | 3,057 |
| getattr | 452 | 451 |
| read | 5,014 | 5,014 |
| write | 290 | 290 |
| readdir | 464 | 465 |
这五类已计数回调的数量相近。stage 额外执行内部服务工作:14,975 次 OverlayCore resolve 的 inclusive span 中位数为 143.52 ms,4,853 次读观察为 164.30 ms,2,157 次内容指纹为 45.15 ms。这些 span 嵌套、重叠,不能相加或换算为任务耗时占比。这支持把路径解析和读观察成本与内核请求流量分开测试;它不证明直通驱动提供等价语义,也不构成产品提速结论。
整理后的 FUSE 请求与服务计数保留计数范围、组件/实例作用域,以及 CLI、驱动、源码、输入和审计摘要。插桩和抽样资源观察的任务耗时不进入用户延迟表;未知的进程生命周期保留为未知。原始证据放在 .data/,复现方式见 benchmark README。
Stage 持久化计数
独立批次使用相同核验后的 CLI 和工具输入,对照 native、strict、checkpoint。三次预检和三轮随机交替任务通过,共十二次。所有 staged 任务都有要求的策略标记和完成 seal,lower 完整清单不变、写入字节完整,五个文件系统实例均有 final 记录。下表为三个独立插桩任务的单任务中位数,不与 FUSE 直通批次合并。
| 日志操作 | strict 次数 | checkpoint 次数 | strict inclusive ms | checkpoint inclusive ms |
|---|---|---|---|---|
| append | 2,703 | 2,703 | 8.78 | 5.97 |
| transaction | 8,686 | 8,686 | 329.44 | 18.53 |
| sync | 340 | 5 | 313.08 | 3.23 |
Linux 每个日志 sync span 都调用日志文件的 sync_all;目录及其他文件的同步不在此计数内。strict 每任务为 339–340 次,checkpoint 均为五次。transaction 包含同步,耗时不能与 sync 相加。这明确定位了 strict 模式下可观的持久化服务成本。checkpoint 仍记录相同的 2,703 次 append 并检查结束 seal;任务结束前允许日志未同步。这些检查不证明任意崩溃窗口的保证等价,插桩 span 也不证明未插桩任务延迟有同等幅度的下降。工程入口将计时批次独立留存,至少三十轮时输出分布分簇与配对区间。
整理后的持久化计数包含所有组件实例、计数范围及源码/输入/审计摘要。原始报告、stdout/stderr、输出清单和失败的发布审计尝试留在本地 .data/。
可执行文件映射的独立诊断
相同 rg --version 的 ELF、loader 和全部动态库,分别从 virtio-fs 文件与 executable memfd 执行。Linux、继承宿主 CPU 0,1 亲和性,guest 配置为 2 vCPU/1 GiB;每种条件三个独立新 VM,每个 VM 执行 50 次,顺序随机交错。十二个 VM、600 次调用全部输出校验通过,每个 VM 的 13 个文件系统实例都有 final 记录。完整预备输入在执行前后校验通过;保留的工作区路径、副本字节、命令、输出及 profile 通过独立审计。profile stderr 直接写入普通文件。构建、输入、固件和原始输出摘要保留在证据目录;这是启用 profile 的诊断,不进入用户任务性能表,也不证明全部后代进程完整生命周期的 CPU 放置。
| 准备来源 | 执行映射 | 首次启动中位数 ms | 重复启动中位数 ms | 重复启动 major faults |
|---|---|---|---|---|
| 原始文件 | virtio-fs | 6.48 | 5.10 | 37 |
| 原始文件 | memfd | 1.56 | 0.73 | 0 |
| 独立 inode 副本 | virtio-fs | 7.93 | 5.07 | 37 |
| 独立 inode 副本 | memfd | 1.27 | 0.73 | 0 |
首次启动统计三个 VM 的第一调用;重复启动先取每 VM 后续 49 次的中位数,再取三个 VM 的中位数,不能把调用数当作独立样本数。两组都先复制并哈希校验相同输入、继承相同 fd;guest /dev/shm 保持 noexec。原始文件准备会预热原 inode;副本准备从不同 inode 读取相同字节,但共同的 Python 准备仍预热解释器及部分库,不能称为完全冷启动。
重复启动的映射差距约 4.4 ms,同时 major faults 从 37 变为 0,支持优先调查可执行文件映射与缺页服务。major fault 计数不等于物理磁盘读取次数;这组替换同时改变了文件映射、路径访问及加载器的请求路径,不能把差距全部归因于 FUSE 传输或 DAX 缺失,也不能按完整 Agent 任务的进程数直接外推收益。生产实现需要保持访问策略、暂存观察与证据语义,再进行独立正式计时。
整理后的执行统计 CSV · 来源与测量边界 CSV。原始报告、逐 VM 输出、审核和整理脚本保存在本地 benchmark/.data/。
合入计划与目标持久化
相同冻结父源码的 CLI-only release 构建,仅合入实现有被执行的源码差异;编译器、292 个依赖编译单元的 features、profile 和 rustflags 一致。CPU 0,1,宿主缓存热,每格三次预热、30 次正式测量,随机交替,每次独立 target/stage;准备排除在合入计时之外。下表来自不启用 profile 或 strace 的 240 个有效样本,改动在同一个目录内。
| 文件数 | 操作 | 基线 P50 ms | 目录索引 P50 ms | 差值的 95% 配对 bootstrap 区间 ms |
|---|---|---|---|---|
| 1,000 | 合入 | 962.12 | 944.09 | −51.16 至 −2.72 |
| 1,000 | 合入前冲突检查 | 46.07 | 21.98 | −24.75 至 −22.98 |
| 10,000 | 合入 | 13,130.25 | 11,031.86 | −2,461.98 至 −1,790.97 |
| 10,000 | 合入前冲突检查 | 2,651.01 | 189.78 | −2,474.89 至 −2,448.60 |
完整原始、暂存和最终内容由冻结 harness 在运行时检查,随后删除生成的 workspace/upper;独立事后审核覆盖保留的构建、命令、退出码、冲突输出和提交 ledger,不能称为再次独立校验了已删除的最终文件。合入前冲突不是合入途中外部写入的覆盖测试,也不是崩溃恢复测试。该工程 A/B 不构成 Git 或其他产品的性能对照。
另一个启用 profile 和 strace 的独立诊断,每格三次,共 24 个有效命令,保留完整退出记录并按 fd 路径分类。两版的同步调用完全相同:
| 合入文件数 | target 文件 fsync | target 目录 fsync | stage fsync | 其他 fsync | 合计 |
|---|---|---|---|---|---|
| 1,000 | 1,000 | 1,003 | 18 | 1 | 2,022 |
| 10,000 | 10,000 | 10,003 | 18 | 1 | 20,022 |
合入前冲突命令的这些调用均为零。目录索引改善了计划阶段,却没有减少目标持久化的调用数;10,000 文件合入仍约 11 秒。按唯一目录在事务边界批量同步值得另做实验,但必须先验证 Prepared、TargetApplied、Committed 的落盘顺序、崩溃恢复和途中外部编辑保护。请求计数证明调用规模,不能证明这些调用占全部剩余时间;strace 用时受插桩影响,不能与嵌套 profile span 相加或用于正式收益表。
正式统计 CSV · 配对差异 CSV · 同步请求统计 CSV · 来源与审核范围 CSV。原始记录和整理脚本保存在本地 benchmark/.data/。
保留的独立工程实验
新版默认 release 的本地 VM 整轮 P50 为 4.15 s(较已优化 v3 +3.3%),遍历 157.57 ms(-6.5%)。lazy 镜像热缓存的打开/读取下降 8.6%、64 MiB 读取下降 6.6%,但元数据遍历变慢、copy-up 约慢 2.5 倍。本轮没有显示普遍端到端加速;完整分布和冷/热条件见新版本评测。
Motivation
Agent 经常反复读目录、搜索和修改文件。应同时看到任务本身和启动、视图准备、记录所需的总时间,才能决定是否值得开启暂存或 VM。
实验设计
最新批次随机交替 native 与优化前/后的 staged、libkrun VM;历史矩阵另含 host、safe、Docker、rootless Podman/crun 与 pVisor OCI。每格通常 3 次预热、30 次测量,热宿主缓存;完整 Ubuntu 补测为 N=10,分别标注。准备镜像和复制输入不计时。worker 包含工具运行与输出校验;wall 包含启动到退出。metadata/git/rg 使用 2,048 文件、32 目录;read 校验 64 MiB SHA256;product-v1 和完整工具环境的 write 均写 256×64 KiB,共 16 MiB;各批次仍按配置分别统计。cargo 编译 64 个无外部依赖的小模块并验证结果 2016;npm 离线安装 32 个本地包,不访问 registry。
macOS
本轮在 Linux 实测,以下工作负载没有 macOS 样本;macFUSE/FSKit 开销与并发容量均未测。既有 macOS/HVF 数据继续保留在 VM 启动时间与VM 内存报告,不移作本页结果。
Linux:统一文件服务重构后的评测
本轮测试使用重构后的冻结源码,host 保留 FUSE,VM 的本地、staged 和 lazy 文件视图由 virtio-fs 接入共享服务;lazy 镜像不再建立中间宿主 FUSE 挂载。实现结构中的协议状态仍 分属两个入口,没有启用 DAX、writeback cache 或长期属性缓存。
对照与测量范围
基线是此前五项优化后的最终 v3 制品,已包含路径索引、目录延迟分配和 请求队列调整,并非 P0 前版本。新版从集成工作树冻结后构建;源码与制品 摘要分别记录。工作树还包含 cluster/service 等同期修改,因此本轮是版本 制品对照,不把全部差异归因于某一个函数或仅归因于移除 FUSE。
两边使用相同 firmware 和完整工具 fixture,2 vCPU/4 GiB,固定物理核 0,1;staged 都要求 rootless_process 及读写隔离。每格 1 次正确性预检、 3 次预热、30 次测量,预检和预热不入分布;每轮随机交替五格,七项工具 按固定顺序运行。普通负载使用本地 rootfs,本来就没有中间宿主 FUSE, 因此单独测 lazy 镜像才能判断该路径重构的效果。宿主缓存热、CPU 非独占, release 批次一分钟 load 为 1.37 → 2.27;未将不同批次样本合并。
默认 release:本地 rootfs 完整负载
下表为 P50,单位 ms,负值表示耗时下降;共 150 个任务、1,050 个工具 测量,原有工具结果、Run Bundle、lower 不被写入及 upper 的 256 文件 检查全部通过。默认 release 为 opt-level=z,两边编译配置相同。
| 操作 | 原生 | host staged 前→后 | VM 前→后 | VM 变化 |
|---|---|---|---|---|
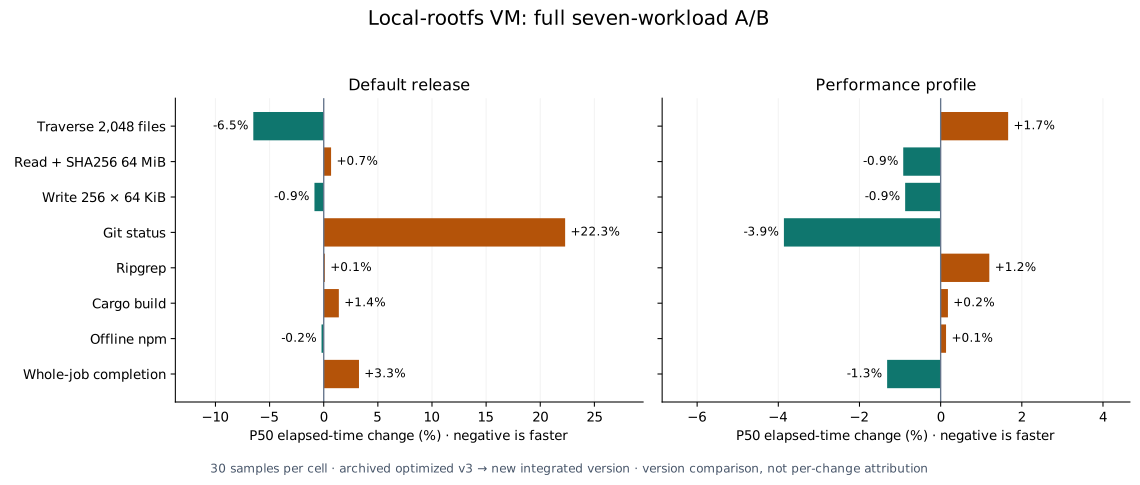
| metadata | 4.58 | 76.14 → 76.29 | 168.53 → 157.57 | -6.5% |
| read | 32.21 | 65.65 → 66.18 | 116.12 → 116.91 | +0.7% |
| write | 3.60 | 200.70 → 200.46 | 245.18 → 243.09 | -0.9% |
| git | 13.79 | 165.87 → 165.75 | 359.63 → 439.83 | +22.3% |
| rg | 6.84 | 89.95 → 90.46 | 448.42 → 448.88 | +0.1% |
| cargo | 46.49 | 102.49 → 102.65 | 488.15 → 494.97 | +1.4% |
| npm | 163.74 | 250.12 → 250.71 | 1337.35 → 1334.66 | -0.2% |
| 启动到退出 | 426.43 | 1240.79 → 1242.06 | 4021.54 → 4152.52 | +3.3% |
新版 VM 遍历中位数下降 6.5%,整轮中位数反而增加 3.3%,Git 增加 22.3%;host staged 整轮仅 +0.1%。本批没有显示本地 rootfs 普遍加速。与同批原生相比,当前 VM 遍历约 34.4 倍、小文件写入 67.5 倍、64 MiB 读取 3.6 倍、npm 8.2 倍,小文件和元数据 仍是需要处理的成本。
| 操作 | VM 前→后 P95 | VM 前→后 P99 |
|---|---|---|
| metadata | 199.59 → 199.24 | 208.31 → 201.96 |
| read | 120.75 → 134.33 | 123.49 → 141.60 |
| write | 260.44 → 269.16 | 262.67 → 272.02 |
| git | 719.48 → 723.31 | 738.35 → 746.02 |
| 启动到退出 | 4384.50 → 4406.12 | 4550.35 → 4469.82 |
遍历尾部略降,但 read/write 尾部升高;整轮 P95 基本持平、P99 略降。
30 样本下 P99 受个别任务影响很大,不能据中位数或单个尾部值宣称稳定收益。
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-service-20261005/local-release.tsv
保留每个任务的七项时间及启动到退出时间。
Performance 制品:同编译配置的本地对照
另一完整批次同样包含 150 个任务、1,050 个工具测量,所有正确性与隔离 检查通过;基线和新版均为 opt-level=3。批次负载 0.93 → 3.87,CPU 非独占。下表单位 ms,均为 P50;不与 release 批次合并分布,也不使用 两批新版 4.15/3.81 s 的差值推算编译优化的因果收益。
| 操作 | 原生 | host staged 前→后 | VM 前→后 | VM 变化 |
|---|---|---|---|---|
| metadata | 4.59 | 67.30 → 67.91 | 146.11 → 148.54 | +1.7% |
| read | 32.12 | 65.60 → 65.41 | 116.28 → 115.21 | -0.9% |
| write | 3.68 | 196.60 → 195.74 | 233.49 → 231.45 | -0.9% |
| git | 14.12 | 156.56 → 155.28 | 345.22 → 331.88 | -3.9% |
| rg | 6.99 | 80.93 → 81.58 | 389.81 → 394.48 | +1.2% |
| cargo | 47.14 | 103.71 → 101.63 | 459.17 → 460.00 | +0.2% |
| npm | 166.44 | 254.44 → 252.32 | 1236.33 → 1237.97 | +0.1% |
| 启动到退出 | 430.56 | 1187.74 → 1186.28 | 3860.30 → 3809.40 | -1.3% |
新版 VM 整轮 -1.3%,Git -3.9%,metadata +1.7%,其余中位数 变化较小;host staged 整轮 -0.1%。release 整轮 +3.3% 与本批 -1.3% 不一致,不能将任一较快项写成普遍加速。当前 performance VM 遍历约为同批原生的 32.4 倍、小文件写入 62.8 倍、读取 3.6 倍、 npm 7.4 倍。新版 performance 二进制 19.38 MiB,release 14.99 MiB,尺寸约增加 29.3%。
| 操作 | VM 前→后 P95 | VM 前→后 P99 |
|---|---|---|
| metadata | 272.19 → 250.74 | 294.65 → 429.29 |
| read | 263.26 → 239.29 | 336.18 → 308.37 |
| write | 740.64 → 559.34 | 970.78 → 797.87 |
| git | 1096.91 → 1071.94 | 1158.24 → 1095.24 |
| 启动到退出 | 9616.95 → 7328.27 | 9971.15 → 10148.77 |
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-service-20261005/local-performance.tsv
保留逐样本值。以下图中的两个面板属于独立批次,均对比各自同编译配置的
旧版与新版;不是同批 release/performance A/B,也不是单机制收益。
Lazy 镜像:移除中间宿主 FUSE 的冷/热对照
两边使用 performance(opt-level=3)制品,通过本地 Unix socket 的缓存 v1 协议 fixture 读取同一不可变 rootfs。缓存服务使用 Python,在独立物理核 2,3 上响应并校验内容摘要;VM 与 runner 固定在 0,1。没有注入网络延迟, 这不是公网、TCP/S3、registry 下载或生产 Rust 缓存服务的吞吐评测。 一分钟宿主 load 为 1.00 → 1.85。
每轮随机选择版本顺序,每个版本先冷、后热:冷运行使用全新的客户端内容/ 元数据缓存,热运行复用其磁盘缓存,但重新启动 guest、后端投影及 upper。 宿主页缓存不清空。脚本在工具启动后固定等待 1.2 s,之后依次测试首次遍历、 立即重复遍历、首次和立即重复打开/读取、64 MiB SHA256、32 个文件的 copy-up。 “立即重复”表示执行顺序,不保证全部内核缓存命中;默认 TTL 在长操作中 仍可能过期。1.2 s 等待不计入 worker,计入启动到退出,因此整轮百分比 被这一固定等待摊薄。
四格各 3 次预热、30 次测量,另有预检,共 120 个任务、720 个操作测量。 2,048 个小文件分在 32 个目录,每文件 1,023 字节;32 个 copy-up 文件写为 17 字节并读回。全部 guest 内容/属性、Run Bundle VM 隔离、workspace staged 写入和只读源完整性检查通过。宿主挂载监测在旧版全部 60 个测量任务 看到 FUSE,在新版全部 60 个任务未发现其镜像 store 中的 FUSE 挂载。
下表单位 ms,均为 P50;负值表示耗时下降。
| 操作 | 冷缓存前→后 | 变化 | 热磁盘缓存前→后 | 变化 |
|---|---|---|---|---|
| 首次遍历 2,048 文件 | 257.74 → 285.25 | +10.7% | 223.41 → 254.04 | +13.7% |
| 立即重复遍历 | 41.21 → 54.63 | +32.6% | 42.43 → 54.69 | +28.9% |
| 打开/读取/关闭 2,048 文件 | 823.29 → 795.42 | -3.4% | 637.58 → 582.75 | -8.6% |
| 立即重复打开/读取 | 671.61 → 686.14 | +2.2% | 740.57 → 695.84 | -6.0% |
| 64 MiB SHA256 读取 | 189.80 → 185.68 | -2.2% | 124.72 → 116.43 | -6.6% |
| 32 小文件 copy-up 并读回 | 28.30 → 73.41 | +159.4% | 28.83 → 72.56 | +151.7% |
| 启动到退出(含 1.2 s 等待) | 3596.20 → 3678.45 | +2.3% | 3314.47 → 3335.84 | +0.6% |
读路径有局部收益:热缓存 open/read/close -8.6%、64 MiB 读取 -6.6%。 但首次遍历冷/热分别 +10.7%/+13.7%,立即重复遍历 +32.6%/+28.9%, copy-up 耗时变为原来的 2.5–2.6 倍。整轮中位数冷 +2.3%、热 +0.6%, 没有整体加速。缩短调用链并不自动消除后端的元数据投影、内容实体化、 原像记录及同步成本;本批没有单独分解这些成本,不将某项回归归因于其中 某一个机制。
两边每次冷运行的测试数据均为 2,112 次内容读取、69,203,968 字节, 含 2,048 个小文件和 64 个大文件块;加上解释器等 rootfs 内容,共 2,164 次读取、86,924,150 字节。热运行两边都为 0 次内容下载,也 不再查询远端 stat/list。差异不来自新版预先多下载或省略数据校验。
| 操作 | 热缓存前→后 P95 | 热缓存前→后 P99 |
|---|---|---|
| 首次遍历 2,048 文件 | 230.50 → 262.88 | 233.89 → 264.27 |
| 打开/读取/关闭 2,048 文件 | 643.50 → 599.41 | 644.50 → 633.51 |
| 64 MiB SHA256 读取 | 126.19 → 119.56 | 126.61 → 119.89 |
| 32 小文件 copy-up 并读回 | 29.02 → 79.89 | 29.43 → 81.43 |
| 启动到退出(含 1.2 s 等待) | 3335.95 → 3377.97 | 3350.71 → 3438.46 |
热缓存读取尾部有所改善,metadata/copy-up 和整轮尾部则增加。冷缓存旧版
open/read 的 P99 1,628.39 ms、整轮 4,406.78 ms 受到单个慢任务影响;
新版分别 804.34/3,736.05 ms,不能只选择这组尾部写成稳定收益。
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-service-20261005/lazy-performance.tsv
保留全部样本。首次预检因脚本误写 fixture 字节数而失败,修正后的预检和
正式批次分开保存;首次失败没有计入时间分布。
Linux:此前五项优化的完整结果(保留)
下面是本次基线制品的来源,属于此前的独立批次,不能将百分比与本轮 相加,也不能将历史 16 GiB VM 的 5.27 s 到本轮 4.15 s 全部算作重构收益。 最终 v3 将路径索引、目录延迟分配和队列调整等组合起来评测,2 vCPU/ 4 GiB,每格 3 次预热、30 次测量;不单独归因于各项机制。可变 fixture 没有量化不可变镜像 receipt 的复用收益。
| 对照 | VM P50 前→后 | 变化 |
|---|---|---|
| 组合代码优化,release:整轮 | 4,416.25 → 4,236.61 ms | -4.1% |
| 同批:metadata | 194.21 → 169.20 ms | -12.9% |
| 同批:npm | 1,504.83 → 1,395.37 ms | -7.3% |
| 同源 release → performance:整轮,另一批 | 4,233.32 → 3,839.44 ms | -9.3% |
组合 release 的整轮 P95 +2.4%、Git P99 +25.5%;另一批 performance
整轮 P95/P99 分别 -7.9%/-6.9%。结果存在取舍,不能合并成一条速度曲线。
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-optimizations-20261005/code-v3-4g.tsv、
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-optimizations-20261005/profile-v3-4g.tsv
和本地原始记录 docs/src/assets/benchmarks/.data/filesystem-optimizations-20261005/manifest.tsv
保留完整来源;下列内核机制评测和 P0 数据也作为历史批次保留。
Linux:内核机制与并发优化完整评测
本轮先筛选,再沿用文档中的七项完整负载评测;以下不是适配层时间或三次 快实验的外推。实际保留的是父目录 statx 查询合并、只读 OPEN 共享锁,以及 关闭时不读时钟的锁等待/请求池诊断。READDIRPLUS_AUTO 和原有元数据 inline 分派仍保留,没有启用 DAX、writeback 或长期缓存。
已完成的实验
| 实验 | 样本与测量边界 | 结果入口 |
|---|---|---|
| 真实 KVM / 宿主 FUSE 筛选 | 5 轮候选比较,每轮五格,每格预热 1 次、测量 3 次;包含实现修正后的复测 | 筛选与选择、本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/process.tsv |
| release 适配层微基准 | 4 种 lookup/getattr/open/目录 PLUS 负载,每例每制品预热 2 次、测量 8 次;不启动 VM、不挂 FUSE、不记 preimage | 本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/micro-final.tsv |
| 缓存、并发和 guest tmpfs 对照 | 遍历、单/四线程 stat 各测 3 次;64 文件部分写入加读回各测 1 次 | 对照结果、本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/kernel-probe.tsv |
| 同源完整七项 A/B | 五格,每格预热 3 次、测量 30 次;150 个任务、1,050 个工具测量 | 完整分布与结论 |
| 已发布 P0 与最终候选的同批完整对照 | 另五格,每格预热 3 次、测量 30 次;150 个任务、1,050 个工具测量;源码和 staged 隔离类型不同 | 历史制品重测 |
| 独立 profile 与 OPEN 并发回归 | profile 每格 1 次,不计入验收时间;回归验证旧实现阻塞、新只读锁并行、可写锁仍互斥 | 队列与锁诊断、实现与回归 |
五格为 native、基线/候选宿主 FUSE staged、基线/候选 KVM VM。 此前 P0 修改的 N=30 A/B 单独保留,不计入最新两轮的 300 个任务。DAX、writeback cache、FUSE passthrough、FUSE-over-io_uring、 长期 TTL 和替换为 virtiofsd 仅研究了可行性,尚未实施性能 A/B。
快实验与实现选择
所有真实筛选均有五格,每格 1 次预热、3 次测量,使用相同固定源码归档、 firmware 与 fixture,先通过预检。组合实验明确标注,不把不同批次当作 单变量 A/B。筛选结果只能用于选择下一步,不能证明 P95/P99 或整体收益。
| 候选 | VM 遍历 P50 变化 | VM 整轮 P50 变化 | 决定 |
|---|---|---|---|
| 初版合并 statx | +4.8% | +5.9% | 缺失 upper 还重复回退查询;修正后再测 |
| statx 基础上的 OPEN 共享锁 + 元数据线程池组合 | +1.4% | +8.2% | 不升级该组合;npm 本批 +21.8% |
| 强制 READDIRPLUS,关闭 AUTO | -30.6% | +4.5% | Git +93.6%,不全局启用 |
| 修正命名空间错误回退前的 statx + OPEN 共享锁 | -17.7% | +4.2% | 中间版本,保留记录,修正后再测 |
| 修正 statx + OPEN 共享锁 | +5.0% | +1.0% | 正确性通过;交给完整 N=30 判定 |
初版对正常 ENOENT/ENOTDIR 也先 statx 再 metadata,使 absent upper 的额外 查询抵消部分 lower 查询节省。最终版直接返回这两个命名空间结果;不支持 statx、受限查询或缺字段才安全回退,回退不猜测 mount ID、不复用原生父目录。 物理祖先与叶子的检查仍保留,没有引入跨请求属性/权限缓存。
独立 release 适配层微基准每例 2 次预热、8 次测量,再另测一次 profile; 不启动 VM、不挂 FUSE、不记 preimage。深目录 P50 97.52 → 88.16 ms (-9.6%),浅目录 lookup/open/getattr 28.39 → 27.61 ms(-2.8%)。 最终诊断中正常 fixture 没有 statx metadata fallback;深目录省去 33,664 次 独立 mount identity 查询。它证明机制减少重复工作,不能推算 VM 任务收益。
回归测试复现了只读 OPEN 等待独立 backing READ 的旧行为,旧实现失败, 新共享锁实现通过;可写 OPEN 仍等待,lower 内容不变。带 APPEND/TRUNC、 非只读或 kill_priv 的 OPEN,修改、release 和快照仍独占。只读首次观察 继续由逐路径 journal 同步,句柄、descriptor RAM lease、used ring 发布与 冻结排空的契约保持。候选源码与实际工作树五个实现文件摘要一致。
同源完整七项 A/B
两份 release 制品来自固定 bc08f457 归档,差异为上面的实现补丁。
每格 3 次预热、30 次测量,共 150 个任务、1,050 个工具测量,全部
通过原有输出、Run Bundle、隔离类型、lower 无写入和 upper 256 文件检查。
每任务新的 workspace/upper,七项按原顺序执行,五格按固定种子随机交替;
仍为 256×64 KiB 写入、64 MiB 校验、2,048 文件和原 cargo/npm fixture。
热宿主缓存、两个物理核 0,1、VM 2 vCPU/16 GiB,firmware 摘要与 P0 一致。
同源两边 staged 都是 rootless_process,同时验证读/写/non-bypassable
边界;P0 文档的 staged 为 host_process,历史对照另列。亲和性不是独占;
宿主 1 分钟 load 2.02 → 2.70。以下单位为 ms,负值表示耗时下降。
| 负载 | 原生 | staged 前→后 | 变化 | VM 前→后 | 变化 |
|---|---|---|---|---|---|
| metadata | 4.88 | 77.96 → 78.14 | +0.2% | 188.38 → 194.35 | +3.2% |
| read | 32.62 | 69.39 → 68.94 | -0.7% | 154.14 → 156.15 | +1.3% |
| write | 3.89 | 202.64 → 202.92 | +0.1% | 252.50 → 254.62 | +0.8% |
| git | 15.13 | 172.44 → 173.35 | +0.5% | 493.02 → 433.31 | -12.1% |
| rg | 7.76 | 90.78 → 91.63 | +0.9% | 457.09 → 452.03 | -1.1% |
| cargo | 55.25 | 116.54 → 114.56 | -1.7% | 734.07 → 719.18 | -2.0% |
| npm | 175.58 | 267.20 → 263.22 | -1.5% | 1631.39 → 1625.45 | -0.4% |
| 启动到退出 | 468.52 | 1345.29 → 1310.05 | -2.6% | 5298.80 → 5273.93 | -0.5% |
完整结果没有证明普遍加速。staged 整轮 -2.6%,VM 整轮 -0.5%; VM Git 本批 -12.1%,metadata 反而 +3.2%。不能把微基准的 -9.6% 写成 VM 遍历收益,也不能用 Git 一项代表 npm、写入或整个任务。
| 负载 | staged 前→后 P95 | VM 前→后 P95 | staged 候选 P99 | VM 候选 P99 |
|---|---|---|---|---|
| metadata | 84.63 → 88.98 | 254.15 → 270.13 | 97.68 | 296.52 |
| read | 85.22 → 85.02 | 197.53 → 201.65 | 86.04 | 214.19 |
| write | 222.86 → 222.09 | 330.15 → 295.80 | 228.31 | 335.81 |
| git | 206.08 → 197.27 | 814.82 → 776.87 | 226.71 | 796.34 |
| rg | 96.04 → 98.05 | 478.63 → 531.83 | 101.09 | 660.30 |
| cargo | 147.37 → 144.05 | 812.44 → 831.76 | 150.25 | 846.64 |
| npm | 297.90 → 294.31 | 1909.17 → 1947.07 | 306.96 | 2093.77 |
| 启动到退出 | 5633.02 → 3808.26 | 5812.36 → 5766.30 | 5321.95 | 6031.76 |
P95/P99 没有同步改善:候选 VM rg P99 从 526 → 660 ms,npm 从 2001 → 2094 ms,整轮 5917 → 6032 ms;write 的尾部则下降。 staged 完成尾部包含少数较慢任务,且不等于七项 worker 时间之和。 原始分布全部保留,这仍是非独占宿主上的一次完整批次。
与同批 native 比,候选 VM 遍历约 39.8 倍、256 文件写入 65.4 倍、 64 MiB 读取 4.8 倍、npm 9.3 倍。当前主要成本仍是反复目录/属性 操作、小文件写入和 VM 内工具执行,而不是已经被本轮消除。
已发布 P0 制品在同批重测
再将文档发布的固定 P0 候选(a1020d4b + 相同 stdio readiness 修复)与
最终 P1 候选对比:仍是每格 3 次预热、30 次测量,额外 150 个任务、
1,050 个工具测量,全部通过相同检查。沿用原 fixture、firmware 和两核
预算,负载 0.45 → 3.44。单位 ms;这是同批制品对照,两个源码基线
不同,不能把所有差异归因于 statx 或 OPEN。本轮 P0 staged 实际为
host_process,P1 为 rootless_process,两种边界各自严格验证。
| 负载 | P0 → P1 staged P50 | 变化 | P0 → P1 VM P50 | 变化 |
|---|---|---|---|---|
| metadata | 76.26 → 77.26 | +1.3% | 225.02 → 228.47 | +1.5% |
| read | 68.11 → 68.69 | +0.9% | 121.06 → 120.93 | -0.1% |
| write | 198.12 → 200.20 | +1.0% | 240.25 → 253.10 | +5.3% |
| git | 167.50 → 170.04 | +1.5% | 449.65 → 430.24 | -4.3% |
| rg | 89.01 → 89.85 | +0.9% | 465.98 → 460.27 | -1.2% |
| cargo | 111.08 → 111.62 | +0.5% | 654.27 → 625.52 | -4.4% |
| npm | 215.91 → 261.39 | +21.1% | 1662.16 → 1666.95 | +0.3% |
| 启动到退出 | 1224.50 → 1290.69 | +5.4% | 5164.78 → 5187.46 | +0.4% |
第二批 VM 整轮 +0.4%,也未复现整体加速;Git 本批 -4.3%、写入 +5.3%。staged npm +21.1%,在同源 rootless 两边的上一批仅 -1.5%; 这里包含执行边界和其他源码变化,不作本轮文件系统补丁的因果结论。 同一 P1 制品在两批 VM 遍历为 194 / 228 ms、读取 156 / 121 ms, 展示了批次条件对分布的影响,不能择取较快一批或合并百分位数。
文档原 P0 批次的 VM 遍历 195.24 ms 继续保留;本批同一个 P0 制品为 225.02 ms。因此历史发布数到本轮数的差异,也不能直接当作代码收益。 两轮完整评测合计 300 个任务、2,100 个工具测量。当前证据支持减少 重复父目录查询、修复只读 OPEN 的串行约束,尚不支持普遍端到端加速。
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/full-historical.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/historical-summary.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/samples.csv
缓存、并发和 guest-local 对照
独立诊断使用相同 2,048 文件 fixture 重跑遍历,所有“过期后”样本在初始
rglob 之后也等待 1.2 秒。候选 VM 结果如下,单位 ms;tmpfs 已核实为
同一 guest 的 /dev/shm,准备文件不计时。
| 对照 | 每组测量次数 | P50 |
|---|---|---|
| 缓存过期后遍历 → 立即重复遍历 | 3 | 233.11 → 105.11 |
| 单线程 → 四线程分片 stat | 3 | 164.17 → 91.86 |
| 同一 guest tmpfs 上遍历 | 3 | 3.28 |
| 64 文件各八次 1 KiB 写入加读回校验:共享视图 → guest tmpfs | 1 | 69.64 → 2.78 |
立即重复遍历显示缓存有帮助,但仍有明显累计成本;并发提交降低等待, 不能证明 Core 并行执行。部分写入对照只有一次,不作验收收益。Tmpfs 同时排除 virtio-fs、Core、journal 和存储延迟,不能将差额全归因于传输。
另开 profile 批次,不计入验收时间。候选 VM 两个设备的最后检查点为 21,340 / 24,743 inline、357 / 65 pool;pool 排队累计 12.80 / 1.67 ms,完成后等待 used-ring 发布 5.16 / 1.22 ms。 读锁加写锁的获取等待分别累计约 1.09 / 2.55 ms,最大单次小于 0.38 ms。这次诊断没有显示长锁等待,但不测 guest 发出请求到宿主接收 之前的等待,也不能排除 inline 串行服务限制。两个 Core 检查点仍有 121,768 / 169,649 次父目录观察,合并 statx 63,375 / 65,488 次, 没有 fallback 记录。staged 完整 profile 的 341 次 journal fsync 约 119 ms。VM 检查点非 final、不同实例未必同一截止时刻;inclusive span 不相加,这些计数不是完整 syscall census。
初次诊断因只在 runs 下找 Run Bundle 而停止,实际 bundle 在 stage;修正 位置后保留失败批次另开新目录。中间批次的初次遍历尚未等待缓存过期,也 单独保存,最终诊断不混入这批时间。正常写入都在 upper、lower 未写。
后续内核路径优先级
- 目录/属性/负查找缓存与失效通知。 重复遍历仍贵,先为不可变依赖或 单方拥有的树建立缓存契约,再验证 TTL 与 FOPEN_CACHE_DIR。live lower 允许宿主外部修改,现有通道没有主动失效通知,不全局延长缓存。
- 按负载选择 READDIRPLUS 和宿主并发。 AUTO 已存在;强制 PLUS 有取舍。 宿主 fuser 的单个请求循环同步执行回调;VM 只有一个普通队列和一个 hiprio 队列,短 metadata inline,线程池满时暂停普通队列接收。 更换线程池或增加 worker 不自动带来收益,需要测队列和锁等待。 ASYNC_READ/PARALLEL_DIROPS 已由协议层默认协商。
- writeback cache。 可能合并小写入,但必须保证首次修改前 preimage 持久化、终结/导出/快照前排空脏页,以及 partial write、append/truncate 的正确性。内核 I/O 说明
- 数据面与本地文件系统。 DAX 主要减少内容拷贝;本轮没有启用或取得
DAX A/B。FUSE-over-io-uring 适用宿主
/dev/fuse,不是直接替换 VM virtqueue;FUSE passthrough 需要同一内核的 backing FD,也不能直接把 宿主 FD 交给 guest。guest-local tmpfs、只读块镜像/内核文件系统可作为 下一阶段独立方案,但需要保留 staging/记录/恢复契约。 DAX · io-uring · passthrough
验证:Core 97 项(5 跳过)、overlayfs 12 项、VM 294 项(2 跳过)、 基准 25 项通过;三个相关包的 all-targets Clippy 和基准 Ruff 通过。 没有修改或批准 semspec ledger/snapshot。完整样本和失败,不只成功摘要, 保存在下列证据中;macOS、启动、网络和完整 Agent 闭环不由这些数字推算。
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/full-same-source.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/summary.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/process.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/micro-final.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/kernel-probe.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/profiles.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/implementation.patch ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/evidence.tar.gz ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-kernel-20261005/manifest.tsv
Linux:2026-10-05,P0 真实 VM/FUSE A/B 基线
这次启动真实 KVM VM,并挂载真实宿主 FUSE,补齐上轮适配层微基准的
端到端验证。宿主设备可用,最初沙箱没有暴露 /dev/kvm 和 /dev/fuse。
两份 GNU/Linux release 制品来自同一份 a1020d4b 源码归档,只有
OverlayCore 的 core.rs 不同;二者都加入相同的 guest stdio 端口就绪修复。
可执行文件、firmware、源码补丁和当轮脚本均保存摘要。
“优化后”指该固定候选制品,衡量最近一次跳过不可用 upper 标记探测的 增量收益。归档中已有的其他优化同时存在于两份制品,不属于这次 A/B 的 差异;后续提交也没有自动进入这些测量。
每轮随机交替 native、优化前/后的 FUSE staged 与优化前/后的 VM,共五格;
每格 3 次预热、30 次测量。共 150 个测量任务、1,050 个工具测量,所有
正确性检查通过。每个任务使用新的 workspace/upper,在同一个环境中按顺序
执行七种负载;输入复制不计时。宿主缓存为热缓存,CPU 亲和性固定在两个
物理核 0,1,VM 为 2 vCPU、16 GiB。保留的历史工具环境 fixture 写入
256×64 KiB,共 16 MiB,与 product-v1 写入字节数相同;不同配置不合并
历史百分位数。宿主有并行任务,1 分钟 load average 从 10.38 降至 3.06;
固定亲和性是共同预算,不是独占 CPU。以下是单批筛查数据。
下表是工具内部操作与校验的 P50,单位 ms;负百分比表示耗时下降。
| 负载 | Native | FUSE 前→后 | 变化 | VM 前→后 | 变化 |
|---|---|---|---|---|---|
| metadata | 4.93 | 92.38 → 78.25 | -15.3% | 224.36 → 195.24 | -13.0% |
| read | 32.56 | 68.30 → 67.82 | -0.7% | 116.98 → 117.90 | +0.8% |
| write | 3.90 | 201.36 → 198.92 | -1.2% | 243.10 → 257.16 | +5.8% |
| git | 15.11 | 190.36 → 170.46 | -10.5% | 484.14 → 494.86 | +2.2% |
| rg | 7.66 | 100.80 → 90.58 | -10.1% | 476.92 → 464.97 | -2.5% |
| cargo | 52.92 | 112.30 → 110.11 | -1.9% | 513.46 → 512.74 | -0.1% |
| npm | 173.19 | 221.67 → 217.47 | -1.9% | 1570.05 → 1503.67 | -4.2% |
七项负载合计的启动到退出 P50:native 454.50 ms,FUSE staged 1288.69 → 1230.93 ms(-4.5%),VM 4829.04 → 4777.55 ms(-1.1%)。 元数据收益已在真实路径复现,但不能宣称 VM 的 git、写入或整体任务都有 改善;VM write 和 git 本批反而变慢。小幅变化与写入变化需要在较空闲宿主 上复测,不能仅由一个 P50 判定收益或回归原因。
P95 与剩余成本
同一批样本的 P95,单位 ms。较低中位数没有普遍转化成较低尾延迟:
| 负载 | FUSE 前→后 P95 | 变化 | VM 前→后 P95 | 变化 |
|---|---|---|---|---|
| metadata | 112.02 → 107.34 | -4.2% | 344.81 → 322.87 | -6.4% |
| write | 312.85 → 300.82 | -3.8% | 349.50 → 780.11 | +123.2% |
| git | 294.83 → 378.19 | +28.3% | 892.72 → 1181.58 | +32.4% |
| rg | 153.51 → 172.53 | +12.4% | 604.35 → 850.17 | +40.7% |
| 整轮启动到退出 | 2078.80 → 2152.45 | +3.5% | 6796.10 → 8565.53 | +26.0% |
候选 staged / VM 的整轮 P99 为 13.36 s / 10.46 s,也保留在原始汇总中。 N=30 的尾部受少量慢样本影响,宿主并行负载也未排除;这些是需要复测的 现象,尚不能归因于某项实现修改。当前证据支持元数据路径改善,整体性能 验收仍需较空闲宿主上的重复批次。
与同批 native 比,候选 staged / VM 的 metadata 仍为 15.9 / 39.6 倍; 遍历一次分别多 73 / 190 ms。写入 256 个文件仍需 199 / 257 ms, native 为 3.90 ms;VM 离线 npm 为 1.50 s,native 为 0.17 s。 后续优化应继续针对反复遍历、小文件写入和 VM 工具执行成本。
一次先行预热曾出现 VM 退出码为 0、任务写入完成,但 stdout 没有任何 工作负载标记。基准立即停止,失败报告保留。普通 VM runner 现在声明实际 非终端 stdio 所需的 named ports;guest 在启动工具前等待名称就绪,最多 5 秒,缺失则失败。新增测试覆盖迟到的端口名、稍后新增的端口和缺失端口, 不加入固定启动等待。正式批次的 68 个 VM 运行(含预检与预热)都通过输出 检查。基准还验证实际隔离类型、lower 没有写入、upper 含完整 256 个文件; 制品摘要相同、清单不符、缺样本或中断都不能成为成功的 A/B 汇总。
另开的一次 profiling 不计入上表。候选 VM 两个非空 Core 实例的最后累计 检查点仍分别有 126,034 / 168,027 次物理父目录 metadata 调用、 57,547 / 53,161 次 mount identity 查询尝试。两个 dispatch 检查点为 20,545 inline / 424 pool 和 24,398 inline / 100 pool,各有 2 个 worker。宿主候选的完整 Core profile 有 341 次 journal fsync,累计约 110 ms。Core 的重复物理路径检查、首次观察/写入的 journal 成本,以及 小请求仍走 inline 的调度路径应优先分别验证;单纯增加 worker 或更换 virtiofsd 不能据此认定会消除这些开销。VM profile 缺少 final record,计数 只覆盖检查点之前的工作;嵌套 inclusive span 不相加,admission 不等于排队 等待时间。
验证:guest 5 项、VM 全包 292 项(2 项跳过)、不含 control 的 executor 24 项和基准 24 项测试通过,guest Clippy 与基准 Ruff 通过。当时工作区 较宽 executor 子集另有 9 项 VM control 测试失败,保留在验证归档中,本次 没有修改 control 实现,也不将这些检查算作通过。
从同一源码构建两份 GNU/Linux 制品,仅在两次构建之间应用待测修改;
输出目录必须是新目录。先以 --samples 1 --warmups 0 预检。
python3 benchmark/pvisor/filesystem_ab.py \
  --assets target/reference-env-final-20261004 \
  --baseline /absolute/path/to/pvisor-before \
  --candidate /absolute/path/to/pvisor-after \
  --firmware /absolute/path/to/libkrunfw-directory \
  --output target/filesystem-ab-new \
  --cpu-affinity 0,1 --samples 30 --warmups 3
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-ab-20261005/samples.csv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-ab-20261005/summary.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-ab-20261005/profiles.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-ab-20261005/evidence.tar.gz
历史到 P0 的实测变化(保留)
以下比较 2026-10-04 完整工具环境 N=30 批次与最新候选 N=30 批次,工具 内部 P50,单位 ms。二者沿用保留的工具 fixture,但制品、宿主负载和运行 协议有变化;百分比是跨批次观测差异,不能当作全部优化的受控因果收益。 最近一次修改的增量收益以同批 A/B为准。
| 负载 | 历史→最新 staged | 跨批次差异 | 历史→最新 VM | 跨批次差异 |
|---|---|---|---|---|
| metadata | 180.13 → 78.25 | -56.6% | 310.54 → 195.24 | -37.1% |
| read | 48.77 → 67.82 | +39.1% | 89.27 → 117.90 | +32.1% |
| write | 189.28 → 198.92 | +5.1% | 144.66 → 257.16 | +77.8% |
| git | 177.81 → 170.46 | -4.1% | 456.21 → 494.86 | +8.5% |
| rg | 144.61 → 90.58 | -37.4% | 545.82 → 464.97 | -14.8% |
| cargo | 112.80 → 110.11 | -2.4% | 549.57 → 512.74 | -6.7% |
| npm | 222.97 → 217.47 | -2.5% | 1727.04 → 1503.67 | -12.9% |
从已有实测看,遍历与搜索耗时下降,读取与写入没有同步改善。此次没有 重新测量 Docker、完整修复任务或真实 Agent CLI 闭环;下面的历史数据保持 原日期与制品,不能用这组文件系统百分比推算它们的最新性能。
本地原始记录 docs/src/assets/benchmarks/.data/reference-env-20261004/summary.tsv ·
本地原始记录 docs/src/assets/benchmarks/.data/filesystem-ab-20261005/summary.tsv
Linux:2026-10-05,OverlayCore 路径解析优化
本次只测 release 模式的 virtio-fs OverlayFs 适配层,不启动 VM、不挂载
宿主 FUSE,也不记录 preimage journal。输入位于 /tmp tmpfs:32 个目录、
每目录 64 个 18 B 文件;深目录案例的父目录深度为 8。每轮使用新的 inode
表,宿主缓存为热缓存,创建输入和适配器不计时。
保存优化前后的测试可执行制品,用 nextest 的 binaries metadata 交替运行 三个批次,顺序为旧→新、新→旧、旧→新。每格每批次 2 次预热、8 次无 profiling 测量,另有 1 次诊断;表中 P50 只来自每版本的 24 次无 profiling 样本。CPU 未固定亲和性,二进制摘要和各批次中位数保存在原始汇总中。
| 适配层操作,2,048 文件 | 优化前 P50 ms | 优化后 P50 ms | 耗时下降 |
|---|---|---|---|
| lookup + getattr | 35.15 | 26.35 | 25.0% |
| lookup + open + getattr + release | 37.61 | 28.07 | 25.4% |
| 深目录 lookup + open + getattr + release | 170.51 | 96.85 | 43.2% |
| opendir + readdirplus + releasedir | 29.00 | 20.24 | 30.2% |
修改位于共享 OverlayCore:候选 upper 的物理父目录刚被检查为不存在或 非目录时,直接跳过该候选的 whiteout/opaque 标记探测。没有跨请求缓存 属性或不存在结果,后续路径组件和最终物理祖先仍重新检查。深目录诊断中, whiteout 与 opaque 探测各从 38,016 次降至 4,352 次。标记不会通过 upper 祖先符号链接影响 lower 可见性;新增测试还验证同一遍历中新出现的 upper 目录与 whiteout,以及请求之间的 upper 内容变化。
Core/host 适配层 106 项测试和 virtio-fs/descriptor/文件系统快照 57 项
测试通过,三个相关包的 Clippy 全 targets 检查通过。最初沙箱未暴露 /dev/kvm
和 /dev/fuse,当时 VM 全包测试在 KVM 初始化处失败;该微基准没有测
真实 VM/FUSE、journal/文件内容读写和 macOS。后续宿主设备验证与端到端
复测见本页 P0 基线。两个制品之间
工作区另有 VM 重构,适配层案例不执行 UART/VMM/CPU 初始化;制品摘要
是本次测量身份依据。以上降幅不能替代下方历史工具工作负载的重新测量。
复现单版本适配层测量:
cargo nextest run --locked --release -p pvisor-vm \
  --run-ignored only --no-capture -E 'test(small_file_adapter_benchmark)'
本地原始记录 docs/src/assets/benchmarks/.data/overlay-resolution-20261005/samples.tsv · 本地原始记录 docs/src/assets/benchmarks/.data/overlay-resolution-20261005/summary.tsv
Linux:2026-10-04
完整 Ubuntu 的工具内部对照
下表排除新环境开机,只计操作与结果校验。新批次每格 N=10、3 次预热;相同 fixture、两核预算、VM 16 GiB。pVisor 使用宿主目录和 staged virtio-fs,Ubuntu 使用官方 generic 内核、发行版工具和私有 ext4。旧 Docker N=30 矩阵继续保留,不合并百分位数。
| Workload | Native P50/P95 ms | pVisor staged P50/P95 ms | pVisor VM P50/P95 ms | Ubuntu P50/P95 ms |
|---|---|---|---|---|
| metadata | 4.85 / 5.11 | 177.80 / 195.52 | 291.82 / 359.75 | 18.64 / 19.90 |
| read | 33.29 / 48.97 | 48.12 / 61.21 | 88.83 / 127.21 | 115.51 / 117.69 |
| write | 3.75 / 4.43 | 186.95 / 208.86 | 134.37 / 154.03 | 36.07 / 36.35 |
| git | 14.66 / 17.07 | 172.18 / 194.52 | 613.69 / 807.73 | 136.50 / 140.81 |
| rg | 7.58 / 10.90 | 140.52 / 145.52 | 521.65 / 554.49 | 20.40 / 22.89 |
| cargo | 52.79 / 57.17 | 104.21 / 131.18 | 563.24 / 658.37 | 969.09 / 977.41 |
| npm | 218.82 / 245.85 | 256.29 / 292.67 | 2260.17 / 2408.63 | 1079.89 / 1110.93 |
可以据此定位遍历、搜索、编译和安装的实际等待;不能由某一个读取数字得出 block device 总是比 FUSE 快。数据同时改变了内核、工具版本、文件系统和暂存语义。长任务选型更应结合 worker 与完整闭环,而不是只比较开机时间。
本地原始记录 docs/src/assets/benchmarks/.data/full-ubuntu-20261004/samples.csv · 本地原始记录 docs/src/assets/benchmarks/.data/full-ubuntu-20261004/summary.tsv · 方法与复现
完整工具环境的 Docker 基线
新增同机 Docker Engine 实测,不再借用 Podman 数字。相同两核预算与输入、每格 30 次、3 次预热;fixture 与首版相同,七种操作在一个新环境中依次执行。表中只计操作和校验,不含环境启动;整体修复任务另见完整环境。两个批次分别保留,不合并百分位数。
| Workload | Native P50/P95 ms | Docker P50/P95 ms | pVisor staged P50/P95 ms | pVisor VM P50/P95 ms |
|---|---|---|---|---|
| metadata | 5.04 / 6.78 | 5.06 / 7.50 | 180.13 / 202.88 | 310.54 / 351.59 |
| read | 33.07 / 41.44 | 33.24 / 45.06 | 48.77 / 61.60 | 89.27 / 99.34 |
| write | 3.96 / 5.09 | 3.95 / 5.65 | 189.28 / 204.67 | 144.66 / 164.67 |
| git | 15.75 / 20.50 | 16.07 / 20.07 | 177.81 / 195.97 | 456.21 / 786.35 |
| rg | 7.98 / 11.81 | 8.03 / 9.63 | 144.61 / 159.00 | 545.82 / 673.25 |
| cargo | 58.71 / 70.16 | 56.40 / 73.75 | 112.80 / 140.81 | 549.57 / 659.23 |
| npm | 183.46 / 197.57 | 231.45 / 288.60 | 222.97 / 256.33 | 1727.04 / 1978.79 |
这些数字给出具体位置:Docker 的 metadata/read/write 接近原生;staged 遍历小文件比 Docker 多约 175 ms,64 MiB 读取多约 16 ms。读取一次只多十几毫秒,反复遍历小文件会累积明显成本。VM 的离线 npm 安装约 1.73 秒,Docker 约 0.23 秒,这条路径仍有明显差距。不能用约 86 ms 的 VM 启动时间替代这个工具预算。
任务核对文件数量/大小、SHA256、Git clean、搜索命中、编译结果与安装包数量。Docker 是 writable bind mount,pVisor 使用 staged 视图;Firecracker/QEMU 在私有 ext4 内执行。文件路径不同是实际部署成本的一部分;这不是相同文件系统只替换 VMM 的因果实验。其他运行时的各操作分布也在本轮汇总中。
配置与复现 · 本地原始记录 docs/src/assets/benchmarks/.data/reference-env-20261004/samples.csv · 本地原始记录 docs/src/assets/benchmarks/.data/reference-env-20261004/summary.tsv · 本地原始记录 docs/src/assets/benchmarks/.data/reference-env-20261004/evidence.tar.gz · 本地原始记录 docs/src/assets/benchmarks/.data/reference-env-20261004/compatibility.tsv
首版 Linux 矩阵:独立批次
| Workload | Backend | N | Worker P50 ms | vs native | Wall P50 / P95 / P99 ms |
|---|---|---|---|---|---|
| metadata | native | 30 | 4.84 | +0.0% | 23.44 / 29.17 / 30.71 |
| metadata | host | 30 | 4.94 | +2.0% | 34.02 / 44.90 / 58.18 |
| metadata | staged | 30 | 149.60 | +2988.5% | 225.03 / 295.08 / 314.55 |
| metadata | safe | 30 | 171.26 | +3435.6% | 288.73 / 346.47 / 363.59 |
| metadata | vm | 30 | 263.08 | +5331.3% | 636.44 / 828.38 / 892.94 |
| metadata | podman | 30 | 4.95 | +2.1% | 138.99 / 158.58 / 159.34 |
| metadata | container | 30 | 4.83 | -0.3% | 320.21 / 419.26 / 479.51 |
| read | native | 30 | 32.66 | +0.0% | 52.81 / 125.98 / 143.36 |
| read | host | 30 | 31.80 | -2.6% | 64.65 / 213.37 / 232.88 |
| read | staged | 30 | 40.76 | +24.8% | 95.24 / 338.92 / 378.04 |
| read | safe | 30 | 41.38 | +26.7% | 153.98 / 386.69 / 390.96 |
| read | vm | 30 | 100.58 | +208.0% | 476.56 / 1379.77 / 1436.40 |
| read | podman | 30 | 32.68 | +0.1% | 170.64 / 408.95 / 452.05 |
| read | container | 30 | 33.57 | +2.8% | 405.55 / 945.63 / 1092.93 |
| write | native | 30 | 3.81 | +0.0% | 22.95 / 26.54 / 55.29 |
| write | host | 30 | 3.81 | -0.1% | 34.16 / 46.23 / 93.69 |
| write | staged | 30 | 192.46 | +4945.6% | 252.61 / 444.20 / 812.30 |
| write | safe | 30 | 199.56 | +5131.6% | 312.83 / 549.31 / 762.48 |
| write | vm | 30 | 114.68 | +2906.4% | 476.94 / 694.88 / 1003.73 |
| write | podman | 30 | 3.76 | -1.4% | 139.68 / 151.53 / 340.87 |
| write | container | 30 | 3.82 | +0.1% | 356.89 / 406.97 / 627.19 |
| git | native | 30 | 14.72 | +0.0% | 36.14 / 79.21 / 165.50 |
| git | host | 30 | 14.51 | -1.4% | 54.34 / 65.11 / 92.63 |
| git | staged | 30 | 203.33 | +1281.7% | 333.16 / 458.84 / 1316.66 |
| git | safe | 30 | 225.99 | +1435.7% | 394.38 / 491.36 / 960.78 |
| git | vm | 30 | 535.06 | +3536.0% | 929.22 / 1558.97 / 2447.31 |
| git | podman | 30 | 15.55 | +5.7% | 158.87 / 209.35 / 215.16 |
| git | container | 30 | 15.78 | +7.2% | 375.18 / 434.76 / 490.77 |
| rg | native | 30 | 6.72 | +0.0% | 26.54 / 28.70 / 29.90 |
| rg | host | 30 | 6.64 | -1.2% | 44.01 / 44.79 / 45.02 |
| rg | staged | 30 | 167.90 | +2399.9% | 288.07 / 312.76 / 320.23 |
| rg | safe | 30 | 190.82 | +2741.2% | 349.80 / 380.69 / 389.61 |
| rg | vm | 30 | 340.98 | +4976.9% | 717.00 / 769.33 / 780.18 |
| rg | podman | 30 | 5.90 | -12.2% | 141.36 / 154.73 / 160.82 |
| rg | container | 30 | 6.39 | -4.8% | 355.33 / 390.96 / 395.69 |
| cargo | native | 30 | 49.09 | +0.0% | 67.21 / 84.93 / 86.36 |
| cargo | host | 30 | 47.07 | -4.1% | 83.86 / 94.88 / 95.49 |
| cargo | staged | 30 | 90.31 | +84.0% | 146.28 / 167.31 / 168.42 |
| cargo | safe | 30 | 96.00 | +95.6% | 188.83 / 209.83 / 224.90 |
| cargo | vm | 30 | 541.56 | +1003.1% | 897.61 / 959.14 / 959.43 |
| npm | native | 30 | 157.56 | +0.0% | 175.60 / 205.84 / 434.16 |
| npm | host | 30 | 156.38 | -0.7% | 184.73 / 204.95 / 552.20 |
| npm | staged | 30 | 187.87 | +19.2% | 235.76 / 256.13 / 608.48 |
| npm | safe | 30 | 232.30 | +47.4% | 318.58 / 432.25 / 708.12 |
| npm | podman | 30 | 208.41 | +32.3% | 339.64 / 474.65 / 857.37 |
| npm | container | 30 | 195.29 | +23.9% | 515.88 / 552.03 / 891.62 |
分析
暂存视图的连续读取约 +25%,离线 npm 约 +19%;元数据约 31 倍、写小文件约 50 倍。倍率很大,也要同时看原生只有几毫秒和增加约 150–190 ms 的绝对值。host 几乎没有 worker 开销,总时长仍增加 CLI 与记录成本。safe 再增加命名空间、限制和代理准备;VM 多数整项任务在约 0.5–1 秒量级。
该历史批次的 OCI 对照使用 Podman,当时 Docker daemon 不可访问;后续已补充 rootless Docker Engine 的 bind-mount 数据,见上方完整环境对照。Docker overlay2 和 Docker Desktop 仍未测量。pVisor OCI 每个 Job 准备私有 rootfs,wall 反映这个成本;worker 单独显示工具执行成本。
工具兼容性补测
主批次容器 cargo 缺少链接启动文件,是镜像准备错误;补齐 glibc/GCC 文件后发现 Fedora 链接脚本还要求 /lib64/libmvec.so.1;最终补全该路径的 cargo-ready 批次全部通过,单独呈现,前两次镜像错误保留在报告。VM 的 1 GiB 配置会使 Node V8 地址空间预留失败;补测使用 16 GiB 地址空间配置,与 1 GiB 主批次分别列出。
| Workload | Backend | N | Worker P50 / P95 / P99 ms | Wall P50 / P95 / P99 ms |
|---|---|---|---|---|
| cargo | native | 30 | 52.90 / 65.79 / 76.17 | 71.96 / 89.41 / 103.04 |
| cargo | host | 30 | 52.60 / 70.49 / 75.30 | 84.38 / 111.79 / 124.56 |
| cargo | staged | 30 | 116.07 / 139.93 / 233.90 | 166.65 / 210.57 / 397.55 |
| cargo | safe | 30 | 119.77 / 138.77 / 228.23 | 209.92 / 242.16 / 342.22 |
| cargo | vm | 30 | 567.42 / 1365.43 / 2047.17 | 1271.15 / 2683.43 / 3889.27 |
| npm | native | 30 | 162.86 / 433.44 / 488.04 | 181.47 / 472.60 / 531.93 |
| npm | host | 30 | 163.56 / 430.53 / 475.14 | 205.34 / 522.04 / 595.23 |
| npm | staged | 30 | 213.17 / 437.03 / 612.15 | 266.48 / 544.87 / 780.57 |
| npm | safe | 30 | 256.70 / 717.56 / 777.67 | 339.63 / 983.34 / 1085.49 |
| npm | vm | 30 | 985.29 / 3238.12 / 4617.06 | 1661.91 / 5172.18 / 5755.11 |
| npm | podman | 30 | 217.06 / 547.44 / 833.45 | 365.17 / 883.42 / 1239.59 |
| npm | container | 30 | 202.48 / 587.65 / 601.74 | 550.89 / 1368.06 / 1469.75 |
| Cargo corrected /lib64 image | N | Worker P50/P95/P99 ms | Wall P50/P95/P99 ms |
|---|---|---|---|
| native | 30 | 51.52 / 59.70 / 62.44 | 70.85 / 80.25 / 82.02 |
| podman | 30 | 49.29 / 54.35 / 55.75 | 181.18 / 187.71 / 189.70 |
| container | 30 | 51.99 / 57.94 / 59.96 | 405.08 / 425.10 / 425.46 |
边界与下一轮
VM 主批次使用 host rootfs / 和 2 vCPU/1 GiB,并提供宿主只读视图;这是工具兼容性配置,不能据此宣称宿主敏感文件不可读。隔离配置另见隔离验证。这些小型、热缓存、离线任务不是完整大仓库构建,也不是冷磁盘吞吐。Linux FUSE 已测,macFUSE/FSKit、真实 registry 安装与 Docker/overlay2 留给后续同协议测量。
复现与证据
从仓库根目录运行;输出目录必须是新目录。动态 firmware 入口需要 GNU/Linux 版 CLI;静态 musl 制品使用另一套 firmware 入口,不能混用。Linux、KVM/FUSE/user namespaces、Python 3.14、Rust/GCC、Git/rg、Node 24/npm、Podman/crun 是本机工具环境;Agent 套件另需 Claude/Codex CLI。
python3 benchmark/pvisor/product_v1.py \
  --binary /absolute/path/to/gnu-linux/pvisor \
  --firmware /absolute/path/to/libkrunfw-directory \
  --replay-binary /absolute/path/to/pvisor-replay \
  --output target/product-benchmark-new \
  --suites filesystem --samples 30 --warmups 3
先用 --samples 1 --warmups 0 检查环境。脚本、输入定义和正确性断言在 benchmark/pvisor/v1/;报告会复制二进制、firmware 和当轮脚本并记录摘要。失败不会进入性能分布;准备、策略拒绝和工作负载错误分别保留。每个页面写明有效样本数;小样本 P95/P99 只描述本批次,不估计长期尾延迟。
环境、制品与采样方法 · 本地原始记录 docs/src/assets/benchmarks/.data/product-v1-20261004/manifest.tsv · 本地原始记录 docs/src/assets/benchmarks/.data/product-v1-20261004/samples.csv · 本地原始记录 docs/src/assets/benchmarks/.data/product-v1-20261004/evidence.tar.gz。报告保留源码的未提交状态;当轮可执行制品 SHA256 是身份依据。归档不含数 GB 的 rootfs、二进制和可重建工作区;输入摘要及每轮脚本保留。